
Deje de tratar al agente Eval como una tabla de clasificación
finalmente surge la misma pregunta: ¿qué versión debería enviar?
Cambias de modelo. Reescribes el mensaje. Cambias una herramienta de recuperación. Ejecutas un lote. La puntuación media se mueve un poco. Quizás una versión gane por dos puntos. Quizás el juez prefiera una salida el lunes y otra el martes. Entonces envías el "mejor" promedio.
Éste suele ser el marco de decisión equivocado. El rendimiento del agente rara vez se reduce a un mejor modelo + mejor aviso + mejor herramienta. La pregunta útil es cómo se comportan esas piezas juntas. Un mensaje que ayuda a un modelo más pequeño puede ralentizar uno más fuerte. Una herramienta de búsqueda semántica puede combinarse maravillosamente con un mensaje abierto y mal con un mensaje rígido paso a paso.
Este artículo muestra una forma pequeña y práctica de probarlo. Elija algunas palancas de agentes. Ejecute configuraciones competitivas en los mismos ejemplos. Pídale a un juez que elija solo los mejores y peores resultados. Luego ajuste un modelo de clasificación que convierta esas elecciones en puntuaciones de utilidad para cada configuración y cada interacción.
La opinión: si solo puntúas cada respuesta de forma aislada, clasificas los promedios y tomas la configuración superior, estás dejando una señal sobre la mesa. La comparación directa es la razón por la que los conjuntos dorados son valiosos en primer lugar. La comparación mejor-peor obliga a juzgar dónde la variación realmente importa.
Puedes utilizar el método en profundidad, con un modelo de Plackett-Luce y términos de interacción factorial. O, si está creando primero el agente, puede entregar la misma estructura a un agente de evaluación y dejar que ejecute el ciclo. El modelo no es el punto en sí mismo. El punto es evidencia más clara para la próxima decisión de ingeniería.
Todas las imágenes del artículo fueron generadas por el autor utilizando ChatGPT y Claude.
Para constructores que priorizan al agente
No es necesario ejecutar esto a mano.
Si su flujo de trabajo normal es darle a un agente un objetivo, un conjunto de pruebas, resultados esperados, algunos modelos para elegir y un agente juez para revisar los resultados, este método aún se aplica. Simplemente le da al agente un mejor protocolo de evaluación.
Indicación para intentar:
Cree una pequeña cuadrícula factorial de configuraciones de agentes candidatos. Para cada ejemplo de prueba, pruebe varias configuraciones y ejecútelas de forma independiente. Anonimizar las salidas. Pídale a un juez que seleccione exactamente una mejor y una peor respuesta. Ajuste un modelo de Plackett-Luce, un modelo MaxDiff o una clasificación de utilidad equivalente. Informe qué configuraciones deben implementarse, podarse o probarse a continuación y explique qué interacciones de modelo/mensaje/herramienta parecen importantes.
Ese es el valor práctico del desarrollo centrado en el agente. El agente puede generar candidatos, realizar comparaciones, inspeccionar resultados de servicios públicos y proponer el siguiente conjunto de configuraciones. El ser humano todavía decide lo que importa, pero el sistema obtiene mejores pruebas con cada ciclo.
Dicho esto, en algunos casos necesitarás poder analizar los detalles para crear una estructura repetible que capture completamente los matices de las decisiones de alto valor.
El experimento
La tarea. Una canalización de agentes extrae JSON estructurado de imágenes de facturas. La extracción de facturas no es glamorosa, pero es exactamente el tipo de trabajo que realmente se ejecuta en producción. El esquema es fijo, la corrección importa y los errores tienen consecuencias posteriores. Eso lo convierte en una superficie de evaluación útil: el agente obtuvo los campos correctos o no.
Utilicé el conjunto de datos shubh303/Invoice-to-Json de HuggingFace: 100 documentos de factura, 5 configuraciones de muestra por documento y 499 ejecuciones de producción totales después de excluir una ejecución no válida. De ellos, 488 lograron un cumplimiento válido del esquema.

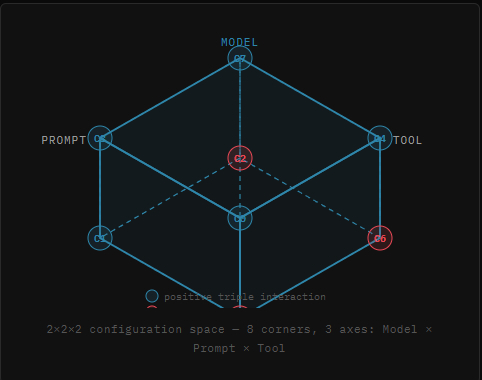
El diseño. Tres factores binarios definen el espacio de configuración, produciendo ocho canales distintos:
Los dos estilos de indicaciones representan diferentes filosofías de extracción. El Planificador Sistemático sigue reglas: le da al agente una secuencia explícita y restringe el uso de herramientas. Contextual Leaper es semántico y abierto: le pide al agente que primero comprenda el documento y luego extraiga lo que necesita con más libertad.
Ambas herramientas son resguardos deterministas. Esto importa. El experimento no prueba la calidad del OCR, la calidad de la recuperación en vivo ni la confiabilidad del análisis. Está probando cómo el agente navega por los controles de la herramienta y gestiona la ejecución del contexto cuando cambian las posibilidades de la herramienta.
El protocolo de evaluación. Para cada factura, un subconjunto aleatorio de 5 configuraciones de las 8 procesaron el documento de forma independiente. Luego, un modelo de juez (claude-sonnet-4-6) seleccionó el mejor y el peor resultado del lote anonimizado.
Esta es la escala mejor-peor, también conocida como diferencia máxima o comparación de estilo MaxDiff. El juez no necesita calificar cada respuesta en una escala artificial del 1 al 10. Sólo tiene que responder dos preguntas: ¿qué resultado es mejor en este lote y cuál es peor?
Lo que le dicen las puntuaciones promedio y lo que se pierden
Antes de recurrir a un modelo de clasificación, observe lo que mostraría un análisis estándar. Aquí están los promedios de puntuación macro para cada factor, desglosados en las 499 ejecuciones:
Las brechas son pequeñas. Un equipo que observe únicamente esta tabla podría concluir razonablemente que el modelo importa un poco, la rapidez apenas importa y la elección de la herramienta es casi un lanzamiento de moneda.
Ahora mire las mejores y peores tasas de ganancias brutas por configuración:
Esto es más útil, pero aún está incompleto. Muestra que Config 7 es fuerte. También hace que la Configuración 1 parezca una clara opción de segundo lugar y la Configuración 4 parezca menos interesante de lo que realmente es.
La pieza que falta es calidad de competición. Una configuración que gana contra lotes débiles no debería recibir el mismo crédito que una configuración que gana contra lotes fuertes. Vencer una configuración superior significa algo. Superar la configuración de descuento no significa mucho.
Es por eso que las puntuaciones aisladas y las tasas de victorias brutas son limitadas. Contienen señales útiles, pero no explican completamente a quién tenía que vencer cada configuración.
Convertir las mejores y peores elecciones en puntuaciones de servicios públicos
El modelo que utilicé para esto se llama Plackett-Luce. Es parte de una familia de modelos para comparar el mejor y el peor. El trabajo es simple: tomar una colección de mejores/peores opciones y estimar una puntuación de utilidad subyacente para cada opción.
En términos sencillos, el modelo pregunta: dadas las configuraciones que aparecieron juntas en cada lote, ¿qué configuraciones fueron las preferidas consistentemente después de tener en cuenta la solidez de las alternativas?
La extensión útil aquí es la codificación de efectos. Cada nivel de factor está codificado como +1 o −1, lo que permite al modelo estimar dos tipos de señal:
Los efectos principales estiman en qué medida un factor parece ayudar por sí solo. Los efectos de interacción estiman si una combinación funciona mejor o peor de lo que sugieren las partes individuales.
Esa distinción es el corazón del artículo. A veces puedes simplemente cambiar por un modelo mejor y obtener la mayor parte del beneficio. En otros casos, el modelo solo funciona bien con una combinación específica de mensaje/herramienta. Cada caso es diferente. El punto es medir la configuración como una unidad en lugar de asumir que las piezas se suman limpiamente.
Resultados: las señales útiles
Importancia de la característica
La primera pregunta no es "¿qué coeficiente parece inteligente?" Es: ¿qué variación realmente importa?
En este experimento en particular, la señal más importante es la interacción triple entre modelo, mensaje y herramienta. Eso no significa que todos los agentes de evaluación se comportarán de esta manera. En algunos sistemas, predominará la elección del modelo. En otros, la calidad de recuperación o la calidad del OCR pueden eclipsar todo lo demás.
Aquí, sin embargo, el resultado es lo suficientemente claro como para actuar en consecuencia: evaluar el modelo, el mensaje y la herramienta de forma independiente perdería gran parte de la historia. El aviso como efecto principal global es pequeño, pero el aviso aparece dentro de la estructura de interacción. Eso significa que el valor del aviso es condicional. Depende de con qué modelo y herramienta se combine.
Clasificaciones de configuración
Aquí están las 8 configuraciones clasificadas según su puntuación de utilidad total de Plackett-Luce, y cada término se muestra explícitamente. Los términos β (beta) se aplican a factores individuales como la elección del modelo. Los términos γ (gamma) muestran cómo interactúan las opciones, como la forma en que el modelo y la herramienta funcionan juntos.
Las clasificaciones cambian una vez que se tiene en cuenta la calidad de la competencia. Config 1 cae del segundo lugar al tercero en tasa de ganancias bruta. Config 4 salta del cuarto al segundo con una tasa de victorias bruta. La configuración 5 es un caso de precaución: tiene la línea de base de solo β más sólida en el papel, pero su puntuación total cae por debajo de cero una vez que se incluyen las penalizaciones por interacción.
Ese es exactamente el tipo de señal que la puntuación promedio tiende a enterrar. La pregunta no es sólo "¿qué componentes son más fuertes?" Se trata de "¿qué configuración gana frente a alternativas serias?"
Decisiones operativas
Implementar: Configuración 7
Configuración 7: GPT-5.4-mini / Contextual Leaper / semantic_search · Total: +0,431
La configuración 7 es el claro ganador con +0,431. La base de referencia de sus componentes individuales es sólida, pero no suficiente para explicar el resultado por sí sola. Lo que lo distingue es que el modelo, el mensaje y la herramienta se refuerzan mutuamente. El Contextual Leaper y la herramienta semántica son específicamente buenos con GPT-5.4-mini en esta configuración.
La lección operativa no es “las herramientas semánticas siempre ganan” o “las indicaciones abiertas siempre ganan”. La lección es más concreta y útil: esta configuración funciona como una unidad. Envíelo como un flujo de trabajo dedicado y no asuma que la misma ganancia de interacción sobrevive a un cambio de modelo.
Implementar: Configuración 4
Configuración 4: GPT-5.4-mini / Planificador sistemático / stream_table_rows · Total: +0,196
La configuración 4 alcanza +0,196 por una ruta diferente. Combina GPT-5.4-mini con Systematic Planner y la herramienta basada en transmisiones. Si su arquitectura hace que la integración de transmisiones sea más simple que la búsqueda semántica, esto no es solo una alternativa. Es un candidato legítimo a la producción.
Esto es importante porque las decisiones reales de implementación incluyen el costo, la latencia, la complejidad de la integración y la confiabilidad. El ganador estadístico no siempre es el ganador empresarial. El valor del modelo es que le brinda un mejor mapa del espacio comercial.
Investigar: Configuración 1
Configuración 1 — Haiku 4.5 / Planificador sistemático / búsqueda_semántica · Total: +0,152
La configuración 1 es el caso interesante. Es la única configuración de Haiku que supera el cero, a pesar de conllevar la penalización de modelo. Eso la convierte en una evidencia útil, no simplemente una prueba secundaria.
La historia plausible es la complementariedad. Haiku parece beneficiarse de la estructura y las posibilidades de las herramientas de una manera que GPT no lo hace. El modelo más débil puede necesitar más el andamiaje y la herramienta semántica, mientras que el modelo más fuerte puede experimentar el mismo andamio como fricción.
Esta es la razón por la que la resistencia del componente y la resistencia de la configuración no son lo mismo. Un componente más débil aún puede pertenecer a una configuración fuerte cuando las piezas circundantes lo compensan.
Podar: Configuración 5
Configuración 5: GPT-5.4-mini / Planificador sistemático / búsqueda_semántica · Total: −0,066
Suma solo β: +0,201 (la más alta de cualquier configuración). Los cuatro términos de interacción se vuelven negativos.
La configuración 5 se ve bien si solo sumas las partes: modelo sólido, mensaje positivo, herramienta positiva. Pero su puntuación de utilidad total es −0,066.
Esa es la trampa. Las piezas parecen atractivas de forma aislada, pero la combinación no funciona tan bien como se esperaba. En esta configuración, el Planificador Sistemático y la herramienta semántica parecen crear fricción bajo GPT-5.4-mini en lugar de apalancamiento.
Las configuraciones 0 y 3 también se encuentran debajo de la línea de acción. En un sistema de producción, los eliminaría de la rotación, los preservaría como casos de referencia y gastaría el presupuesto de evaluación en competidores más fuertes o más informativos.
Qué optimizar a continuación
La tabla de importancia de las funciones responde a una pregunta que los equipos suelen omitir: antes de optimizar algo, ¿a qué palanca merece más atención?
En este experimento, los barridos rápidos y aislados serían una medida de bajo apalancamiento. El aviso no muestra mucho aumento global. Su valor se muestra a través de las combinaciones. Eso significa que la siguiente prueba útil no es "probar diez indicaciones más". Se trata de "probar estrategias de indicaciones dentro de los pares modelo/herramienta donde es probable que importen".
La misma advertencia se aplica a los cambios de modelo. En algunos casos, cambiar por un modelo más potente le permitirá llegar hasta allí en la mayor parte del camino. En otros casos, puede destruir la estructura de interacción que hizo que funcionara una configuración más pequeña o más barata. Este método le ayuda a ver en qué caso se encuentra.
El trabajo de ingeniería de mayor apalancamiento suele estar en la capa de orquestación: cómo se comportan como un sistema el modelo, el mensaje, la herramienta, el contexto de recuperación y la retroalimentación del juez. Un diseño factorial pequeño no responderá todas las preguntas, pero es un primer paso mucho mejor que la puntuación aislada en una tabla de clasificación.
Cerrar el ciclo: devolver Eval al agente
La versión más útil de esto no es un punto de referencia único.
Una vez estimadas las utilidades, los resultados pueden retroalimentarse al propio sistema del agente. Las configuraciones ganadoras se convierten en flujos de trabajo predeterminados. Las configuraciones incorrectas se eliminan de la rotación. Los casos extremos se convierten en pruebas de seguimiento específicas. Si un enrutador elige entre combinaciones de modelo/indicador/herramienta, las utilidades instaladas se convierten en contexto para ese enrutador en lugar de conocimiento tribal que vive en una computadora portátil.
El bucle: probar configuraciones → juzgar resultados → estimar utilidad → implementar ganadores → eliminar fallas → actualizar el contexto de enrutamiento → probar nuevamente.
Eso cambia el papel de la evaluación. Ya no es sólo una boleta de calificaciones a posteriori. Se convierte en parte del ciclo de aprendizaje del agente.
Límites y próximos pasos
Esta es una demostración, no un artículo académico. La muestra es intencionalmente pequeña, las herramientas son resguardos y los intervalos de confianza son amplios. Esto está bien para el propósito del artículo: el objetivo es mostrar cuánta señal puede capturar la comparación directa, no pretender una ley universal sobre estos modelos, indicaciones o herramientas específicas.
Las extensiones naturales son sencillas: agregar OCR como cuarto factor, probar una gama más amplia de familias de modelos, incluir el costo o la latencia explícitamente y realizar más pruebas para reducir la incertidumbre. La misma estructura también se puede implementar como evaluador recurrente en LangSmith o una pila de evaluación similar.
El punto más importante es el que vale la pena seguir adelante: la evaluación de agentes no debería consistir únicamente en calificar respuestas aisladas y clasificar promedios. Cuando las configuraciones compiten cara a cara en ejemplos compartidos, se obtiene una visión más clara de lo que realmente funciona. El modelo de clasificación es sólo el intérprete. El valor real es la estructura de comparación.
@misc{Factura a Json,
title={Invoice-to-Json: un conjunto de datos de extracción de información y comprensión de documentos},
año={2024}
}
Sobre el autor
Doster Esh es un arquitecto de información centrado en la estructura del contexto y la evaluación estadística. Gran parte de su trabajo se centra en agregar estructura a los datos de manera que simplifiquen el espacio de decisión, a través de lo que él llama partición cultivada. La idea central es que tanto los humanos como los agentes toman mejores decisiones cuando no se sienten abrumados cognitivamente por información indiferenciada. Tiene un historial de dirección de una empresa de comercio cuantitativo de electricidad y de trabajo como científico de datos en servicios financieros y minoristas. Si desea hablar sobre el uso de AI/ML para estructurar su contexto, comuníquese con nosotros.