
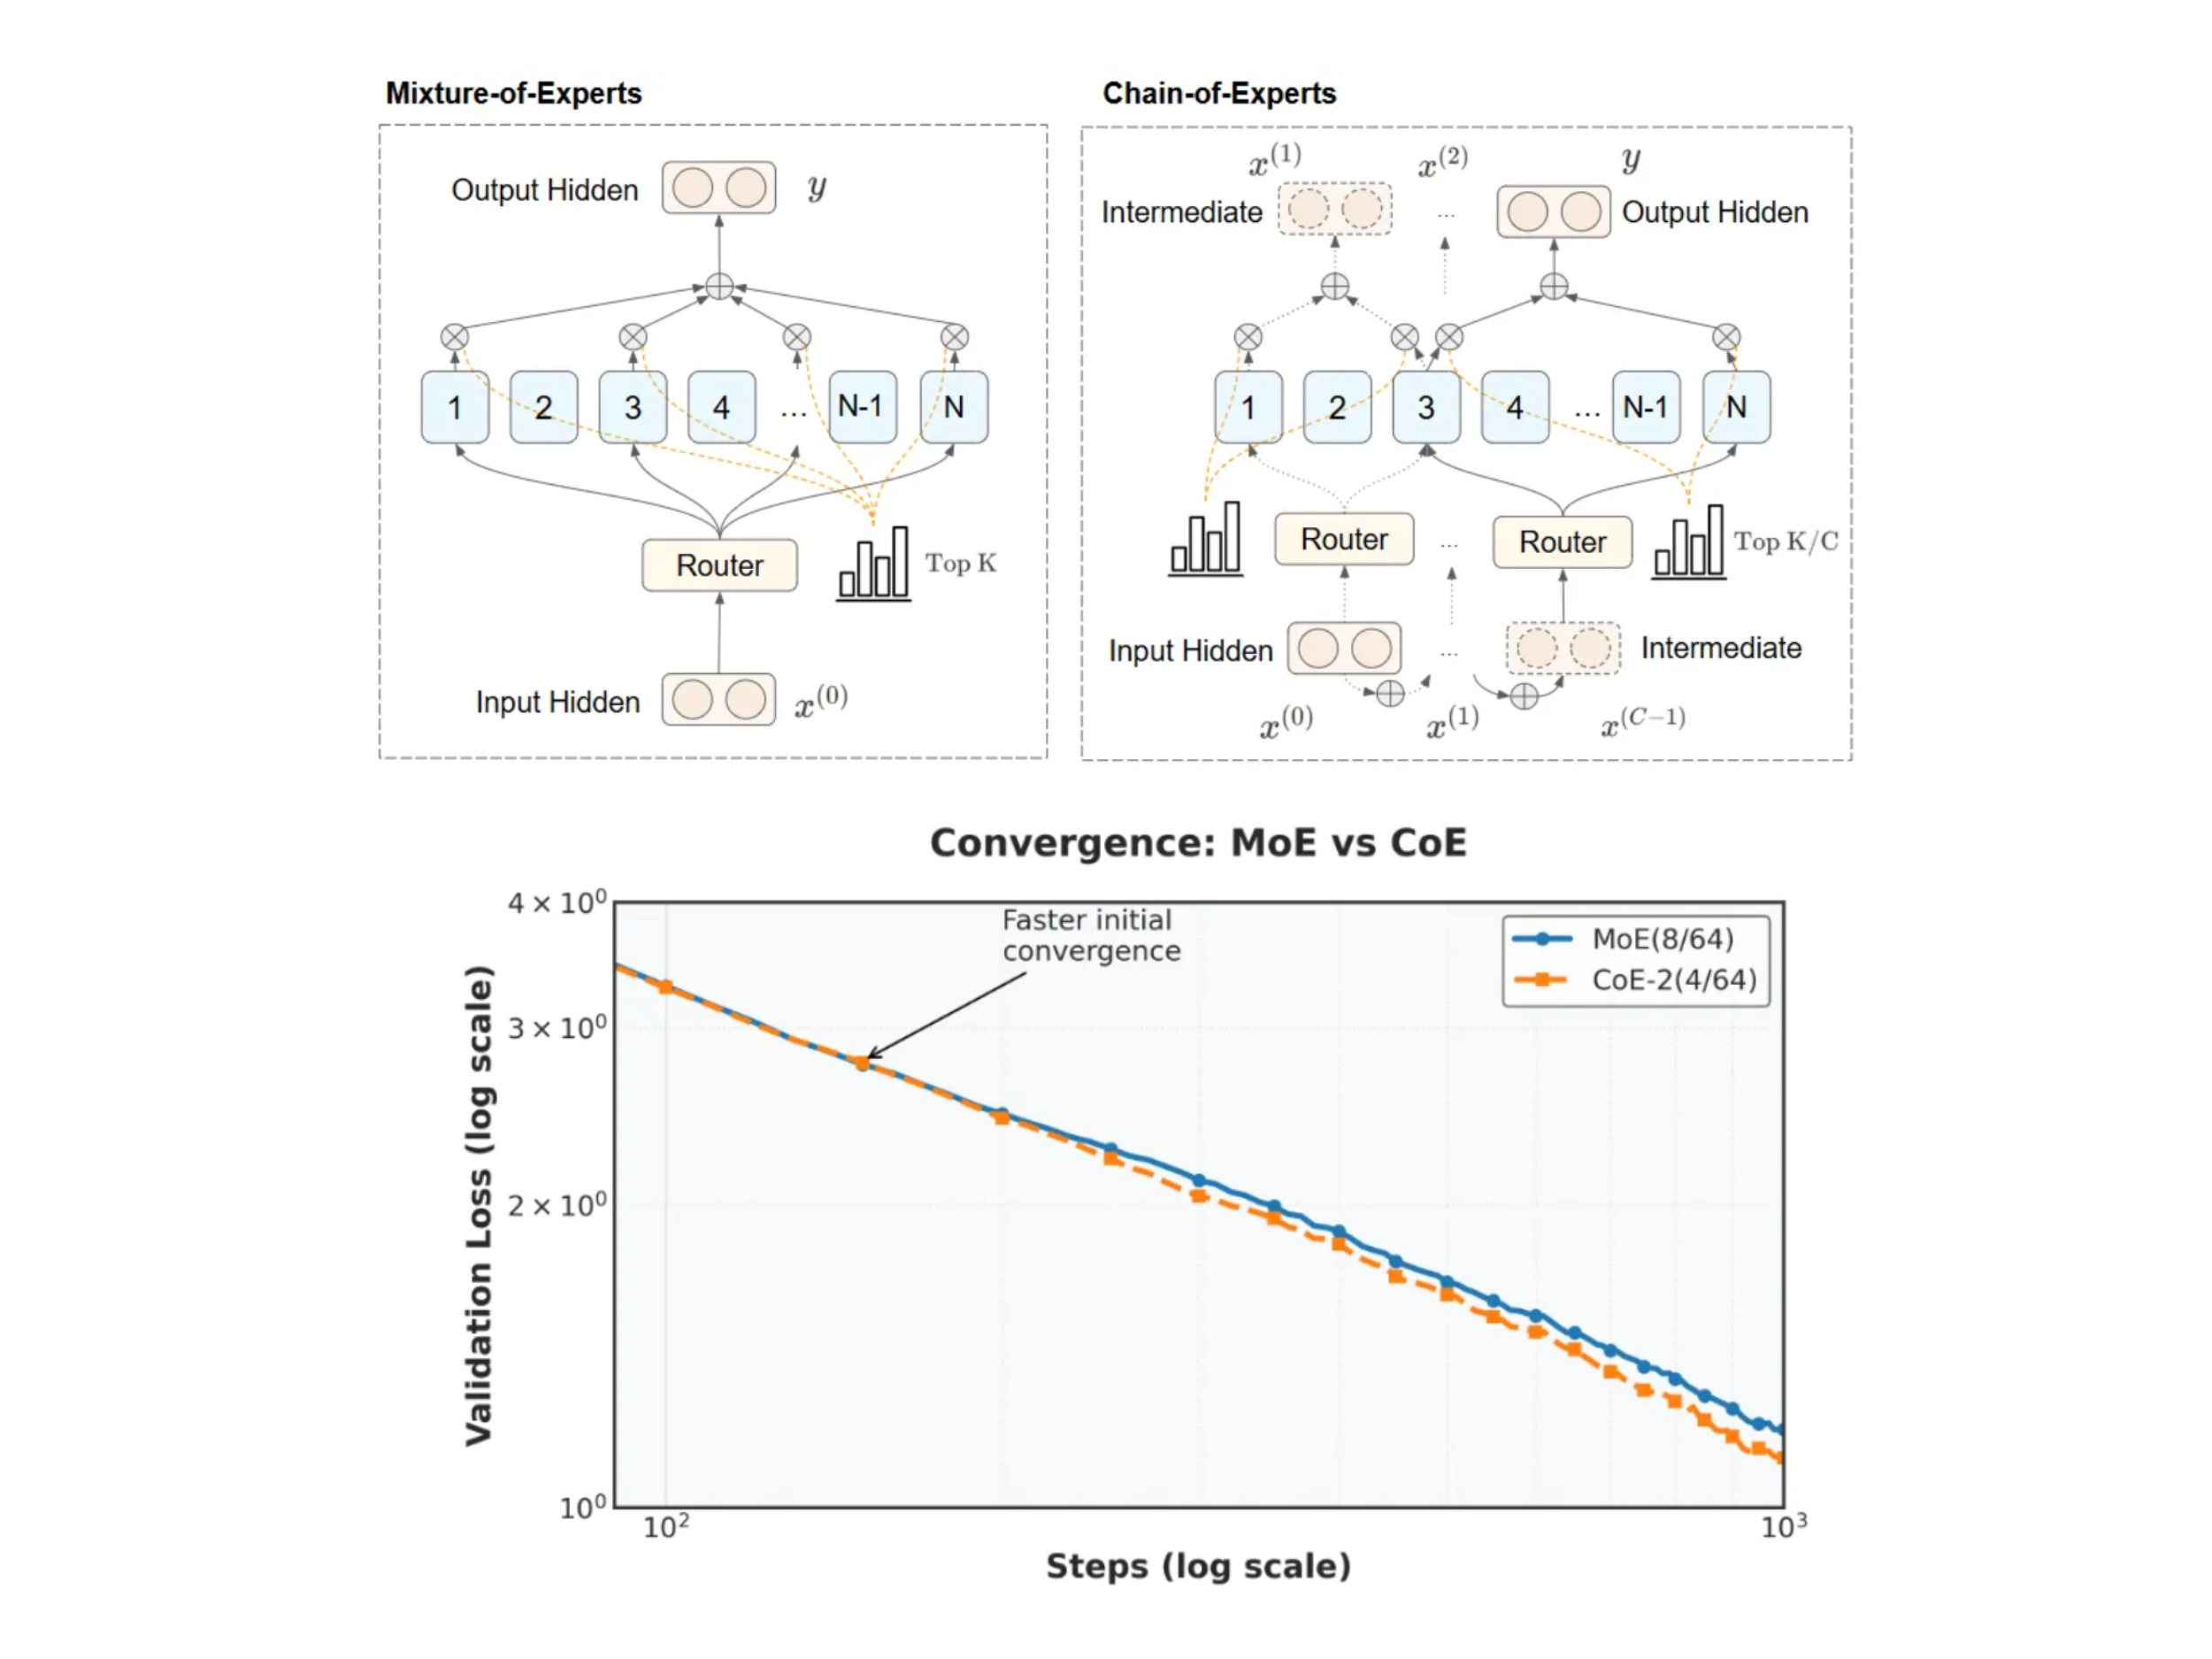
Los modelos de idiomas grandes han avanzado significativamente nuestra comprensión de la inteligencia artificial, pero escalar estos modelos sigue siendo desafiante. Las arquitecturas tradicionales de la mezcla de expertos (MOE) activan solo un subconjunto de expertos por token para economizar en el cálculo. Sin embargo, este diseño conduce a dos problemas notables. Primero, los expertos procesan tokens de forma aislada: cada experto trabaja de forma independiente sin comunicación cruzada. Esta separación puede limitar la capacidad del modelo para aprovechar diversas perspectivas durante el procesamiento. En segundo lugar, aunque las arquitecturas de MOE usan un patrón de activación escaso, todavía requieren una memoria considerable porque el recuento general de parámetros es alto, incluso si solo unos pocos están activos a la vez. Estos desafíos sugieren que, si bien los modelos MOE son un paso adelante en la escalabilidad, su diseño inherente puede limitar tanto el rendimiento como la eficiencia de los recursos.
El enfoque de la cadena de expertos (COE)
La cadena de expertos (COE) ofrece una reexaminación reflexiva de las arquitecturas MOE al introducir un mecanismo para la comunicación secuencial entre los expertos. A diferencia del procesamiento independiente visto en los modelos MOE tradicionales, COE permite que los tokens se procesen en una serie de iteraciones dentro de cada capa. En este arreglo, la salida de un experto sirve como entrada para el siguiente, creando así una cadena comunicativa que permite a los expertos construir sobre el trabajo de los demás. Esta interacción secuencial no simplemente apila las capas; Facilita un enfoque más integrado para el procesamiento de tokens, donde cada experto refina la interpretación del token en función de los resultados anteriores. El resultado es un modelo que aprovecha el potencial de colaboración de sus expertos mientras tiene como objetivo usar la memoria de manera más eficiente [][[
Detalles y beneficios técnicos
En el corazón del método COE hay un proceso iterativo que redefine cómo interactúan los expertos. Por ejemplo, considere una configuración descrita como COE-2 (4/64): el modelo funciona con dos iteraciones por token, con cuatro expertos seleccionados de un grupo de 64 expertos disponibles en cada ciclo. Este diseño contrasta con las configuraciones tradicionales de MOE, que dependen de un solo pase a través de un grupo preseleccionado de expertos.
Un elemento técnico clave en COE es el mecanismo de activación independiente. En los modelos MOE convencionales, la función de activación selecciona qué expertos deben procesar un token, pero estas decisiones se toman una vez por token por capa. CoE extiende esta idea al permitir que la decisión de activación de cada experto se tome de forma independiente durante cada iteración. Esta flexibilidad fomenta una forma de especialización, donde un experto puede ajustar su procesamiento en función de la información recibida de iteraciones anteriores.
Además, el uso de conexiones residuales internas en COE mejora aún más el modelo. En lugar de simplemente agregar el token original después de toda la secuencia de procesamiento (una conexión residual externa), COE integra conexiones residuales dentro de cada iteración. Este diseño ayuda a mantener la integridad de la información del token al tiempo que permite mejoras incrementales en cada paso.
Estas innovaciones técnicas contribuyen colectivamente a un modelo que no solo mantiene el rendimiento con menos recursos, sino que también proporciona una vía de procesamiento más matizada que podría ser particularmente valiosa para las tareas que requieren un razonamiento en capas.


Resultados e ideas experimentales
Los estudios empíricos subrayan el potencial del método de la cadena de expertos. En experimentos controlados, como el tratamiento previo en las tareas relacionadas con las matemáticas, las configuraciones como COE-2 (4/64) han demostrado una reducción en la pérdida de validación (de 1.20 a 1.12) en comparación con los modelos MOE tradicionales que operan bajo las mismas condiciones computacionales. Esta mejora se logra sin aumentar la memoria general o el costo computacional, ya que la comunicación secuencial permite un uso más efectivo de la capacidad de cada experto.
Otras evaluaciones han demostrado que aumentar el recuento de iteraciones en COE puede generar beneficios comparables o incluso exceder los obtenidos al aumentar el número de expertos seleccionados en una sola pasada. Por ejemplo, incluso cuando los presupuestos de memoria y cómputo se mantienen constantes, las configuraciones de COE exhiben hasta una reducción del 18% en el uso de la memoria al tiempo que logran resultados de rendimiento similares o mejores.
Además, el diseño secuencial de COE abre un número sustancialmente mayor de combinaciones de expertos, hasta 823 veces más que los métodos tradicionales. Este aumento dramático en las posibles vías de expertos significa que el modelo tiene un conjunto más rico de opciones al procesar cada token, lo que puede conducir a resultados más robustos y especializados.
Estos hallazgos sugieren que COE proporciona una vía para repensar cómo los grandes modelos de idiomas pueden ser eficientes y efectivos, allanando el camino para aplicaciones de IA más sostenibles en el futuro.

Conclusión
El marco de la cadena de expertos representa una evolución medida en el diseño de redes neuronales dispersas. Al introducir una comunicación secuencial entre los expertos, COE aborda las limitaciones del procesamiento de token independiente y el alto uso de la memoria inherente a los modelos MOE tradicionales. Las innovaciones técnicas, particularmente el mecanismo de activación independiente y las conexiones residuales internas, se pueden incluir un enfoque más eficiente y flexible para escalar modelos de idiomas grandes.
Los resultados experimentales, aunque preliminares, sugieren que COE puede lograr mejoras modestas pero significativas en el rendimiento y la utilización de recursos. Este enfoque invita a una exploración adicional, particularmente en cómo la comunicación iterativa podría extenderse o refinar en futuras arquitecturas de modelos. A medida que continúa la investigación en esta área, COE se destaca como un paso reflexivo para lograr un equilibrio entre la eficiencia computacional y el rendimiento del modelo, uno que finalmente puede contribuir a sistemas de IA más accesibles y sostenibles
Verificar el Detalle técnico y Página de Github. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, siéntete libre de seguirnos Gorjeo Y no olvides unirte a nuestro Subreddit de 80k+ ml.

Aswin AK es un pasante de consultoría en MarktechPost. Está persiguiendo su doble título en el Instituto de Tecnología Indio, Kharagpur. Le apasiona la ciencia de datos y el aprendizaje automático, aportando una sólida experiencia académica y una experiencia práctica en la resolución de desafíos de dominio de la vida real.