
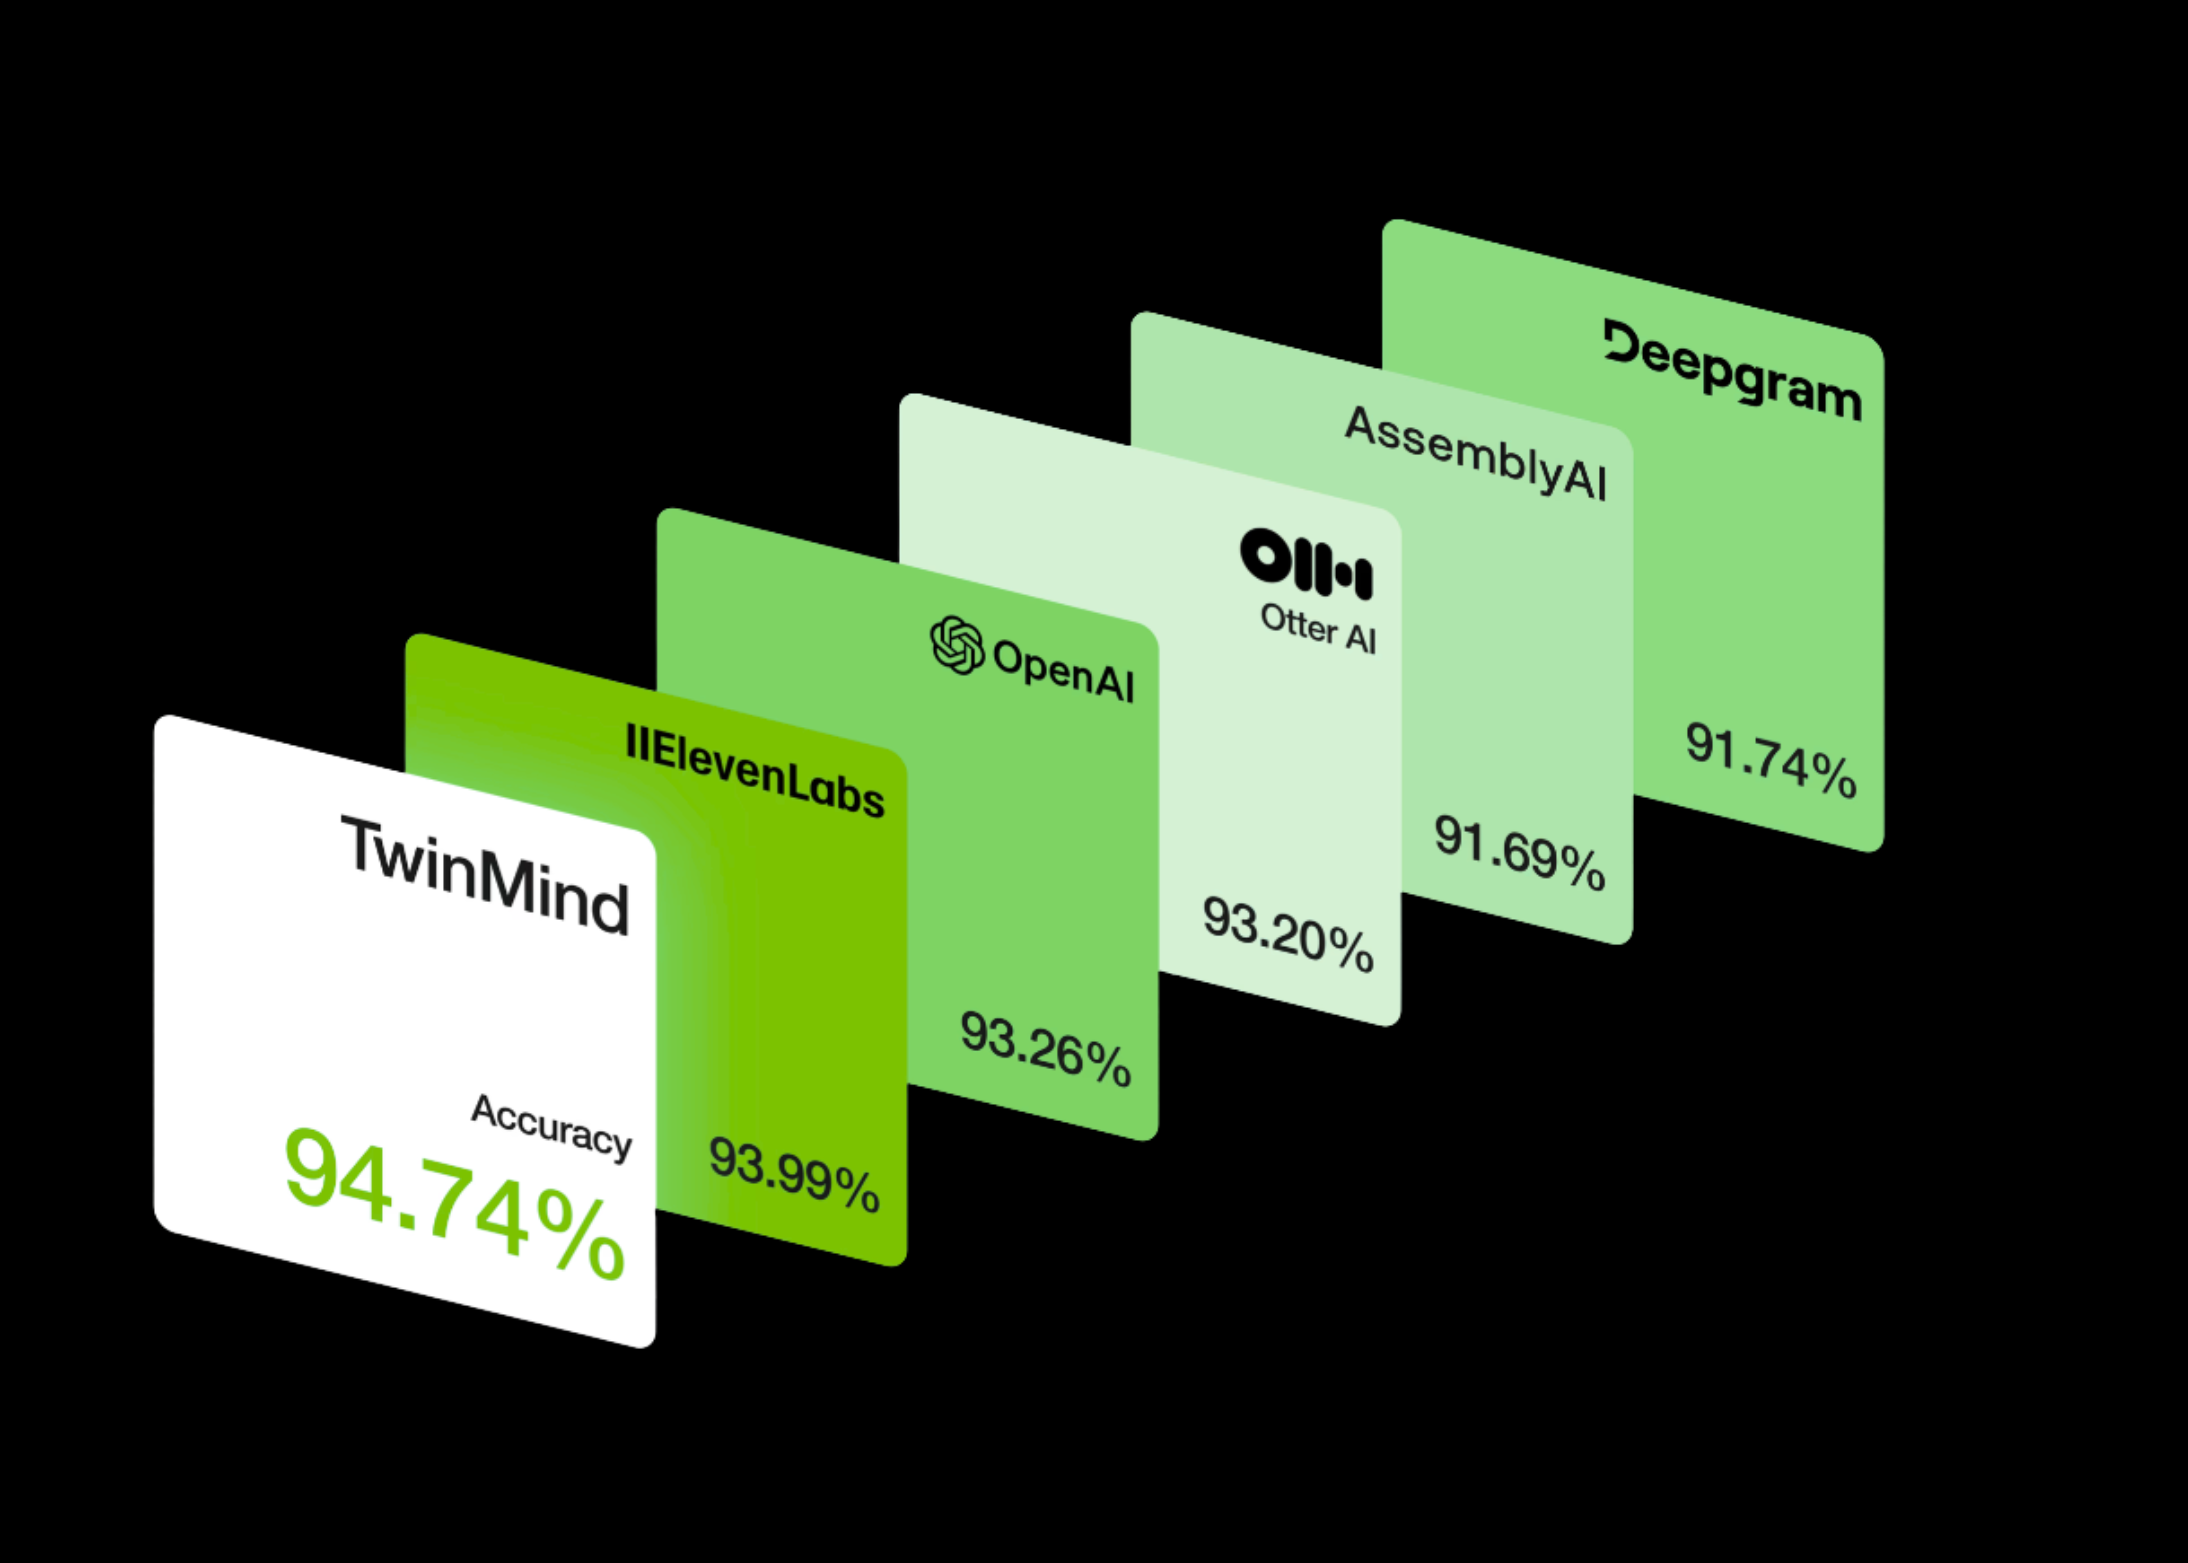
Twinmind, una startup de voz de voz con sede en California, presentada Oído 3 Modelo de reconocimiento del habla, reclamando el rendimiento de vanguardia en varias métricas clave y un soporte multilingüe expandido. El lanzamiento posiciona EAR-3 como una oferta competitiva contra las soluciones existentes de ASR (reconocimiento automático de voz) de proveedores como Deepgram, Assemyai, Once Labs, Otter, Speechmatics y OpenAI.
Métricas clave
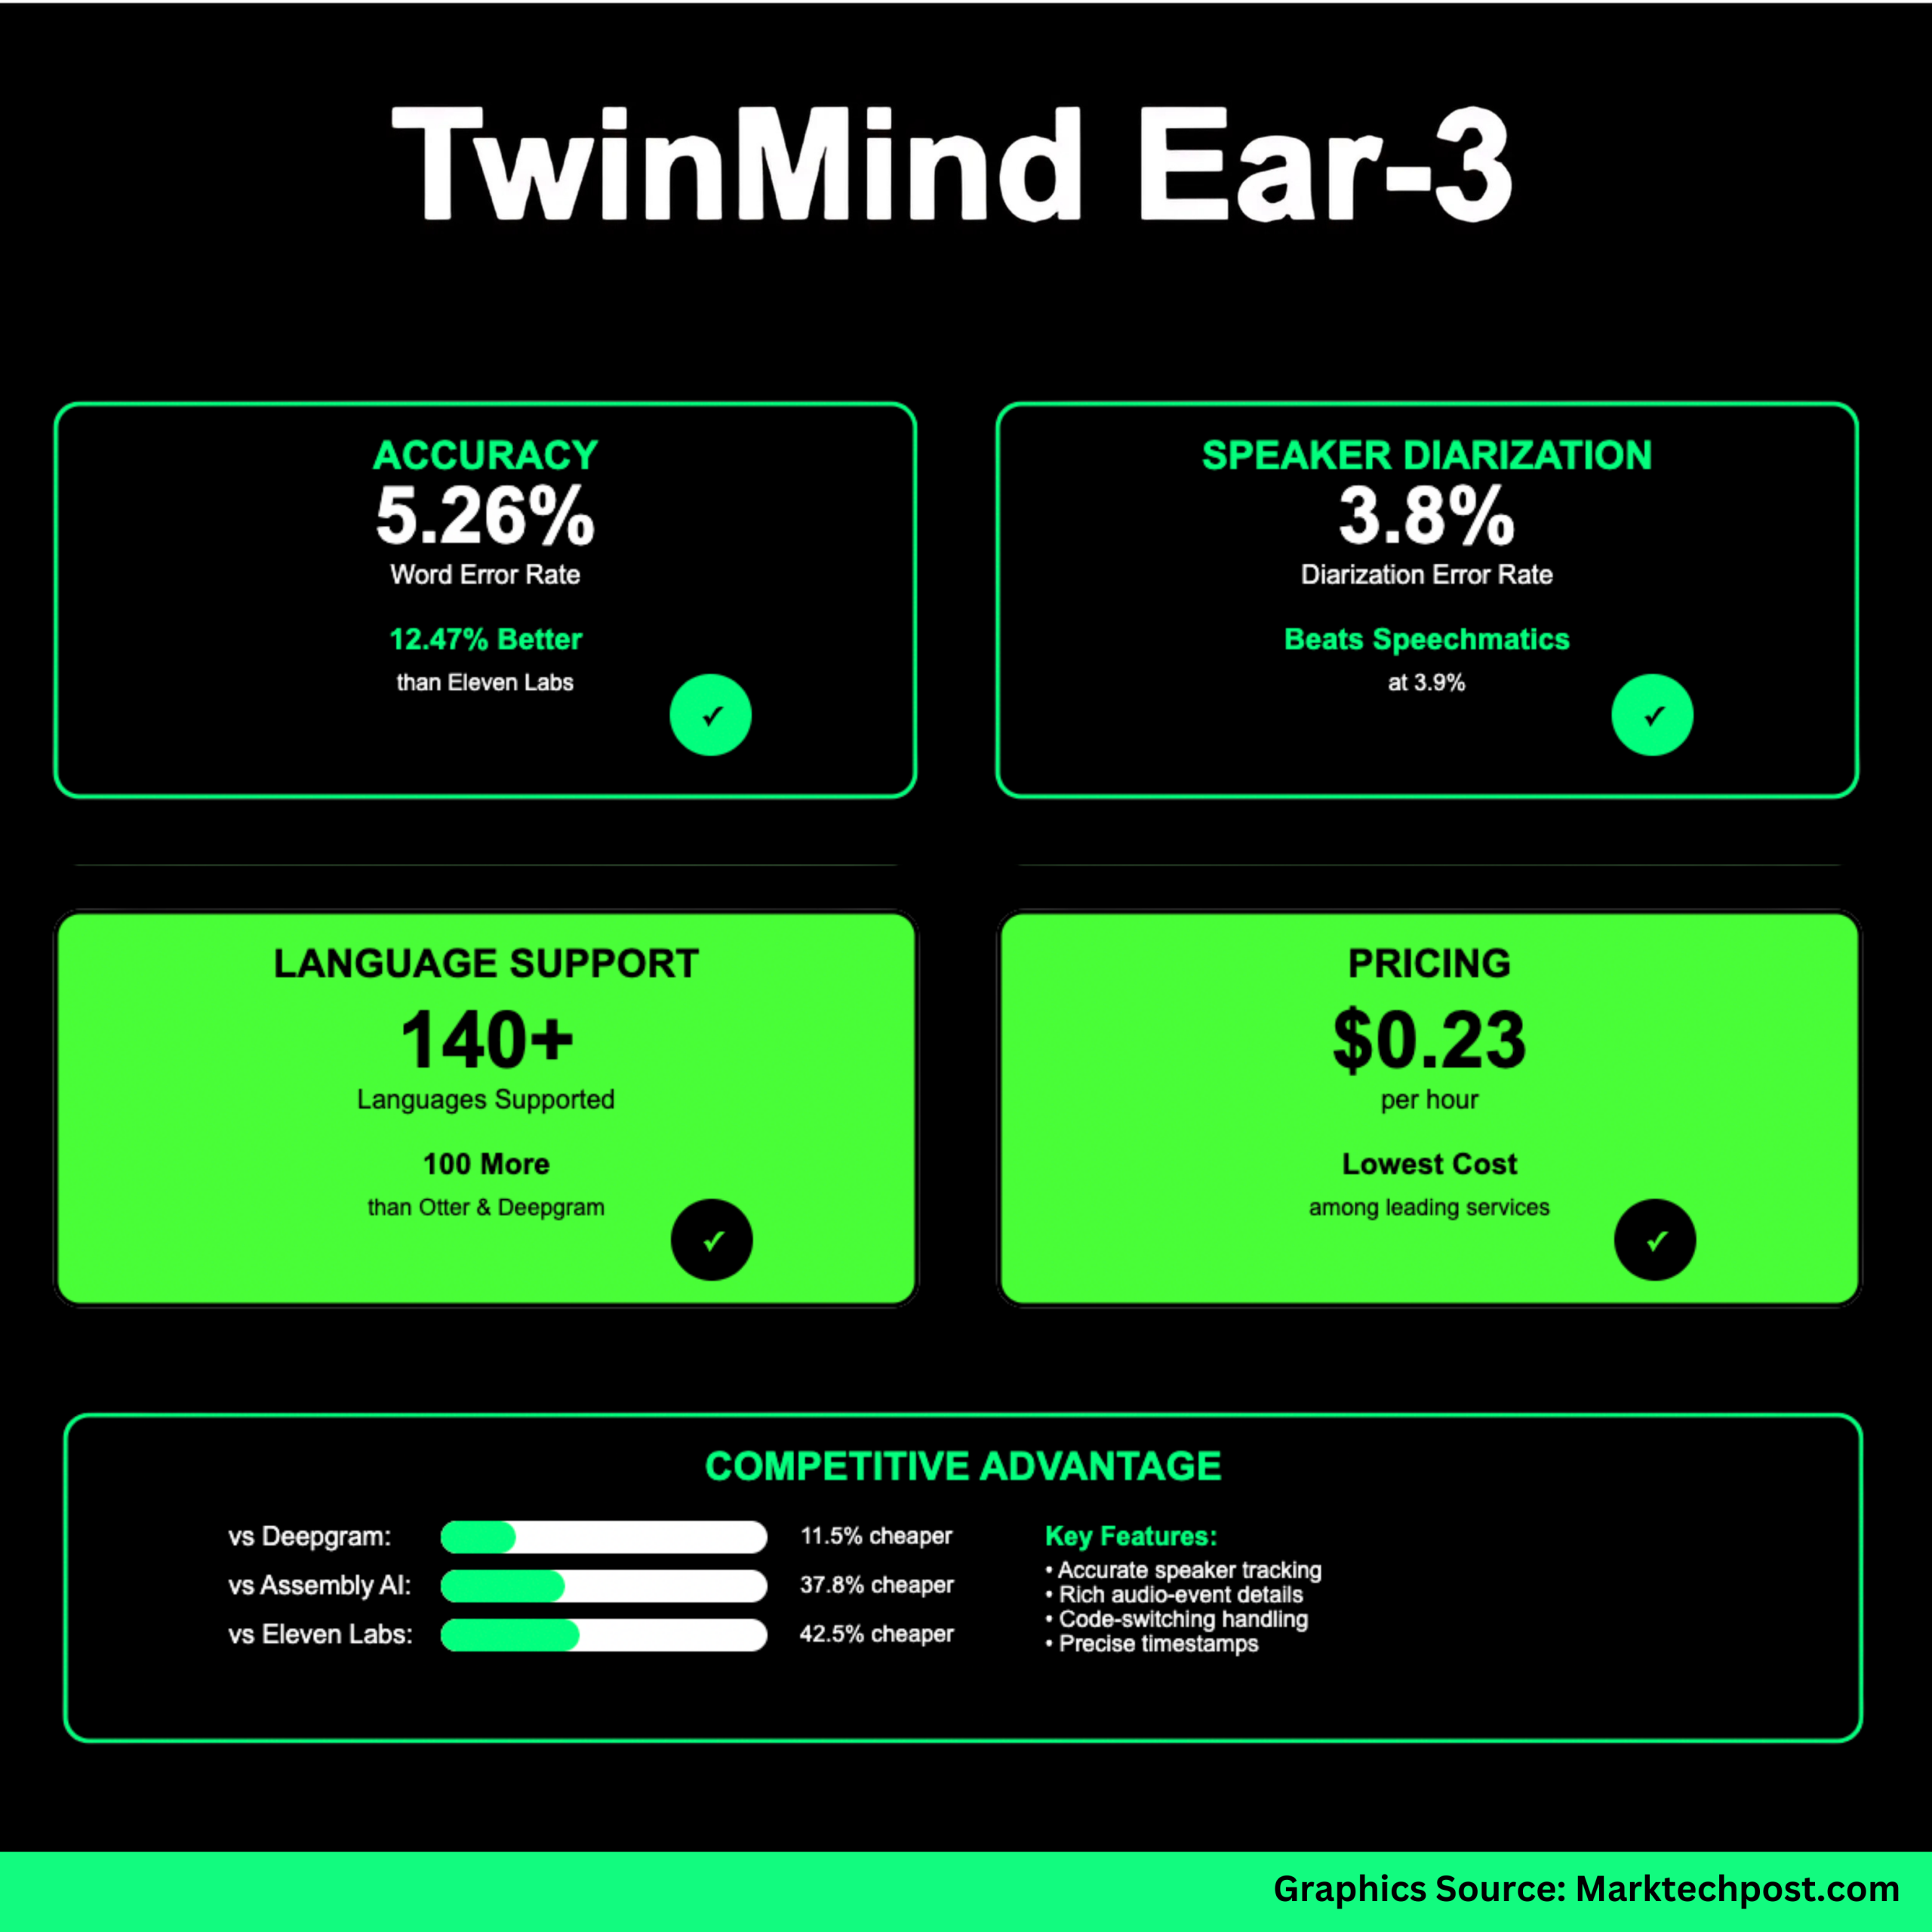
| Métrico | TwinMind Ear-3 Resultado | Comparaciones / notas |
|---|---|---|
| Tasa de error de palabras (WER) | 5.26 % | Significativamente más bajo que muchos competidores: Deepgram ~ 8.26 %, Assemyai ~ 8.31 %. |
| Tasa de error de diarios de altavoz (DER) | 3.8 % | Ligera mejora sobre el mejor anterior de Speechmatics (~ 3.9 %). |
| Soporte lingüístico | Más de 140 idiomas | Más de 40 idiomas más que muchos modelos principales; Objetivos de la “verdadera cobertura global”. |
| Costo por hora de transcripción | US $ 0.23/hr | Posicionado como el más bajo entre los principales servicios. |
Enfoque técnico y posicionamiento
- TwinMind indica que Ear-3 es una “mezcla ajustada de varios modelos de código abierto”, entrenado en un conjunto de datos curado que contiene fuentes de audio anotadas por humanos, como podcasts, videos y películas.
- La diarización y el etiquetado de los altavoces se mejoran a través de una tubería que incluye la limpieza y mejora de audio antes de la diarización, más las “verificaciones de alineación precisas” para refinar las detecciones límite de altavoces.
- El modelo maneja el cambio de código y los scripts mixtos, que generalmente son difíciles para los sistemas ASR debido a la variada fonética, la varianza de acento y la superposición lingüística.
Compensaciones y detalles operativos
- Oído 3 Requiere implementación de la nube. Debido al tamaño de su modelo y la carga de cómputo, no puede estar completamente fuera de línea. El EAR-2 (su modelo anterior) de Twinmind sigue siendo el respaldo cuando se pierde la conectividad.
- Privacidad: TwinMind afirman que el audio no se almacena a largo plazo; Solo las transcripciones se almacenan localmente, con copias de seguridad encriptadas opcionales. Las grabaciones de audio se eliminan “On The Fly”.
- Integración de la plataforma: el acceso a la API para el modelo se planifica en las próximas semanas para desarrolladores/empresas. Para los usuarios finales, la funcionalidad EAR-3 se implementará en las aplicaciones para iPhone, Android y Chrome de Twinmind durante el próximo mes para los usuarios Pro.
Análisis e implicaciones comparativas
Las métricas WER y DER de EAR-3 lo pusieron por delante de muchos modelos establecidos. Lower Wer se traduce en menos errores de transcripción (reconocimientos erróneos, palabras caídas, etc.), lo que es crítico para dominios como legal, médico, transcripción de conferencias o archivo de contenido sensible. Del mismo modo, el DER más bajo (es decir, la mejor separación de altavoces + etiquetado) es importante para reuniones, entrevistas, podcasts, cualquier cosa con múltiples participantes.
El precio del precio de US $ 0.23/h hace que la transcripción de alta precisión sea más factible económicamente para el audio de forma larga (por ejemplo, horas de reuniones, conferencias, grabaciones). Combinado con el soporte para más de 140 idiomas, existe un claro impulso para hacer esto utilizable en entornos globales, no solo contextos de idiomas centrados en el inglés o de los recursos.
Sin embargo, la dependencia de la nube podría ser una limitación para los usuarios que necesitan capacidades fuera de línea o en dispositivos de borde, o donde las preocupaciones de privacidad / latencia de datos son estrictas. La complejidad de la implementación para soportar más de 140 lenguajes (acento deriva, dialectos, cambio de código) puede revelar zonas más débiles en condiciones acústicas adversas. El rendimiento del mundo real puede variar en comparación con la evaluación comparativa controlada.

Conclusión
El modelo EAR-3 de Twinmind representa una fuerte afirmación técnica: alta precisión, precisión de diarización de altavoces, cobertura de idioma extensa y reducción de costos agresivos. Si los puntos de referencia se mantienen en un uso real, esto podría cambiar las expectativas de lo que los servicios de transcripción “premium” deberían ofrecer.
Mira el Página del proyecto. No dude en ver nuestro Página de Github para tutoriales, códigos y cuadernos. Además, siéntete libre de seguirnos Gorjeo Y no olvides unirte a nuestro Subreddit de 100k+ ml y suscribirse a Nuestro boletín.
Michal Sutter es un profesional de la ciencia de datos con una Maestría en Ciencias en Ciencias de Datos de la Universidad de Padova. Con una base sólida en análisis estadístico, aprendizaje automático e ingeniería de datos, Michal se destaca por transformar conjuntos de datos complejos en ideas procesables.