
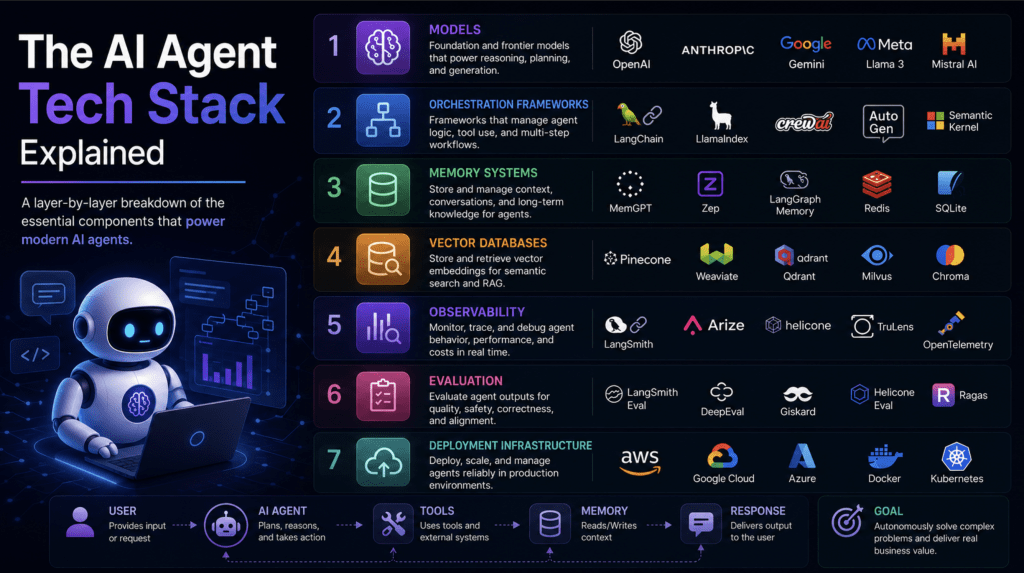
En este artículo, aprenderá cómo encajan las siete capas de una pila de agentes de IA de producción, desde el modelo básico hasta la infraestructura de implementación.
Los temas que cubriremos incluyen:
Qué hace cada capa de la pila, desde el modelo básico y el marco de orquestación hasta la memoria, la recuperación, las herramientas, la observabilidad y la implementación. Cómo implementar cada capa con código de trabajo, incluido un agente con estado, un sistema de memoria, una canalización RAG, herramientas personalizadas y seguimiento. Qué combinación de tecnologías usar en cada capa dependiendo de si está creando prototipos, escalando una startup u operando en un entorno empresarial.
Introducción
Imagínese esto: le pide a un agente de inteligencia artificial que investigue a tres competidores, extraiga los datos de precios de cada uno de sus sitios web, resuma los hallazgos en un informe estructurado y lo suelte en un canal de Slack antes de las 9 a.m. Presionas enter. Treinta segundos después, el informe está ahí.
Lo que acaba de suceder bajo el capó no es mágico y no es una sola cosa. Se trata de siete capas distintas de tecnología que funcionan en secuencia, cada una de las cuales realiza un trabajo específico y cada una es capaz de romperse de su manera específica. El modelo de arriba se lleva toda la atención. Las seis capas debajo son las que determinan si el agente realmente funciona.
Según Gartner, el 40% de las aplicaciones empresariales se integrarán con agentes de IA para tareas específicas para finales de 2026, frente a menos del 5% en 2025. No se trata de una curva gradual. Se trata de una línea de adopción casi vertical, y los ingenieros y líderes técnicos responsables de esas implementaciones deben comprender la pila completa, no solo la capa que poseen.
Este artículo analiza cada capa en orden, desde el modelo básico hasta la infraestructura de implementación. Al final, sabrás qué es cada pieza, por qué existe, cómo se conectan las capas entre sí y qué usar realmente en cada nivel.
Capa 1: El modelo de base
El modelo fundamental es el núcleo cognitivo de un agente. Es donde ocurre el razonamiento, se comprende el lenguaje y se toman decisiones sobre qué hacer a continuación. Todo lo demás en la pila le proporciona contexto o actúa sobre lo que produce.
En términos prácticos, sus principales opciones en 2026 son GPT-5.5 de OpenAI, Claude Sonnet 4.6 de Anthropic (o Claude Opus 4.8 para un razonamiento más complejo), Gemini 3.1 Pro de Google y modelos de peso abierto como Llama 4 y Mistral Large 3 de Meta. Cada uno tiene compensaciones que vale la pena comprender antes de comprometerse.
GPT-5.5 es rápido para las llamadas diarias y confiable para llamar a herramientas, y tiene el ecosistema de integraciones más maduro y la comunidad más amplia de desarrolladores que ya han encontrado y resuelto los casos extremos que encontrará. Claude Sonnet 4.6 maneja documentos largos e instrucciones matizadas, siguiendo bien a un precio más bajo que el nivel Opus de Anthropic, que es importante en flujos de trabajo con muchos documentos; recurra a Claude Opus 4.8 cuando una tarea necesite un razonamiento más profundo y con un horizonte más amplio. Gemini 3.1 Pro tiene una ventana de contexto de 1 millón de tokens, lo cual es relevante si su agente necesita procesar grandes bases de código o bases de conocimiento extensas en una sola pasada. Los modelos abiertos como Llama 4 le brindan control total sobre la implementación y la residencia de los datos, a costa de la sobrecarga de infraestructura que supone ejecutarlos usted mismo.
Ya no existe una división marcada entre familias de modelos “estándar” y “razonables”, como existía en 2025; OpenAI, Anthropic y Google han combinado el razonamiento en un único modelo que decide cuánto tiempo pensar. GPT-5.5 se entrega con niveles de esfuerzo de razonamiento ajustables (desde ninguno hasta xalto), y lo mismo se aplica al parámetro de esfuerzo de Claude y los niveles de pensamiento de Gemini. Para la mayoría de los flujos de trabajo de los agentes, la configuración predeterminada o de bajo esfuerzo es la opción correcta: rápida y económica. Para tareas que requieren una planificación cuidadosa o razonamiento matemático, aumentar el nivel de esfuerzo recupera su costo en corrección.
Capa 2: el marco de orquestación
Si el modelo fundamental es el cerebro, el marco de orquestación es el sistema nervioso. Maneja el flujo de control: decide qué debe hacer el agente a continuación, cuándo debe llamar a una herramienta, cómo debe manejar el resultado y cómo todo el ciclo de razonamiento se mantiene coherente en múltiples pasos.
El patrón que implementan la mayoría de los marcos se llama ReAct (Razonamiento y Actuación). El agente produce un pensamiento, decide una acción, ejecuta la acción a través de una herramienta, observa el resultado y luego vuelve a pensar. Este ciclo se repite hasta que el agente produce una respuesta final. Suena sencillo. En la práctica, es donde ocurren la mayoría de las fallas de producción: el agente llama a la herramienta equivocada, se queda atrapado en un bucle o no reconoce cuándo tiene suficiente información para detenerse.
LangChain es el marco más adoptado. Ofrece un gran ecosistema de integraciones y buena documentación. La crítica de que añade demasiada abstracción es justa en la etapa de prototipo, pero menos relevante una vez que se necesitan las características que proporciona la abstracción. LangGraph, creado por el mismo equipo, es más adecuado para flujos de trabajo de múltiples agentes con estado en los que se necesita un control detallado sobre el gráfico de ejecución. Si su agente involucra a varios especialistas que coordinan una tarea, LangGraph es la opción más limpia. CrewAI está diseñado específicamente para la coordinación de múltiples agentes. Le permite definir agentes con roles, asignarles tareas y hacer que colaboren dentro de un flujo de trabajo estructurado. Es de mayor nivel que LangGraph y más rápido de ejecutar, pero le brinda menos control sobre los detalles de ejecución. AutoGen, de Microsoft, adopta un enfoque conversacional para los sistemas multiagente. Los agentes interactúan entre sí a través de una interfaz de paso de mensajes, lo que hace que la lógica de interacción sea muy legible. Semantic Kernel es la opción de Microsoft centrada en la empresa, con soporte listo para producción para C#, Python y Java. Si está operando en un entorno empresarial que ya se ejecuta en la pila de Microsoft, encaja de forma natural. LlamaIndex comenzó como un marco de ingesta y recuperación de documentos y desde entonces ha crecido hasta convertirse en un marco de agente completo, con un soporte particularmente sólido para flujos de trabajo con mucho RAG.
La elección correcta depende de lo que su agente deba hacer. Para un ejecutor de tareas de un solo agente: LangGraph o LangChain. Para un equipo coordinado de agentes especializados: CrewAI o AutoGen. Para entornos empresariales: Kernel Semántico. Para flujos de trabajo de recuperación de documentos pesados: LlamaIndex.
Aquí hay un agente de trabajo mínimo en LangGraph que maneja el uso de herramientas y mantiene el estado.
Requisitos previos:
pip install langgraph langchain-openai langchain-community python-dotenv
pip install langgraph langchain – openai langchain – community python – dotenv
Cómo ejecutar: guarde como agent.py, agregue su OPENAI_API_KEY a un archivo .env y luego ejecute python agent.py
# agent.py
# Minimal stateful agent with tool use built on LangGraph
# Python 3.10+ | LangGraph 0.2+ | LangChain 0.3+
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langchain_community.tools import DuckDuckGoSearchRun
from langchain_core.messages import HumanMessage
from langgraph.prebuilt import create_react_agent
# Load API key from .env file
load_dotenv()
# Initialize the language model
# temperature=0 for deterministic, focused responses in agentic tasks
llm = ChatOpenAI(
model=”gpt-5.5″,
temperature=0,
api_key=os.getenv(“OPENAI_API_KEY”)
)
# Register the tools the agent can use
# DuckDuckGoSearchRun requires no API key — good for development
tools = [DuckDuckGoSearchRun()]
# create_react_agent from LangGraph wires together the LLM,
# tools, and a built-in ReAct loop — no boilerplate required
agent = create_react_agent(llm, tools)
# Run the agent with a sample query
# The agent will decide whether to use a tool based on the question
result = agent.invoke({
“messages”: [HumanMessage(content=”What is the current market cap of Nvidia?”)]
})
# The final response is the last message in the messages list
print(result[“messages”][-1].content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
# agent.py
# Minimal stateful agent with tool use built on LangGraph
# Python 3.10+ | LangGraph 0.2+ | LangChain 0.3+
import os
desde dotenv importar load_dotenv
desde langchain_openai importar ChatOpenAI
de langchain_community . herramientas de importación DuckDuckGoSearchRun
de langchain_core . importar mensajes HumanMessage
de langgraph . importación prediseñada create_react _ agent
# Cargar clave API desde el archivo .env
cargar_dotenv ( )
# Inicializar el modelo de lenguaje
# temperatura=0 para respuestas deterministas y enfocadas en tareas de agencia
llm = ChatOpenAI (
modelo = "gpt-5.5" ,
temperatura = 0 ,
api_key = sistema operativo . getenv ( "OPENAI_API_KEY" )
)
# Registre las herramientas que el agente puede usar
# DuckDuckGoSearchRun no requiere clave API, bueno para el desarrollo
herramientas = [ DuckDuckGoSearchRun ( ) ]
# create_react_agent de LangGraph conecta el LLM,
# herramientas y un bucle ReAct integrado: no se requiere texto estándar
agente = create_react_agent ( llm , herramientas )
# Ejecutar el agente con una consulta de muestra.
# El agente decidirá si utilizar una herramienta en función de la pregunta.
resultado = agente . invocar ( {
"mensajes" : [ HumanMessage ( content = "¿Cuál es la capitalización de mercado actual de Nvidia?" ) ]
} )
# La respuesta final es el último mensaje en la lista de mensajes.
imprimir ( resultado [ " mensajes" ] [ -1 ] . contenido )
Qué hace esto: create_react_agent maneja el bucle ReAct completo automáticamente. El agente recibe la pregunta, decide que necesita datos actuales, llama a la herramienta de búsqueda DuckDuckGo, lee el resultado y sintetiza una respuesta final. La lista de mensajes en el resultado contiene el rastro completo de ese proceso de razonamiento.
Capa 3: Sistemas de memoria
La apatridia es el comportamiento predeterminado de cualquier LLM. Cada llamada comienza desde cero, sin saber lo que vino antes a menos que pases ese contexto explícitamente. Para una pregunta única, eso está bien. Para un agente que necesita rastrear una conversación, recordar las preferencias de un usuario o aprovechar el trabajo que realizó ayer, es un problema fundamental.
Según la investigación de Atlan sobre la memoria de los agentes de IA, el 95% de los pilotos de IA generativa empresarial no obtuvieron un retorno de la inversión medible en 2025, y el fracaso se atribuyó a la preparación del contexto más que a la calidad del modelo. Los agentes fallan no porque el modelo sea incorrecto, sino porque la capa de memoria no está ahí.
Hay cuatro tipos de memoria en un agente de producción y cada una maneja un trabajo diferente:
La memoria de trabajo (en contexto) es la ventana de contexto activa. Contiene la conversación actual, cualquier documento que haya pasado y los resultados de llamadas recientes a herramientas. Es rápido y no requiere infraestructura, pero está vinculado a sesiones. Cuando termina la sesión, desaparece. La memoria episódica es un registro de interacciones anteriores. Como se describe en la investigación sobre los tipos de memoria, la memoria episódica almacena lo que sucedió: marca de tiempo, tarea, acciones realizadas, resultado. Esto es lo que le permite a un agente responder “¿En qué trabajamos el martes pasado?” o "¿Qué dijo el usuario sobre este proyecto hace tres sesiones?" La memoria semántica es conocimiento fáctico almacenado externamente, incluidas definiciones, relaciones entre entidades y hechos de dominios específicos en los que no se entrenó el modelo. Aquí es donde se alimenta su canal RAG (más sobre esto en la siguiente capa). La memoria procedimental codifica flujos de trabajo y patrones de uso de herramientas, comportamientos repetibles que el agente siempre debe seguir. Esto reside en el indicador del sistema o en un archivo de instrucciones controlado por versión y da forma a cada respuesta que produce el agente.
A continuación se explica cómo implementar la memoria de trabajo y episódica juntas utilizando el patrón recomendado de LangChain para LangChain 0.3+:
Requisitos previos:
pip install langchain langchain-openai python-dotenv
pip install langchain langchain – openai python – dotenv
Cómo ejecutar: guarde como Memory.py, asegúrese de que su .env tenga OPENAI_API_KEY, luego ejecute python Memory.py
# memory.py
# Working memory + episodic memory for persistent agent context
# Uses the current LangChain 0.3+ pattern (legacy ConversationBufferMemory is deprecated)
import os
import json
from datetime import datetime
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, AIMessage, SystemMessage, trim_messages
load_dotenv()
llm = ChatOpenAI(
model=”gpt-5.5″,
temperature=0.2,
api_key=os.getenv(“OPENAI_API_KEY”)
)
# ── EPISODIC MEMORY STORE ─────────────────────────────────────────────────────
# In production, replace this list with a database (SQLite, Postgres, Redis).
# The structure here: each episode is a dict with timestamp, user input, and agent response.
episodic_store: list[dict] =[]def save_episode(user_input: str, agent_response: str) -> Ninguno: """Guardar una conversación y pasar a la tienda de episodios.""" episodic_store.append({ "timestamp": datetime.now().isoformat(), "user": user_input, "agent": agent_response }) def load_recent_episodes(n: int = 5) -> str: """Recupera los últimos N episodios como una cadena formateada para insertarla en el contexto.""" si no es episodic_store: devuelve "Sin historial de conversaciones anteriores". reciente = episodic_store[-n:] return "n".join( f"[{ep['timestamp']}] Usuario: {ep['user']} | Agente: {ep['agent']}" para ep en reciente) # ── MEMORIA DE TRABAJO (EN CONTEXTO) ─────────────────────── ──────────────────────── # Nosotros mismos administramos la lista de mensajes y la pasamos trim_messages # antes de cada llamada de LLM para permanecer dentro del límite de contexto del modelo. # max_tokens=4000 deja margen para la respuesta del modelo. memoria_de_trabajo: lista =[]def chat(user_input: str) -> str: """ Envía un mensaje al agente. El historial episódico se inyecta en el indicador del sistema. La memoria de trabajo se recorta antes de cada llamada para evitar el desbordamiento del contexto. """ # Inyecta memoria episódica en el indicador del sistema para que el modelo tenga un contexto a largo plazo system = SystemMessage(content=( "Eres un asistente útil y consciente del contexto.nn" "Historial de conversaciones recientes:n" f"{load_recent_episodes()}" )) # Agregar el nuevo mensaje de usuario a la memoria de trabajoworking_memory.append(HumanMessage(content=user_input)) # Recortar la memoria de trabajo para permanecer dentro de la ventana de contexto # Esto comprime los mensajes más antiguos en lugar de eliminarlos por completo trimmed = trim_messages(working_memory, max_tokens=4000, Strategy="last", # Conserva los mensajes más recientes token_counter=llm, # Usar el tokenizador del modelo para recuentos precisos include_system=True, enable_partial=False ) # Llame al modelo con contexto del sistema + memoria de trabajo recortada respuesta = llm.invoke([system] + trimmed) respuesta = respuesta.content # Guarde el intercambio en la memoria episódica y agregue la respuesta a la memoria de trabajo save_episode(user_input, respuesta)working_memory.append(AIMessage(content=reply)) return respuesta # ── DEMOSTRACIÓN ─────────────────────────────────── ─────────────────────────────────── if __name__ == "__main__": print(chat("Mi nombre es Alex y estoy construyendo un canal RAG para documentos legales.")) print(chat("¿Cuál es la mejor base de datos vectorial para mi caso de uso?")) print(chat("¿Qué te dije que estaba construyendo?")) # Prueba el recuerdo episódico
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
#memoria.py
# Memoria de trabajo + memoria episódica para contexto de agente persistente
# Utiliza el patrón LangChain 0.3+ actual (el ConversationBufferMemory heredado está obsoleto)
importar sistema operativo
importar json
desde fecha y hora importar fecha y hora
desde dotenv importar load_dotenv
desde langchain_openai importar ChatOpenAI
de langchain_core . los mensajes importan HumanMessage , mensaje de objetivo , mensaje del sistema , recortar_mensajes
cargar_dotenv ( )
llm = ChatOpenAI (
modelo = "gpt-5.5" ,
temperatura = 0,2 ,
api_key = sistema operativo . getenv ( "OPENAI_API_KEY" )
)
# ── TIENDA DE MEMORIA EPISODICA ────────────────────────── ───────────────────────────
# En producción, reemplace esta lista con una base de datos (SQLite, Postgres, Redis).
# La estructura aquí: cada episodio es un dictado con marca de tiempo, entrada del usuario y respuesta del agente.
tienda_episódica : lista [ dictar ] = [ ]
def guardar_episodio ( entrada_usuario : cadena , respuesta_agente : cadena ) -> Ninguno :
"" "Guarde una conversación y acceda a la tienda de episodios". ""
tienda_episódica . agregar ( {
"marca de tiempo" : fecha y hora . ahora ( ) . isoformato ( ) ,
"usuario" : entrada_usuario ,
"agente" : agente _ respuesta
} )
def cargar_episodios_recientes ( n : entero = 5 ) -> cadena :
"" "Recuperar los últimos N episodios como una cadena formateada para insertarla en contexto." ""
si no tienda_episódica :
devolver "Sin historial de conversaciones anteriores".
reciente = tienda_episódica [ -n : ]
devolver "n" . unirse (
f "[{ep['timestamp']}] Usuario: {ep['user']} | Agente: {ep['agent']}"
para episodio en reciente
)
# ── MEMORIA DE TRABAJO (EN CONTEXTO) ─────────────────────── ────────────────────────
# Gestionamos la lista de mensajes nosotros mismos y la pasamos a través de trim_messages
# antes de cada llamada de LLM para permanecer dentro del límite de contexto del modelo.
# max_tokens=4000 deja margen para la respuesta del modelo.
memoria_de_trabajo : lista = [ ]
def chat ( entrada_usuario : cadena ) -> cadena :
"" "
Envía un mensaje al agente.
El historial episódico se inyecta en el indicador del sistema.
La memoria de trabajo se recorta antes de cada llamada para evitar el desbordamiento del contexto.
" ""
# Inyectar memoria episódica en el indicador del sistema para que el modelo tenga un contexto a largo plazo
sistema = Mensaje del sistema ( contenido = (
"Eres un asistente útil y consciente del contexto.nn"
"Historial de conversaciones recientes:n"
f "{load_recent_episodes()}"
) )
# Agregar el mensaje del nuevo usuario a la memoria de trabajo
memoria_de_trabajo . agregar ( HumanMessage ( contenido = entrada_usuario ) )
# Recortar la memoria de trabajo para permanecer dentro de la ventana de contexto
# Esto comprime los mensajes más antiguos en lugar de eliminarlos por completo
recortado = recortar_mensajes (
memoria_de_trabajo ,
tokens_max = 4000 ,
estrategia = "última" , # Mantener los mensajes más recientes
token_counter = llm , # Utilice el tokenizador del modelo para realizar recuentos precisos
incluir_sistema = Verdadero ,
permitir_partial = Falso
)
# Llamar al modelo con contexto del sistema + memoria de trabajo recortada
respuesta = llm . invocar ( [ sistema ] + recortado )
responder = respuesta . contenido
# Guarde el intercambio en la memoria episódica y agregue la respuesta a la memoria de trabajo
guardar_episodio ( entrada_usuario , responder )
memoria_de_trabajo . agregar ( AIMessage ( contenido = respuesta ) )
devolver responder
# ── DEMOSTRACIÓN ─────────────────────────────────── ───────────────────────────────────
si __nombre__ == "__principal__" :
print ( chat ( "Mi nombre es Alex y estoy construyendo un canal RAG para documentos legales." ) )
print ( chat ( "¿Cuál es la mejor base de datos vectorial para mi caso de uso?" ) )
print ( chat ( "¿Qué te dije que estaba construyendo?" ) ) # Pruebas de recuerdo episódico
Qué hace esto: episodic_store actúa como un registro persistente liviano que se resume en el mensaje del sistema en cada llamada. La listaworking_memory contiene el historial de mensajes durante la sesión y trim_messages la recorta antes de cada llamada de LLM para evitar el desbordamiento del token. La pregunta final de la prueba: "¿Qué te dije que estaba construyendo?" verifica que la recuperación episódica funcione correctamente incluso después de que la ventana de contexto haya avanzado.
Capa 4: Bases de datos y recuperación de vectores (RAG)
Los modelos de cimientos saben mucho, pero no conocen sus documentos. No recibieron capacitación sobre su base de conocimientos interna, su historial de atención al cliente, su investigación patentada ni nada de lo que haya sucedido desde que finalizaron su capacitación. La generación aumentada de recuperación (RAG) es la forma de solucionar este problema.
El concepto es sencillo: en lugar de intentar incluir una base de conocimientos completa en la ventana contextual, convierte sus documentos en representaciones numéricas (incrustaciones), los almacena en una base de datos vectorial y recupera solo los fragmentos más relevantes en el momento de la consulta. El agente obtiene una ventana contextual llena precisamente de la información correcta en lugar de todo lo que usted haya escrito.
El mercado mundial de bases de datos vectoriales alcanzó los 3.200 millones de dólares en 2025 y está creciendo a un ritmo del 24% anual, lo que refleja cuán central se ha vuelto la recuperación para los sistemas de producción de inteligencia artificial.
Cada una de las opciones principales sirve para un caso de uso diferente:
Pinecone se gestiona completamente sin gastos generales de infraestructura. Usted paga por ello, le envía vectores y lo consulta. Con 100 millones de vectores, mantiene la recuperación sin ajuste. La elección correcta cuando quieres realizar envíos y no pensar en infraestructura. Weaviate es de código abierto con una opción de nube administrada y lidera el campo de la búsqueda híbrida que combina similitud de vectores, concordancia de palabras clave (BM25) y filtrado de metadatos en una sola consulta. Si sus necesidades de recuperación requieren algo más que una búsqueda semántica pura, Weaviate lo maneja de forma nativa. Chroma es una prioridad para los desarrolladores y se ejecuta localmente sin infraestructura. La reescritura de Rust de 2025 lo hizo significativamente más rápido. Es la elección correcta para la creación de prototipos y cargas de trabajo de producción pequeñas y medianas donde la experiencia del desarrollador importa más que la escala. pgvector es una extensión de PostgreSQL que agrega búsqueda de vectores a una base de datos que quizás ya esté ejecutando. Si su equipo ya ejecuta Postgres, pgvector es el camino de menor fricción hacia RAG de producción. Maneja millones de vectores con indexación HNSW y se mantiene dentro de los límites de PostgreSQL de un solo nodo para la mayoría de las cargas de trabajo de producción.

Un diagrama de flujo horizontal de tres pasos que muestra el proceso RAG: Documentos → Modelo de incrustaciones → Base de datos vectorial (haga clic para ampliar)
Aquí hay una canalización RAG en funcionamiento que utiliza incrustaciones de Chroma y OpenAI.
Requisitos previos:
pip install langchain langchain-openai langchain-chroma langchain-text-splitters chromadb python-dotenv
pip install langchain langchain – openai langchain – chroma langchain – text – splitters chromadb python – dotenv
Cómo ejecutarlo: guarde como rag_pipeline.py, agregue OPENAI_API_KEY a su .env y luego ejecute python rag_pipeline.py.
# rag_pipeline.py
# Minimal RAG pipeline: ingest documents → embed → store in Chroma → retrieve and answer
# Python 3.10+ | ChromaDB 0.5+ | LangChain 0.3+
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain_chroma import Chroma
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_core.documents import Document
from langchain_core.prompts import ChatPromptTemplate
load_dotenv()
# ── STEP 1: SAMPLE DOCUMENTS ──────────────────────────────────────────────────
# Replace this list with real documents from your knowledge base.
# In production, load from PDFs, databases, APIs, or file systems.
documents = [
Document(page_content=”Pinecone is a managed vector database optimized for fast, “
“low-latency similarity search at scale. It handles infrastructure automatically “
“and is best for production RAG when you don’t want to manage servers.”,
metadata={“source”: “vector_db_guide”, “topic”: “pinecone”}),
Document(page_content=”Weaviate is an open-source vector database with native hybrid search “
“support, combining BM25 keyword search with dense vector search in a single query. “
“It can be self-hosted or used via Weaviate Cloud.”,
metadata={“source”: “vector_db_guide”, “topic”: “weaviate”}),
Document(page_content=”Chroma is a developer-friendly, local-first vector database ideal for “
“prototyping. The 2025 Rust rewrite significantly improved performance. “
“Best for small-to-medium production workloads and local development.”,
metadata={“source”: “vector_db_guide”, “topic”: “chroma”}),
Document(page_content=”pgvector is a PostgreSQL extension that adds vector similarity search “
“to an existing Postgres database. With HNSW indexing, it handles millions of vectors “
“at low latency. Best choice if your team already runs PostgreSQL in production.”,
metadata={“source”: “vector_db_guide”, “topic”: “pgvector”}),
]
# ── STEP 2: CHUNK THE DOCUMENTS ───────────────────────────────────────────────
# Large documents are split into smaller chunks before embedding.
# chunk_size=500 characters; chunk_overlap=50 preserves context across chunk boundaries.
splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
chunks = splitter.split_documents(documents)
# ── STEP 3: EMBED AND STORE IN CHROMA ────────────────────────────────────────
# OpenAIEmbeddings converts each chunk into a high-dimensional vector.
# Chroma stores those vectors locally in the ./chroma_db directory.
# On subsequent runs, the existing store is loaded rather than rebuilt.
embeddings = OpenAIEmbeddings(
model=”text-embedding-3-small”, # Fast and cost-effective for most RAG tasks
api_key=os.getenv(“OPENAI_API_KEY”)
)
vectorstore = Chroma.from_documents(
documents=chunks,
embedding=embeddings,
persist_directory=”./chroma_db” # Persist to disk so you don’t re-embed on every run
)
# ── STEP 4: RETRIEVAL ──────────────────────────────────────────────────────────
# Converts the query into an embedding and finds the most similar chunks.
# k=3 returns the top 3 most relevant chunks.
retriever = vectorstore.as_retriever(search_kwargs={“k”: 3})
# ── STEP 5: GENERATION ────────────────────────────────────────────────────────
llm = ChatOpenAI(
model=”gpt-5.5″,
temperature=0,
api_key=os.getenv(“OPENAI_API_KEY”)
)
# The prompt tells the model to use only the retrieved context.
# This prevents the model from hallucinating facts not in your knowledge base.
rag_prompt = ChatPromptTemplate.from_messages([
(“system”,
“Answer the question using only the provided context. “
“If the answer isn’t in the context, say so clearly.nn”
“Context:n{context}”),
(“human”, “{question}”)
])
def answer(question: str) -> str:
“””Retrieve relevant chunks and generate a grounded answer.”””
# Retrieve the most relevant document chunks for this question
retrieved_docs = retriever.invoke(question)
# Combine the retrieved chunks into a single context block
context = “nn”.join(doc.page_content for doc in retrieved_docs)
# Build and invoke the prompt with the question and retrieved context
prompt = rag_prompt.invoke({“context”: context, “question”: question})
response = llm.invoke(prompt)
return response.content
# ── DEMO ──────────────────────────────────────────────────────────────────────
if __name__ == “__main__”:
q = “Which vector database should I use if I already run PostgreSQL?”
print(f”Q: {q}nA: {answer(q)}”)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
#rag_pipeline.py
# Canalización RAG mínima: ingerir documentos → incrustar → almacenar en Chroma → recuperar y responder
#Python 3.10+ | ChromaDB 0.5+ | LangChain 0.3+
importar sistema operativo
desde dotenv importar load_dotenv
desde langchain_openai importar ChatOpenAI , Incrustaciones de OpenAI
de langchain_chroma importar croma
de langchain_text_splitters importar RecursiveCharacterTextSplitter
de langchain_core . importar documentos Documento
de langchain_core . solicita importar ChatPromptTemplate
cargar_dotenv ( )
# ── PASO 1: DOCUMENTOS DE MUESTRA ───────────────────────── ─────────────────────────
# Reemplace esta lista con documentos reales de su base de conocimientos.
# En producción, cargue desde archivos PDF, bases de datos, API o sistemas de archivos.
documentos = [
Documento ( page_content = "Pinecone es una base de datos vectorial administrada optimizada para velocidad, "
"Búsqueda de similitudes de baja latencia a escala. Maneja la infraestructura automáticamente"
"y es mejor para RAG de producción cuando no se desean administrar servidores". ,
metadatos = { "fuente" : "vector_db_guide" , "tema" : "piña" } ) ,
Documento ( page_content = "Weaviate es una base de datos vectorial de código abierto con búsqueda híbrida nativa "
"Soporte, combinando la búsqueda de palabras clave BM25 con la búsqueda de vectores densos en una sola consulta".
"Puede alojarse usted mismo o utilizarse a través de Weaviate Cloud". ,
metadatos = { "fuente" : "vector_db_guide" , "tema" : "tejer" } ) ,
Documento ( page_content = "Chroma es una base de datos vectorial local y fácil de usar para desarrolladores, ideal para "
"creación de prototipos. La reescritura de Rust de 2025 mejoró significativamente el rendimiento".
"Lo mejor para cargas de trabajo de producción pequeñas y medianas y desarrollo local". ,
metadatos = { "fuente" : "vector_db_guide" , "tema" : "croma" } ) ,
Documento ( page_content = "pgvector es una extensión de PostgreSQL que agrega búsqueda por similitud de vectores "
"a una base de datos de Postgres existente. Con la indexación HNSW, maneja millones de vectores "
"con baja latencia. La mejor opción si su equipo ya ejecuta PostgreSQL en producción". ,
metadatos = { "fuente" : "vector_db_guide" , "tema" : "pgvector" } ) ,
]
# ── PASO 2: ROMPER LOS DOCUMENTOS ─────────────────────── ────────────────────────
# Los documentos grandes se dividen en partes más pequeñas antes de incrustarlos.
# trozo_size=500 caracteres; chunk_overlap=50 preserva el contexto a través de los límites de los fragmentos.
disidente = RecursiveCharacterTextSplitter ( tamaño_fragmento = 500 , trozo_superposición = 50 )
trozos = divisor . split_documents ( documentos )
# ── PASO 3: INTEGRAR Y ALMACENAR EN CHROMA ──────────────────── ────────────────────
# OpenAIEmbeddings convierte cada fragmento en un vector de alta dimensión.
# Chroma almacena esos vectores localmente en el directorio ./chroma_db.
# En ejecuciones posteriores, la tienda existente se carga en lugar de reconstruirse.
incrustaciones = Incrustaciones OpenAI (
modelo = "incrustación de texto-3-pequeño" , # Rápido y rentable para la mayoría de las tareas RAG
api_key = sistema operativo . getenv ( "OPENAI_API_KEY" )
)
tienda de vectores = Croma . de_documentos (
documentos = fragmentos ,
incrustaciones = incrustaciones ,
persist_directory = "./chroma_db" # Persistir en el disco para no volver a incrustarlo en cada ejecución
)
# ── PASO 4: RECUPERACIÓN ───────────────────────────── ─────────────────────────────
# Convierte la consulta en una incrustación y encuentra los fragmentos más similares.
# k=3 devuelve los 3 fragmentos más relevantes.
perdiguero = tienda de vectores . as_retriever ( search_kwargs = { "k" : 3 } )
# ── PASO 5: GENERACIÓN ──────────────────────────── ────────────────────────────
llm = ChatOpenAI (
modelo = "gpt-5.5" ,
temperatura = 0 ,
api_key = sistema operativo . getenv ( "OPENAI_API_KEY" )
)
# El mensaje le dice al modelo que use solo el contexto recuperado.
# Esto evita que el modelo alucine con hechos que no están en su base de conocimientos.
rag_prompt = Plantilla de solicitud de chat . de_mensajes ( [
( "sistema" ,
"Responda la pregunta utilizando sólo el contexto proporcionado".
"Si la respuesta no está en el contexto, dígalo claramente.nn"
"Contexto:n{contexto}" ) ,
( "humano" , "{pregunta}" )
] )
respuesta definitiva ( pregunta : cadena ) -> cadena :
"" "Recupera fragmentos relevantes y genera una respuesta fundamentada." ""
# Recuperar los fragmentos de documentos más relevantes para esta pregunta
documentos_recuperados = perro perdiguero . invocar ( pregunta )
# Combina los fragmentos recuperados en un único bloque de contexto
contexto = "nn" . unirse ( doc . page_content para doctor en documentos_recuperados )
# Construir e invocar el mensaje con la pregunta y el contexto recuperado
inmediato = rag_prompt . invocar ( { "contexto" : contexto , "pregunta" : pregunta } )
respuesta = llm . invocar ( indicar )
devolver respuesta . contenido
# ── DEMOSTRACIÓN ─────────────────────────────────── ───────────────────────────────────
si __nombre__ == "__principal__" :
q = "¿Qué base de datos vectorial debo usar si ya ejecuto PostgreSQL?"
imprimir ( f "Q: {q}nA: {respuesta(q)}" )
Qué hace esto: El oleoducto tiene dos fases. Durante la indexación, los documentos se fragmentan, se convierten en incrustaciones a través del modelo text-embedding-3-small de OpenAI y se almacenan en una base de datos Chroma local. Durante la recuperación, la consulta se incrusta usando el mismo modelo, los tres fragmentos más similares se extraen de Chroma y el LLM usa esos fragmentos y solo esos fragmentos para responder. El parámetro persist_directory significa que Chroma guarda los vectores en el disco, por lo que no paga para volver a incrustar sus documentos en cada ejecución.
Capa 5: Herramientas e integraciones externas
Un agente sin herramientas es un predictor de texto muy caro. Las herramientas son las que dan a los agentes la capacidad de actuar sobre el mundo en lugar de limitarse a hablar de él.
En términos técnicos, una herramienta es una función que el modelo puede elegir llamar. Usted describe lo que hace la función en lenguaje natural, define sus parámetros de entrada con un esquema y el modelo decide cuándo llamar a esa función le ayudaría a responder la pregunta. El modelo no ejecuta la función; tu código lo hace. El modelo simplemente decide cuándo y con qué argumentos.
Las categorías de herramientas que más importan en los agentes de producción son: búsqueda web (para información actual), ejecución de código (para cálculo y procesamiento de datos), E/S de archivos (para leer y escribir documentos), llamadas API (para conectarse a servicios externos) y uso del navegador (para interactuar con interfaces web que no tienen API).
Un desarrollo que vale la pena comprender es el Protocolo de contexto de modelo (MCP), introducido por Anthropic a finales de 2024. MCP es una forma estandarizada para que los modelos se comuniquen con herramientas y fuentes de datos externas. En lugar de que cada equipo escriba un código de integración personalizado para cada herramienta, MCP proporciona un protocolo compartido. Amazon Bedrock Agents agregó soporte nativo de MCP en 2025 y la adopción en todo el ecosistema está creciendo rápidamente.
Lo más importante en el diseño de herramientas es el esquema. El modelo decide si utilizar una herramienta en función de su descripción y decide qué argumentos pasar en función del esquema de parámetros. Una descripción vaga produce llamadas de herramientas incorrectas. Un esquema bien tipificado con descripciones claras de los parámetros produce esquemas confiables.
Requisitos previos:
pip install langchain langchain-openai langchain-community python-dotenv
pip instalar langchain langchain – openai langchain – comunidad python – dotenv
Cómo ejecutar: guarde como tools.py, agregue OPENAI_API_KEY a su .env y luego ejecute python tools.py
# tools.py
# Defining, registering, and using tools with a LangChain agent
# Python 3.10+ | LangChain 0.3+
import os
import json
import requests
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langchain.tools import tool
from langchain_community.tools import DuckDuckGoSearchRun
from langchain_core.messages import HumanMessage
from langgraph.prebuilt import create_react_agent
load_dotenv()
llm = ChatOpenAI(model=”gpt-5.5″, temperature=0, api_key=os.getenv(“OPENAI_API_KEY”))
# ── TOOL 1: WEB SEARCH ────────────────────────────────────────────────────────
# Built-in DuckDuckGo tool — no API key needed.
search = DuckDuckGoSearchRun()
# ── TOOL 2: WEATHER LOOKUP ────────────────────────────────────────────────────
# The @tool decorator does three things:
# 1. Registers the function as a callable tool
# 2. Uses the function name as the tool name
# 3. Uses the docstring as the tool description (this is what the model reads)
# The description is critical — vague descriptions cause wrong tool calls.
@tool
def get_weather(city: str) -> str:
“””
Fetch the current weather for a given city.
Use this when the user asks about weather conditions, temperature, or forecasts.
Input: city name as a string (e.g., ‘London’, ‘Tokyo’, ‘New York’).
“””
try:
# Using open-meteo (free, no API key) for geocoding and weather
geo_url = f”https://geocoding-api.open-meteo.com/v1/search?name={city}&count=1″
geo = requests.get(geo_url, timeout=5).json()
if not geo.get(“results”):
return f”Could not find location data for ‘{city}’.”
lat = geo[“results”][0]["latitud"] lon = geo["resultados"][0]["longitud"] tiempo_url = ( f"https://api.open-meteo.com/v1/forecast" f"?latitude={lat}&longitude={lon}" f"¤t_weather=true" ) tiempo = request.get(weather_url, timeout=5).json() actual = tiempo.get("tiempo_actual", {}) return ( f"Tiempo en {ciudad}: " f"{current.get('temperature', 'N/A')}°C, " f"wind speed {current.get('windspeed', 'N/A')} km/h." ) excepto Excepción como e: # Siempre devuelve una cadena de las herramientas, incluso en caso de falla. # Generar excepciones desde las herramientas puede bloquear el ciclo del agente. return f"Error en la búsqueda del clima para '{ciudad}': {str(e)}" # ── HERRAMIENTA 3: CALCULADORA JSON ───────────────────────── ────────────────────────── @tool def calcular(expresión: str) -> str: """ Evalúa una expresión matemática y devuelve el resultado. Utilízalo para aritmética, cálculos porcentuales o cualquier cálculo numérico. Entrada: una expresión matemática de Python válida como una cadena (p. ej., '(150 * 1.08) / 12'). NO lo utilices para la ejecución de código complejo, solo expresiones matemáticas simples. """ prueba: # eval tiene un alcance que solo permite matemáticas, sin componentes integrados, sin importaciones resultado = eval(expresión, {"__builtins__": {}}, {}) return f"Resultado: {resultado}" excepto Excepción como e: return f"Error de cálculo: {str(e)}" # ── REGISTRAR HERRAMIENTAS Y AGENTE DE CONSTRUCCIÓN ────────────────────── ────────────────────── herramientas = [buscar, obtener_clima, calcular] agente = crear_react_agent(llm, herramientas) # ── DEMO ─────────────────────────────────── ─────────────────────────────────── if __name__ == "__main__": queries = [ "¿Cuál es el clima en Lagos en este momento?", "Si gano 85.000 dólares al año, ¿cuál es mi salario bruto mensual?", "¿Quién ganó la Copa Mundial de la FIFA más reciente?" ] para consulta en consultas: print(f"nQuery: {consulta}") resultado = agent.invoke({"messages": [HumanMessage(content=query)]}) print(f"Respuesta: {resultado['messages'][-1].content}")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
# herramientas.py
# Definición, registro y uso de herramientas con un agente LangChain
#Python 3.10+ | LangChain 0.3+
importar sistema operativo
importar json
solicitudes de importación
desde dotenv importar load_dotenv
desde langchain_openai importar ChatOpenAI
de cadena larga . herramienta de importación de herramientas
de langchain_community . herramientas de importación DuckDuckGoSearchRun
de langchain_core . importar mensajes HumanMessage
de langgraph . importación prediseñada create_react_agent
cargar_dotenv ( )
llm = ChatOpenAI ( modelo = "gpt-5.5" , temperatura = 0 , api_key = sistema operativo . getenv ( "OPENAI_API_KEY" ) )
# ── HERRAMIENTA 1: BÚSQUEDA WEB ──────────────────────────── ────────────────────────────
# Herramienta DuckDuckGo incorporada: no se necesita clave API.
buscar = DuckDuckGoSearchEjecutar ( )
# ── HERRAMIENTA 2: BÚSQUEDA DEL TIEMPO ────────────────────────── ──────────────────────────
# El decorador @tool hace tres cosas:
# 1. Registra la función como una herramienta invocable.
# 2. Utiliza el nombre de la función como nombre de la herramienta.
# 3. Utiliza la cadena de documentación como descripción de la herramienta (esto es lo que lee el modelo)
# La descripción es fundamental: las descripciones vagas provocan llamadas incorrectas a las herramientas.
@ herramienta
def get_weather ( ciudad : cadena ) -> cadena :
"" "
Obtenga el clima actual de una ciudad determinada.
Úselo cuando el usuario pregunte sobre las condiciones climáticas, la temperatura o los pronósticos.
Entrada: nombre de la ciudad como una cadena (por ejemplo, 'Londres', 'Tokio', 'Nueva York').
" ""
intentar :
# Uso de open-meteo (gratis, sin clave API) para geocodificación y clima
geo_url = f "https://geocoding-api.open-meteo.com/v1/search?name={ciudad}&count=1"
geo = solicitudes . obtener ( geo_url , tiempo de espera = 5 ) . json ( )
si no geo . obtener ( "resultados" ) :
devolver f "No se pudieron encontrar datos de ubicación para '{ciudad}'".
latitud = geo [ "resultados" ] [ 0 ] [ "latitud" ]
lon = geo [ "resultados" ] [ 0 ] [ "longitud" ]
URL del tiempo = (
f "https://api.open-meteo.com/v1/forecast"
f "?latitud={lat}&longitud={lon}"
f "&clima_actual=verdadero"
)
clima = solicitudes . obtener ( meteo_url , tiempo de espera = 5 ) . json ( )
actual = clima . obtener ( "clima_actual" , { } )
devolver (
f "Clima en {ciudad}: "
f "{current.get('temperatura', 'N/A')}°C, "
f "velocidad del viento {current.get('windspeed', 'N/A')} km/h."
)
excepto excepción como mi :
# Siempre devuelve una cadena de las herramientas, incluso en caso de falla.
# Generar excepciones desde las herramientas puede bloquear el ciclo del agente.
devolver f "Falló la búsqueda del clima para '{ciudad}': {str(e)}"
# ── HERRAMIENTA 3: CALCULADORA JSON ───────────────────────── ──────────────────────────
@ herramienta
def calcular ( expresión : cadena ) -> cadena :
"" "
Evalúa una expresión matemática y devuelve el resultado.
Úselo para aritmética, cálculos porcentuales o cualquier cálculo numérico.
Entrada: una expresión matemática de Python válida como una cadena (por ejemplo, '(150 * 1.08) / 12').
NO lo use para ejecución de código complejo, solo expresiones matemáticas simples.
" ""
intentar :
# eval tiene como alcance solo permitir matemáticas: sin elementos integrados ni importaciones
resultado = evaluar ( expresión , { "__integraciones__" : { } } , { } )
devolver f "Resultado: {resultado}"
excepto excepción como mi :
devolver f "Error de cálculo: {str(e)}"
# ── REGISTRAR HERRAMIENTAS Y CONSTRUIR AGENTE ────────────────────── ──────────────────────
herramientas = [ buscar , obtener_clima , calcular ]
agente = create_react_agent ( llm , herramientas )
# ── DEMOSTRACIÓN ─────────────────────────────────── ───────────────────────────────────
si __nombre__ == "__principal__" :
consultas = [
"¿Cuál es el clima en Lagos en este momento?" ,
"Si gano 85.000 dólares al año, ¿cuál es mi salario bruto mensual?" ,
"¿Quién ganó la Copa Mundial de la FIFA más reciente?"
]
para consulta en consultas :
imprimir ( f "nConsulta: {consulta}" )
resultado = agente . invocar ( { "mensajes" : [ HumanMessage ( contenido = consulta ) ] } )
print ( f "Respuesta: {resultado['mensajes'][-1].content}" )
Qué hace esto: Se registran tres herramientas: una herramienta de búsqueda web para eventos actuales, una herramienta meteorológica que llama a una API gratuita sin necesidad de clave y una calculadora que evalúa de forma segura expresiones matemáticas. El agente recibe cada consulta, razona sobre qué herramienta utilizar, la llama y sintetiza una respuesta a partir del resultado. El detalle de diseño clave a tener en cuenta está en las cadenas de documentación; La descripción de cada herramienta es precisa sobre lo que hace la herramienta, cuándo usarla y qué formato debe tomar la entrada.
Capa 6: Observabilidad y Evaluación
Aquí hay una verdad sobre producción que no se dice lo suficiente: los LLM fracasan silenciosamente. Como lo expresó el equipo de Kanerika, una respuesta alucinada aún devuelve HTTP 200. Una herramienta de monitoreo de infraestructura estándar detecta una solicitud exitosa. No ves nada inusual. Mientras tanto, su agente lleva tres días dando respuestas erróneas con confianza.
El monitoreo tradicional se creó para un mundo donde "correcto" es binario: la función devolvió el tipo correcto, la API devolvió 200 y la consulta se completó en menos de 100 ms. La corrección del LLM es semántica. La respuesta puede ser estructuralmente válida, gramaticalmente fluida y completamente incorrecta. Eso requiere una capa de observabilidad completamente diferente.
Hay tres cosas que una buena configuración de observabilidad de LLM rastrea. El seguimiento sigue cada paso de la ejecución del agente: las llamadas LLM, las invocaciones de herramientas, las consultas de recuperación, los pasos de razonamiento intermedios y cuánto tiempo tomó cada uno. La evaluación califica el resultado en función de métricas que importan: fidelidad (¿se mantuvo firme en el contexto recuperado?), relevancia (¿respondió a la pregunta formulada?) y tasa de alucinaciones. El monitoreo rastrea la variación del comportamiento a lo largo del tiempo, ya sea que el desempeño del agente en una clase determinada de entradas mejore o empeore a medida que el modelo y las indicaciones evolucionan.
Cada una de las plataformas líderes tiene una fuerza diferente. LangSmith proporciona la integración más profunda con LangChain y LangGraph. Si ya estás en ese ecosistema, es el camino más rápido para trabajar con rastros. Langfuse es de código abierto con más de 19.000 estrellas de GitHub y una licencia MIT, autohospedable y funciona con cualquier marco. Arize Phoenix aporta rigor de evaluación de grado ML y se entrega con más de 50 métricas respaldadas por investigaciones que cubren fidelidad, relevancia, seguridad y detección de alucinaciones.
Según el análisis de plataformas de observabilidad de MLflow, la elección correcta a menudo depende de su marco: los equipos de LangChain aprovechan al máximo LangSmith, mientras que los equipos en LlamaIndex o llamadas API sin procesar reciben mejor servicio de Phoenix o Langfuse.
A continuación se explica cómo agregar el rastreo de Langfuse a un agente existente con cambios mínimos.
Requisitos previos:
pip install langfuse langchain langchain-openai python-dotenv
pip install langfuse langchain langchain – openai python – dotenv
Regístrese en langfuse.com para obtener una cuenta gratuita y agregue LANGFUSE_PUBLIC_KEY y LANGFUSE_SECRET_KEY a su .env. El autohospedaje también está disponible si prefiere mantener los datos en su propia infraestructura.
Cómo ejecutarlo: guarde como observability.py y ejecute python observability.py. Abra su panel de Langfuse para ver el seguimiento.
# observability.py
# Adding Langfuse tracing to a LangChain agent
# Langfuse captures every LLM call, tool invocation, and token count automatically.
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langchain_community.tools import DuckDuckGoSearchRun
from langchain_core.messages import HumanMessage
from langgraph.prebuilt import create_react_agent
# Langfuse integrates via the CallbackHandler pattern.
# It intercepts every LangChain event and sends it to your Langfuse dashboard.
from langfuse.langchain import CallbackHandler
load_dotenv()
# ── LANGFUSE SETUP ─────────────────────────────────────────────────────────────
# CallbackHandler reads LANGFUSE_PUBLIC_KEY and LANGFUSE_SECRET_KEY from the environment.
# session_id groups all related traces into one session — useful for debugging conversations.
# user_id ties traces to a specific user for per-user performance analysis.
langfuse_handler = CallbackHandler(
session_id=”demo_session_001″,
user_id=”demo_user”
)
# ── AGENT SETUP ────────────────────────────────────────────────────────────────
llm = ChatOpenAI(
model=”gpt-5.5″,
temperature=0,
api_key=os.getenv(“OPENAI_API_KEY”),
callbacks=[langfuse_handler] # Attach the handler here — this is the only change
)
tools = [DuckDuckGoSearchRun()]
agent = create_react_agent(llm, tools)
# ── RUN WITH TRACING ──────────────────────────────────────────────────────────
# Pass the handler in config so it traces tool calls as well as LLM calls.
# Without this, only the LLM calls are traced — tool invocations are invisible.
result = agent.invoke(
{“messages”: [HumanMessage(content=”What is the latest version of Python?”)]},
config={“callbacks”: [langfuse_handler]}
)
print(result[“messages”][-1].content)
# Flush ensures all traces are sent to Langfuse before the script exits.
# In a long-running server, this is handled automatically.
langfuse_handler.flush()
print(“nTrace sent to Langfuse. Check your dashboard at https://cloud.langfuse.com”)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
# observability.py
# Adding Langfuse tracing to a LangChain agent
# Langfuse captures every LLM call, tool invocation, and token count automatically.
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langchain_community . tools import DuckDuckGoSearchRun
de langchain_core . importar mensajes HumanMessage
de langgraph . importación prediseñada create_react _ agent
# Langfuse se integra mediante el patrón CallbackHandler.
# Intercepta cada evento de LangChain y lo envía a su panel de Langfuse.
de langfuse . importación de cadena langCallbackHandler
cargar_dotenv ( )
# ── CONFIGURACIÓN DE LANGFUSE ────────────────────────────── ───────────────────────────────
# CallbackHandler lee LANGFUSE_PUBLIC_KEY y LANGFUSE_SECRET_KEY del entorno.
# session_id agrupa todos los seguimientos relacionados en una sola sesión, lo que resulta útil para depurar conversaciones.
# user_id vincula los seguimientos a un usuario específico para el análisis de rendimiento por usuario.
langfuse_handler = Controlador de devolución de llamada (
session_id = "demo_session_001" ,
user_id = "usuario_demo"
)
# ── CONFIGURACIÓN DEL AGENTE ──────────────────────────────── ────────────────────────────────
llm = ChatOpenAI (
modelo = "gpt-5.5" ,
temperatura = 0 ,
api_key = sistema operativo . getenv ( "OPENAI_API_KEY" ) ,
devoluciones de llamada = [ langfuse_handler ] # Adjunte el controlador aquí: este es el único cambio
)
herramientas = [ DuckDuckGoSearchRun ( ) ]
agente = create_react_agent ( llm , herramientas )
# ── CORRE CON SEGUIMIENTO ───────────────────────────── ─────────────────────────────
# Pase el controlador en la configuración para que rastree las llamadas a herramientas y las llamadas LLM.
# Sin esto, solo se rastrean las llamadas de LLM; las invocaciones de herramientas son invisibles.
resultado = agente . invocar (
{ "mensajes" : [ HumanMessage ( content = "¿Cuál es la última versión de Python?" ) ] } ,
config = { "devoluciones de llamada" : [ langfuse_handler ] }
)
imprimir ( resultado [ " mensajes" ] [ -1 ] . contenido )
# Flush garantiza que todos los rastros se envíen a Langfuse antes de que finalice el script.
# En un servidor de larga ejecución, esto se maneja automáticamente.
langfuse_handler . rubor ( )
print ( "nSeguimiento enviado a Langfuse. Consulte su panel de control en https://cloud.langfuse.com" )
Qué hace esto: Dos cambios con respecto a la configuración de un agente estándar: CallbackHandler se inicializa con una sesión y un ID de usuario, y se adjunta tanto a la configuración LLM como a agent.invoke. Esto es suficiente para que Langfuse capture el seguimiento completo de cada llamada de LLM, cada invocación de herramienta, recuento de tokens, latencia y la entrada/salida completa en cada paso. Todo lo que necesita para depurar un fallo de producción o realizar un seguimiento de la variación de la calidad a lo largo del tiempo.
Capa 7: Infraestructura de implementación
Puedes tener un agente impecable en desarrollo que se convierta en un problema de mantenimiento en producción. La capa de infraestructura es donde reside esa brecha.
Como mínimo, su agente debe estar en contenedores con Docker. Los contenedores le brindan un comportamiento consistente en todos los entornos, una administración de dependencias sencilla y un camino limpio hacia cualquier objetivo de implementación en la nube. La alternativa (enviar scripts de Python con un archivo require.txt y esperar que el entorno coincida) crea una clase de errores que desperdician un tiempo de ingeniería desproporcionado con respecto al esfuerzo que habría requerido la contenedorización.
Para la mayoría de los agentes de producción, tiene dos opciones arquitectónicas para la capa de servicio: una API síncrona o una cola asíncrona. Una API sincrónica (Flask o FastAPI) funciona cuando su agente se completa en menos de unos segundos y usted puede darse el lujo de mantener abierta la conexión HTTP.
Cuando su agente involucra múltiples llamadas a herramientas, largos procesos de recuperación o procesamiento de documentos que pueden tardar de 30 a 60 segundos, una cola asíncrona (Celery, AWS SQS o Google Pub/Sub) es la mejor opción. El cliente envía un trabajo, obtiene un ID de tarea inmediatamente y sondea el resultado.
En el lado de la nube, las tres plataformas principales ahora cuentan con una infraestructura de agentes administrados. AgentCore de Amazon, que estuvo disponible de forma generalizada en octubre de 2025, proporciona una infraestructura agente dedicada en AWS para la gestión de memoria, la ejecución de herramientas y el manejo de sesiones sin aprovisionar servidores. Google Vertex AI Agent Builder es la elección natural para los equipos que ya están en el ecosistema de GCP, con integración nativa de Gemini y observabilidad incorporada. El servicio Azure OpenAI con Semantic Kernel es el valor predeterminado empresarial para las tiendas de Microsoft.
Para la gestión de costos, tres prácticas marcan la mayor diferencia: almacenamiento en caché (devolver respuestas almacenadas para consultas idénticas repetidas en lugar de llamar al modelo nuevamente), procesamiento por lotes de solicitudes (agrupar tareas no urgentes para reducir la sobrecarga por llamada) y configurar max_iterations en el ejecutor de su agente para evitar que los bucles fuera de control consuman tokens sin límites.
Un diagrama de pila vertical que muestra las 7 capas etiquetadas de arriba a abajo: modelo de base, marco de orquestación, sistemas de memoria, base de datos de vectores y RAG, herramientas e integraciones, observabilidad y evaluación, infraestructura de implementación (haga clic para ampliar)
Poniéndolo todo junto
Las elecciones correctas en cada capa dependen de dónde se encuentre en el ciclo de vida del proyecto. Aquí hay una referencia práctica que refleja la investigación y las compensaciones discutidas anteriormente.
Prototipo (mover rápido, infraestructura mínima):
Layer Choice Reason Foundation Model GPT-5.5 Llamada de herramientas confiable, ecosistema maduro Orquestación LangGraph Configuración rápida, buena documentación Memoria Solo en contexto No se necesita infraestructura Vector DB Chroma Local, sin operaciones, buena experiencia de desarrollador Herramientas DuckDuckGo + funciones @tool personalizadas No se requieren claves API Observabilidad Langfuse (nivel libre de nube) Configuración de una sola línea Despliegue Local/Docker Envío rápido
Puesta en producción (escala con control):
Layer Choice Reason Foundation Modelo GPT-5.5 + Claude Sonnet 4.6 alternativa Fiabilidad con redundancia Orquestación LangGraph o CrewAI Gestión de estado y soporte para múltiples agentes Memoria Episódica (Postgres) + Semántica (RAG) Contexto persistente completo Base de datos vectorial Weaviate o Pinecone Escala y búsqueda híbrida Herramientas Conjunto completo de herramientas con MCP Integraciones estandarizadas Observabilidad Langfuse autohospedado o Arize Phoenix Control de datos + evaluaciones de grado ML Implementación Docker + Kubernetes + cola asíncrona Grado de producción, con costes controlados
Empresa:
Capa Elección Razón Modelo básico Azure OpenAI o AWS Bedrock Cumplimiento, residencia de datos, orquestación SLA Kernel semántico o LangGraph Compatibilidad con lenguaje empresarial, gobernanza Memoria Memoria administrada con seguimiento de auditoría Requisitos reglamentarios Vector DB Weaviate o pgvector Autohospedable, listo para cumplir Herramientas Basado en MCP, aprobado internamente Revisión de seguridad y control de acceso Observabilidad Módulo Langfuse autohospedado o Datadog LLM Integración de infraestructura existente Implementación AWS AgentCore / Vertex AI Agent Builder Totalmente administrado gobernado, auditable
Conclusión
El modelo básico es la parte de esta pila sobre la que se escribe. Las otras seis capas son las partes que determinan si lo que construiste realmente funciona en producción.
Un agente falla en la capa de orquestación cuando el bucle ReAct se atasca. Falla en la capa de memoria cuando olvida el contexto que necesita. Falla en la capa de recuperación cuando se devuelven los fragmentos incorrectos y el modelo alucina una respuesta que suena fundamentada. Falla en la capa de herramientas cuando un esquema es demasiado vago y el modelo llama a la función incorrecta. Falla en la capa de observabilidad cuando no hay forma de saber que algo de esto está sucediendo. Y falla en la capa de implementación cuando la infraestructura no puede manejar la latencia o los requisitos de costos del tráfico real.
Gartner estima que más del 40% de los proyectos de inteligencia artificial agentes corren el riesgo de cancelarse para 2027 debido a un valor poco claro, costos crecientes y una gobernanza débil. La mayoría de esas fallas no se deben a una mala elección de modelo, sino a una pila que se construyó capa por capa sin una imagen clara de cómo se conectan las capas.
Comprender la pila completa no significa que tengas que construirla toda. Significa que usted sabe qué decisiones está tomando y qué está sacrificando cuando las toma. Esa es la diferencia entre un agente que trabaja en una demostración y uno que se envía.