
dedican gran parte de su tiempo a trabajar con datos tabulares. Tradicionalmente, estas cargas de trabajo se han ejecutado en CPU, lo que suele ser suficiente hasta que una operación costosa se convierte en un cuello de botella. Mientras tanto, gran parte del debate sobre las GPU se centra en el aprendizaje profundo y los grandes modelos de lenguaje. Hoy en día, sin embargo, la aceleración de GPU está disponible en gran parte de la pila de ciencia de datos de Python, lo que permite que muchos flujos de trabajo de datos tabulares existentes se ejecuten en GPU con pocos o ningún cambio de código.
Muchas discusiones sobre las GPU se centran en el aprendizaje profundo y los grandes modelos de lenguaje. Sin embargo, muchos científicos de datos todavía pasan la mayor parte de su tiempo trabajando con datos tabulares donde la mayoría de estas cargas de trabajo tradicionalmente se ejecutan en CPU. Esto suele estar bien hasta que una operación costosa se convierte en un cuello de botella. La siguiente ilustración captura esto de una manera alegre.
Hoy en día, la compatibilidad con GPU está disponible en gran parte de la pila de ciencia de datos de Python, lo que permite a los científicos de datos acelerar muchos flujos de trabajo existentes con pocos o ningún cambio de código. Esto reduce el tiempo dedicado a esperar a que finalicen operaciones costosas, lo que deja más tiempo para centrarse en resolver el problema real.
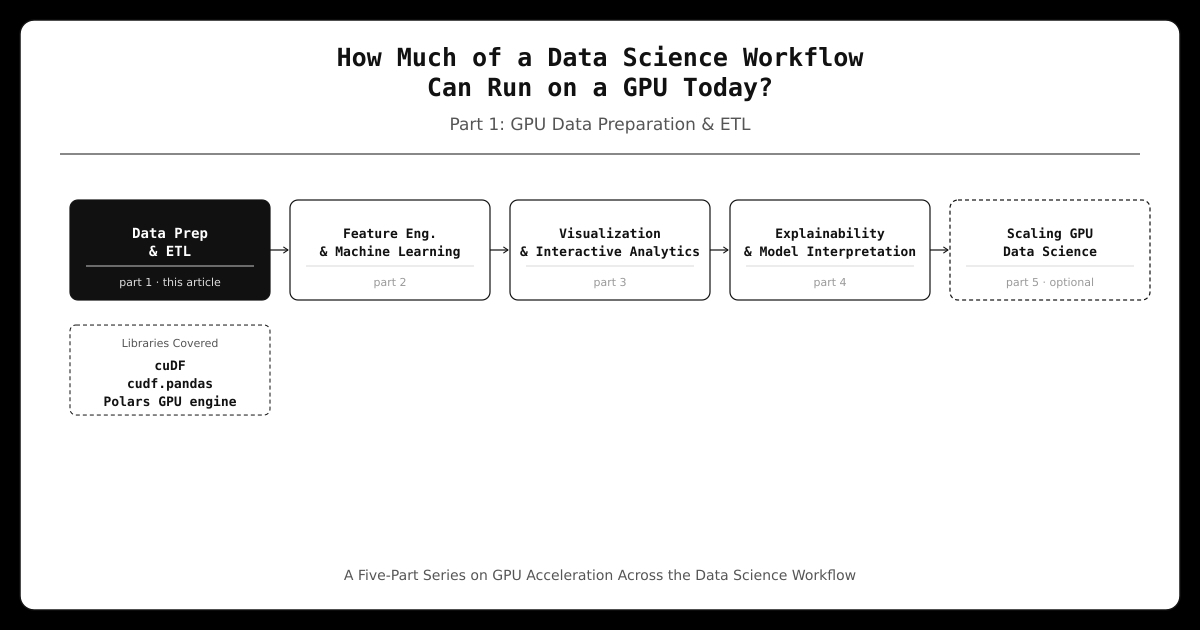
Decidí recorrer un proceso típico de aprendizaje automático paso a paso para ver dónde está disponible la aceleración de GPU en la actualidad y qué tan práctico es su uso. En esta serie, recorreré un proceso típico de aprendizaje automático paso a paso para ver dónde está disponible la aceleración de GPU en la actualidad, cuánto código debe cambiar y cuándo las CPU siguen siendo la mejor opción.
Comenzaremos con el procesamiento de datos tabulares y las tareas de preparación de datos que forman parte de muchos flujos de trabajo de ciencia de datos del día a día.
Conjunto de datos y código
A lo largo de este artículo, utilizaremos la base de datos de registros de viajes en taxi amarillo de Nueva York (licencia CCO). Contiene millones de viajes en taxi recopilados en la ciudad de Nueva York, con información como lugares de recogida y devolución, distancia del viaje, recuento de pasajeros, tarifas y marcas de tiempo. Para este artículo, solo usaremos los primeros tres meses, lo que nos da aproximadamente entre 9 y 10 millones de filas.
Para mantener los ejemplos enfocados, omití parte del código repetitivo y acorté algunos fragmentos. El código completo está disponible aquí.
Acelerando los flujos de trabajo de Pandas en GPU
Si su canal de procesamiento de datos está construido con pandas, hay dos formas sencillas de ejecutarlo en la GPU:

Trabajando directamente con la API nativa de cuDF. Acelerando el código pandas existente con cudf.pandas.
Veamos ambos enfoques.
1. Creación de flujos de trabajo nativos de GPU con la API cuDF
Si está iniciando un nuevo proyecto y desea trabajar directamente con GPU DataFrames, cuDF podría ser una excelente opción. Es parte de RAPIDS, el conjunto de bibliotecas de código abierto aceleradas por GPU de NVIDIA para ciencia y análisis de datos.
cuDF es una biblioteca Python GPU DataFrame para manipular datos tabulares utilizando una API similar a pandas. Entonces, si está familiarizado con los pandas, gran parte de la sintaxis le resultará familiar. Sin embargo, la diferencia es que, a diferencia de los pandas, cuDF ejecuta estas operaciones en la GPU en lugar de en la CPU. Sin embargo, algo a tener en cuenta es que, si bien cuDF sigue de cerca la API de pandas, no es un reemplazo completo, por lo que algunos comportamientos pueden diferir.
Instalación
Si utiliza Google Colab, cuDF ya está disponible en el tiempo de ejecución de la GPU. De lo contrario, instale el paquete cuDF que coincida con su versión CUDA instalada.
Puede verificar su versión de CUDA ejecutando:
!nvidia-smi
Por ejemplo, si su sistema informa CUDA 13.x, instale la compilación CUDA 13 de cuDF:
instalación de pip cudf-cu13
Consulte la guía de instalación para obtener la lista completa de opciones de instalación y versiones de CUDA compatibles.
Cargando datos en un marco de datos cuDF
Cargar datos en un cuDF DataFrame funciona igual que los pandas. En la mayoría de los casos, simplemente reemplaza pandas.read_* con la función cudf.read_* correspondiente. Así es como cargarías un archivo Parquet usando cuDF:
importar cudf taxi_url = 'https://d37ci6vzurychx.cloudfront.net/trip-data/amarillo_tripdata_2023-01.parquet' df_gpu = cudf.read_parquet(taxi_url) df_gpu.info()
Una vez que los datos se cargan en la memoria de la GPU, las operaciones posteriores de DataFrame se ejecutan en la GPU.
Trabajando con cuDF
cuDF admite muchas de las mismas operaciones que ya utiliza en pandas. Aquí hay algunos ejemplos comunes:
Seleccionar columnas
viajes = df_gpu[ [ "PULocationID", "DOLocationID", "fare_amount", "trip_distance", "tip_amount", ] ]
Filtrar filas
tarifa_alta = viajes[viajes["monto_tarifa"] > 20]
Creando nuevas columnas
viajes["percentaje_propina"] = (viajes["monto_propina"] / viajes["monto_tarifa"] * 100)
Estadísticas resumidas
viajes.describe()
Moviéndose entre pandas y cuDF
Muchos flujos de trabajo de ciencia de datos utilizan bibliotecas que solo admiten pandas. Puede mover datos fácilmente entre CPU y GPU DataFrames usando cuDF, cuando sea necesario.
Conversión de un DataFrame de pandas a cuDF:
df_gpu = cudf.from_pandas(df_cpu) print(tipo(df_gpu_converted)) —————————————
Convirtiendo un cuDF DataFrame nuevamente a pandas:
df_cpu = df_gpu.to_pandas( imprimir(tipo(df_cpu_converted)) —————————————
Estas conversiones son útiles cuando una biblioteca posterior solo admite pandas o cuando desea migrar un flujo de trabajo existente a la GPU.
Comparando pandas y cuDF
Para ver la diferencia de rendimiento en la práctica, ejecutemos el mismo análisis utilizando pandas y cuDF. Agruparemos los viajes por lugar de recogida y calcularemos el monto total de la tarifa, la distancia promedio del viaje y el recuento de viajes para cada lugar.
def resume_trips(df): return ( df.groupby("PULocationID") .agg( { "fare_amount": "suma", "trip_distance": "mean", "passenger_count": "count", } ) .sort_values("fare_amount", ascending=False) ) %time resumen_pd = resumen_viajes(df_cpu) %tiempo resumen_gpu = resumir_viajes(df_gpu)
El procesamiento de datos en el mundo real rara vez consiste en una sola operación. A menudo implica varias operaciones de DataFrame encadenadas. Como otra comparación, ejecutemos un flujo de trabajo más realista encontrando el lugar de entrega más común para cada lugar de recogida.
def run_chain(df): return ( df[["PULocationID", "DOLocationID"]] .value_counts() .reset_index(name="count") .sort_values( ["PULocationID", "count"], ascending=[True, False], ) .groupby("PULocationID") .head(1) .reset_index(drop=True) ) %time result_pd = run_chain(df_cpu) %tiempo result_gpu = run_chain(df_gpu)
Comparando agregaciones pesadas
Las agregaciones Groupby se encuentran entre las operaciones más comunes en los procesos de análisis y son muy adecuadas para la aceleración de GPU, ya que son costosas. Comparemos una agregación agrupada en varias columnas.
def agregado(df): return ( df.groupby("PULocationID") .agg( { "fare_amount": "suma", "trip_distance": "suma", "passenger_count": "count", } ) ) %tiempo agg_pd = agregado(df_cpu) %tiempo agg_gpu = agregado(df_gpu)
Incluso en este conjunto de datos, podemos ver una aceleración significativa y, en conjuntos de datos más grandes, estas cargas de trabajo de agregación pueden beneficiarse sustancialmente del paralelismo de GPU.
2. Acelerar el código pandas existente con cudf.pandas
¿Puedo acelerar mi código pandas existente sin reescribirlo?
Si bien la API cuDF nativa es una excelente opción para nuevos proyectos que priorizan la GPU, muchos flujos de trabajo de ciencia de datos existentes ya se basan en pandas y es un poco trabajo reescribir todo el código. Aquí es donde entra cudf.pandas. Es un modo acelerador integrado en cuDF que ayuda a acelerar el código de pandas sin ningún cambio en el código.
Habilitar el acelerador
Para habilitar la aceleración de GPU en una computadora portátil, cargue la extensión antes de importar pandas:
%load_ext cudf.pandas importar pandas como pd
Para scripts de Python, puedes escribir:
python −m cudf.pandas script.py
Es el mismo código pandas.
Usaremos los mismos datos y código de la sección anterior. El único cambio es incluir la línea %load_ext cudf.pandas en la parte superior, que habilita el acelerador.
%load_ext cudf.pandas importa pandas como pd taxi_url = 'https://d37ci6vzurychx.cloudfront.net/trip-data/amarillo_tripdata_2023-01.parquet' df = pd.read_parquet(taxi_url) resumen = ( df.groupby("PULocationID") .agg( { "fare_amount": "sum", "trip_distance": "mean", "passenger_count": "count", } ) .sort_values("fare_amount", ascending=False) ) resumen
Puede verificar que cudf.pandas esté activo imprimiendo el módulo pandas:
imprimir(pd) ————————————————-
Cada operación de pandas se intenta primero en la GPU usando cuDF. Si una operación no es compatible, cudf.pandas recurre automáticamente a pandas en la CPU.
Creación de perfiles de ejecución de GPU y CPU
En lugar de adivinar qué operaciones se ejecutaron en la GPU, cudf.pandas incluye un generador de perfiles integrado que informa la ejecución de la GPU y las fallas de la CPU.
%%cudf.pandas.profile resumen = ( df.groupby("pago_tipo") .fare_amount.mean() )
Una vez finalizada la celda, el generador de perfiles genera un informe que muestra qué operaciones se ejecutaron en la GPU y cuáles recayeron en la CPU.
Para un análisis más detallado, %%cudf.pandas.line_profile informa cuánto tiempo pasa ejecutándose cada línea de código en la GPU y la CPU.
%%cudf.pandas.line_profile resumen = ( df.groupby("pago_tipo") .fare_amount.mean() )
Trabajar con bibliotecas de terceros
Debido a que cudf.pandas conserva la API de pandas, muchas bibliotecas que funcionan con pandas también continúan funcionando sin modificaciones. Esto significa que una vez que los datos han sido procesados, se pueden pasar directamente a bibliotecas como Plotly Express sin cambiar el código posterior.
import plotly.express as px top10 = resumen.head(10).reset_index() fig = px.bar( top10, x="PULocationID", y="fare_amount", title="10 principales lugares de recogida por tarifa total", etiquetas ={ "PULocationID": "ID de lugar de recogida", "fare_amount": "Tarifa total", }, ) fig.show()
Esto produce la misma visualización interactiva que crearíamos con un DataFrame de pandas normal, pero ahora es mucho más rápido. Además, dado que el código descendente permanece sin cambios, es muy fácil incorporar la aceleración de GPU en portátiles y canalizaciones existentes sin modificar su flujo de trabajo de visualización.
2. Usando el motor GPU Polars
Polars ya es conocido por su rápido motor DataFrame y Lazy API. Pero si trabaja con grandes conjuntos de datos, también puede aprovechar la aceleración de GPU a través del motor de GPU polars impulsado por cuDF.
Al igual que cudf.pandas, permite acelerar los flujos de trabajo existentes con cambios mínimos. Cuando ejecuta una consulta diferida, Polars primero crea un plan de consulta optimizado. Si las operaciones del plan son compatibles con la GPU, se ejecutan mediante cuDF; de lo contrario, Polars cambia automáticamente a su motor de CPU estándar. La siguiente figura ilustra este flujo de ejecución.
Instalación
La forma más sencilla de instalar el motor GPU es a través del paquete opcional Polars GPU, que instala automáticamente las dependencias RAPIDS requeridas.
pip install "polars[gpu]" o # Opción de instalación directa del motor Polars respaldado por cuDF para CUDA 12 pip install -q polars cudf-polars-cu12 –extra-index-url=https://pypi.nvidia.
Habilitando la aceleración de GPU para Polars
Usaremos el mismo conjunto de datos de taxis de Nueva York y realizaremos el mismo análisis que en las secciones anteriores. La única diferencia es que lo ejecutamos con el motor GPU pasando motor="gpu" a Collect().
importar polares como pl taxi_url = "https://d37ci6vzurychx.cloudfront.net/trip-data/amarillo_tripdata_2023-01.parquet" query = ( pl.scan_parquet(taxi_url) .group_by("PULocationID") .agg( fare_amount=pl.col("fare_amount").sum(), trip_distance=pl.col("trip_distance").mean(), trip_count=pl.len(), ) .sort("fare_amount", descendente=True) ) resumen = query.collect(motor="gpu") resumen.head()
La consulta en sí es la misma que un flujo de trabajo estándar de Polars LazyFrame. La única diferencia es que ahora pasamos motor="gpu" en Collect(), lo que le indica a Polars que ejecute la consulta utilizando el motor GPU, si es compatible. Sin embargo, si la consulta contiene operaciones no compatibles, polars recurre automáticamente a su motor de CPU.
Verificando la ejecución de GPU
Para comprobar si se ejecutó una consulta en la GPU, puede habilitar el modo detallado antes de llamar a Collect(). Si no se puede ejecutar una consulta en la GPU, Polars imprime una advertencia de rendimiento que explica por qué volvió a la CPU. También puede deshabilitar el respaldo automático pasando pl.GPUEngine(raise_on_fail=True) a Collect(), lo que genera un error si la consulta no es compatible con la GPU.
unsupported_gpu_operation = ( df_lazy .select( pl.col("fare_amount") .map_elements(tarifa lambda: tarifa * 1.1, return_dtype=pl.Float64) .alias("fare_with_markup") ) .head(10) ) con pl.Config() como cfg: cfg.set_verbose(True) fallback_result = operación_gpu_unsupported.collect(motor="gpu") imprimir(resultado_fallback)
En el ejemplo anterior, usamos intencionalmente map_elements() con una función de Python. Las funciones de Python no son compatibles con el motor GPU de Polars, por lo que esta consulta no puede ejecutarse completamente en la GPU.
Escalado a múltiples GPU
El ejemplo anterior utiliza una sola GPU. Si trabaja con conjuntos de datos más grandes o tiene acceso a varias GPU, puede cambiar a RayEngine con solo un pequeño cambio.
desde cudf_polars.engine.ray importe RayEngine con RayEngine() como motor: resumen = query.collect(motor=motor)
RayEngine utiliza automáticamente todas las GPU visibles para el proceso, lo que permite que la misma consulta diferida escale de una GPU a varias GPU. Si desea obtener más información sobre cómo el motor GPU de Polars se escala en múltiples GPU, Benjamin Zaitlen tiene una buena publicación en el blog que explica los conceptos e incluye ejemplos de rendimiento.
Conclusión
Algo que descubrí en los puntos de referencia y en mis propios experimentos es que las GPU son más útiles para operaciones grandes con uso intensivo de datos, como filtrado, uniones, agregaciones grupales y clasificación. Sin embargo, para conjuntos de datos más pequeños, las CPU suelen ser igual de rápidas debido a la sobrecarga que implica mover datos a la GPU. Gracias a bibliotecas como cudf, ya no necesitamos reescribir una base de código completa para acelerar el procesamiento y análisis de datos. Podemos cambiar entre la ejecución de GPU y CPU según la carga de trabajo. Esto significa que dedicamos menos tiempo a esperar a que finalicen las consultas y más tiempo a centrarnos en otras partes importantes del flujo de trabajo de la ciencia de datos.
En el próximo artículo, iremos más allá de la preparación de datos y exploraremos la aceleración de GPU para bibliotecas de aprendizaje automático y veremos cuánto código realmente se necesita cambiar para acelerar el entrenamiento del modelo.
Nota: Todas las imágenes de este trabajo son del autor a menos que se indique o atribuya lo contrario.