
Los modelos de lenguajes grandes (LLM) de inteligencia artificial (IA) pueden generar texto, traducir idiomas, escribir diversas formas de material creativo y brindar respuestas útiles a sus preguntas. Sin embargo, los LLM tienen algunos problemas, como el hecho de que están capacitados en grandes conjuntos de datos de texto y código que pueden contener sesgos. Los resultados producidos por los LLM pueden reflejar estos prejuicios, reforzando estereotipos negativos y difundiendo información falsa. A veces, los LLM producirán escritos que no tienen base en la realidad. La alucinación describe estas experiencias. La lectura de textos alucinatorios puede dar como resultado malas interpretaciones e inferencias erróneas. Se necesita trabajo para comprender cómo funcionan los LLM en su interior. Debido a esto, es difícil entender el razonamiento detrás de las acciones de los modelos. Esto puede causar problemas en contextos donde la apertura y la responsabilidad son cruciales, como los sectores médico y financiero. La formación e implementación de LLM requiere una gran cantidad de potencia informática. Pueden volverse inaccesibles para muchas empresas más pequeñas y organizaciones sin fines de lucro. El spam, los correos electrónicos de phishing y las noticias falsas son ejemplos de información errónea que se puede generar mediante los LLM. Esto puede poner en peligro tanto a los usuarios como a las empresas.
Los investigadores de NVIDIA han colaborado con líderes de la industria como Meta, Anyscale, Cohere, Deci, Grammarly, Mistral AI, MosaicML (ahora parte de Databricks), OctoML, Tabnine y Together AI para acelerar y perfeccionar la inferencia LLM. Estas mejoras se incluirán en la próxima versión del software NVIDIA TensorRT-LLM de código abierto. TensorRT-LLM es un compilador de aprendizaje profundo que utiliza GPU NVIDIA para proporcionar un rendimiento de última generación gracias a sus núcleos optimizados, fases de pre y posprocesamiento y primitivas de comunicación multi-GPU/múltiples nodos. Los desarrolladores pueden experimentar con nuevos LLM sin necesidad de estar muy familiarizados con C++ o NVIDIA CUDA, lo que proporciona un rendimiento de primer nivel y opciones de personalización rápidas. Con su API Python modular de código abierto, TensorRT-LLM simplifica la definición, optimización y ejecución de nuevas arquitecturas y mejoras a medida que se desarrollan los LLM.
Al aprovechar las últimas GPU para centros de datos de NVIDIA, TensorRT-LLM espera aumentar el rendimiento de LLM y al mismo tiempo reducir considerablemente los gastos. Para crear, optimizar y ejecutar LLM para inferencia en producción, proporciona una API Python sencilla y de código abierto que encapsula el compilador de aprendizaje profundo TensorRT, núcleos optimizados de FasterTransformer, pre y posprocesamiento y multi-GPU/multi- comunicación del nodo.
TensorRT-LLM permite una variedad más amplia de aplicaciones LLM. Ahora que tenemos modelos de 70 mil millones de parámetros como el Llama 2 de Meta y el Falcon 180B, un enfoque uniforme ya no es práctico. El rendimiento en tiempo real de dichos modelos suele depender de configuraciones de múltiples GPU y de una coordinación compleja. Al proporcionar paralelismo tensorial que distribuye matrices de peso entre dispositivos, TensorRT-LLM agiliza este proceso y elimina la necesidad de fragmentación y reorganización manual por parte de los desarrolladores.
La optimización de lotes en vuelo es otra característica notable diseñada para gestionar de manera efectiva las cargas de trabajo extremadamente fluctuantes típicas de las aplicaciones LLM. Esta función permite la ejecución paralela dinámica, lo que maximiza el uso de GPU para tareas como interacciones de preguntas y respuestas en chatbots y resumen de documentos. Dado el tamaño y alcance cada vez mayores de las implementaciones de IA, las empresas pueden anticipar una reducción del costo total de propiedad (TCO).
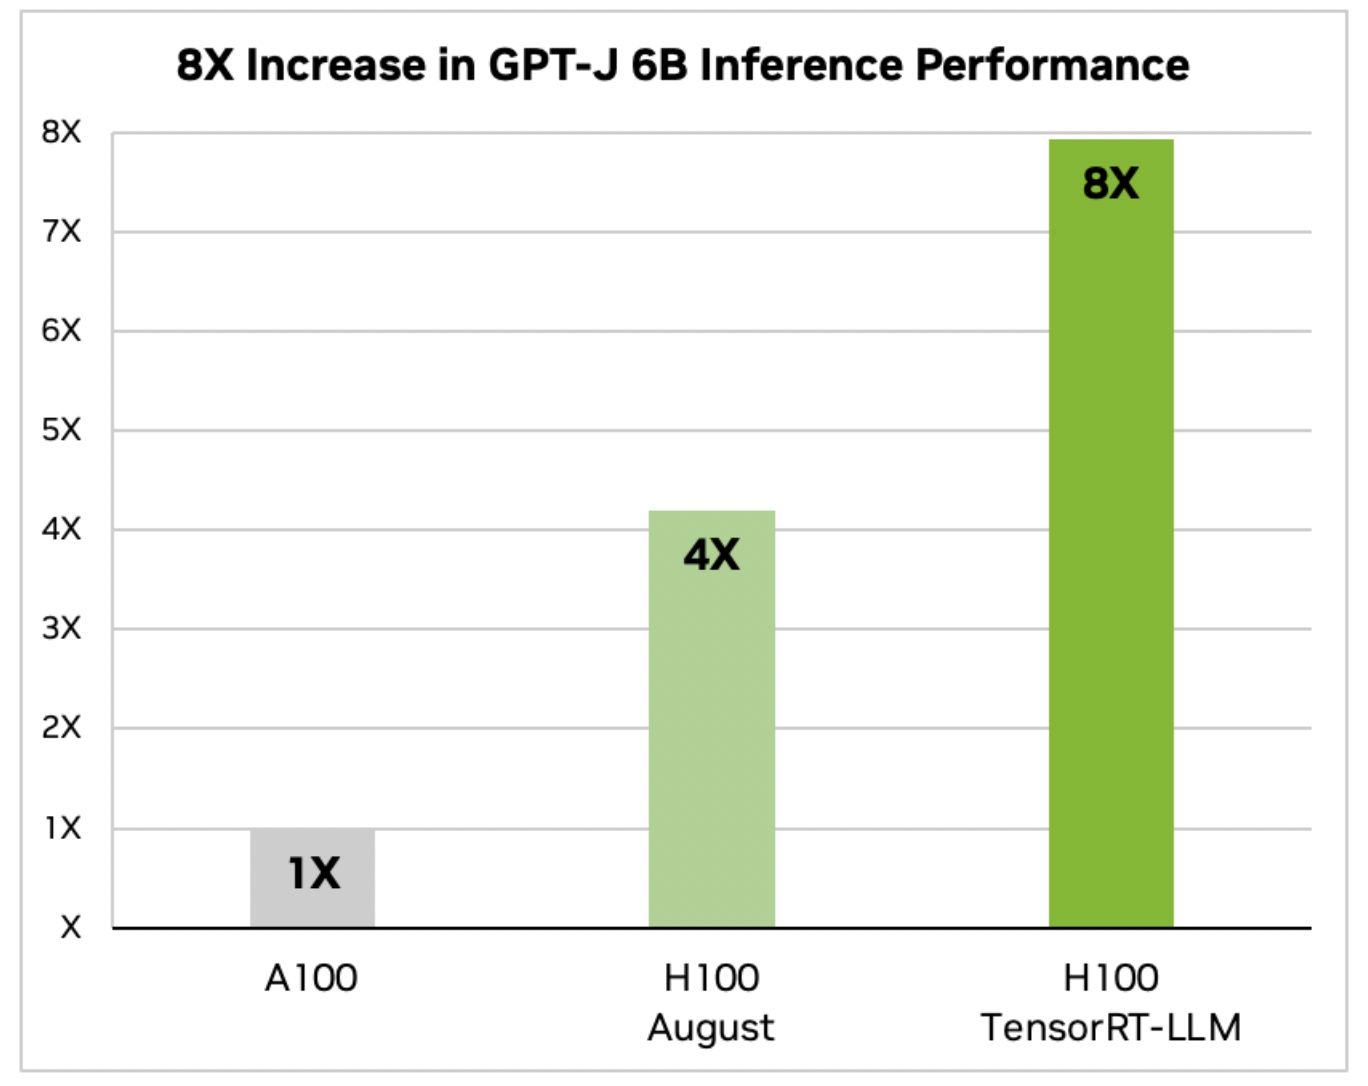
Los resultados en términos de rendimiento son alucinantes. El rendimiento en los puntos de referencia muestra una ganancia 8 veces mayor en tareas como el resumen de artículos cuando se usa TensorRT-LLM con NVIDIA H100 en comparación con el A100.
TensorRT-LLM puede aumentar el rendimiento de inferencia en 4,6 veces en comparación con las GPU A100 en Llama 2, un modelo de lenguaje ampliamente utilizado lanzado recientemente por Meta y utilizado por muchas empresas que desean implementar IA generativa.

Resumen de texto, longitud de E/S variable, conjunto de datos CNN/DailyMail | Modo ansioso A100 FP16 PyTorch | H100 8PM | H100 FP8, procesamiento por lotes en vuelo, TensorRT-LLM | Fuente de la imagen: https://developer.nvidia.com/blog/nvidia-tensorrt-llm-supercharges-large-language-model-inference-on-nvidia-h100-gpus/
En resumen, los LLM se están desarrollando rápidamente. Cada día trae una nueva incorporación al ecosistema en constante expansión de diseños de modelos. Como resultado, los modelos más grandes abren nuevas posibilidades y casos de uso, impulsando la adopción en todos los sectores. El centro de datos está evolucionando debido a la inferencia LLM. El TCO mejora para las empresas debido a un mayor rendimiento con mayor precisión. Las mejores experiencias de los clientes, posibles gracias a cambios de modelo, generan mayores ventas y ganancias. Existen numerosos factores adicionales a considerar al planificar iniciativas de implementación de inferencia para aprovechar al máximo los LLM de última generación. Rara vez la optimización ocurre por sí sola. Los usuarios deben pensar en el paralelismo, las canalizaciones de un extremo a otro y los métodos de programación sofisticados mientras realizan ajustes. Necesitan un sistema informático que pueda manejar datos de distintos grados de precisión sin sacrificar la precisión. TensorRT-LLM es una API de Python sencilla y de código abierto para crear, optimizar y ejecutar LLM para inferencia en producción. Cuenta con el compilador de aprendizaje profundo de TensorRT, núcleos optimizados, pre y posprocesamiento y comunicación multi-GPU/multi-nodo.
Además, no olvides unirte. nuestro SubReddit de más de 30.000 ml, Comunidad de Facebook de más de 40.000 personas, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
Referencias:
- https://developer.nvidia.com/blog/nvidia-tensorrt-llm-supercharges-large-language-model-inference-on-nvidia-h100-gpus/
- https://developer.nvidia.com/tensorrt-llm-early-access

Prathamesh Ingle es ingeniero mecánico y trabaja como analista de datos. También es un practicante de IA y un científico de datos certificado interesado en las aplicaciones de la IA. Le entusiasma explorar nuevas tecnologías y avances con sus aplicaciones en la vida real.