
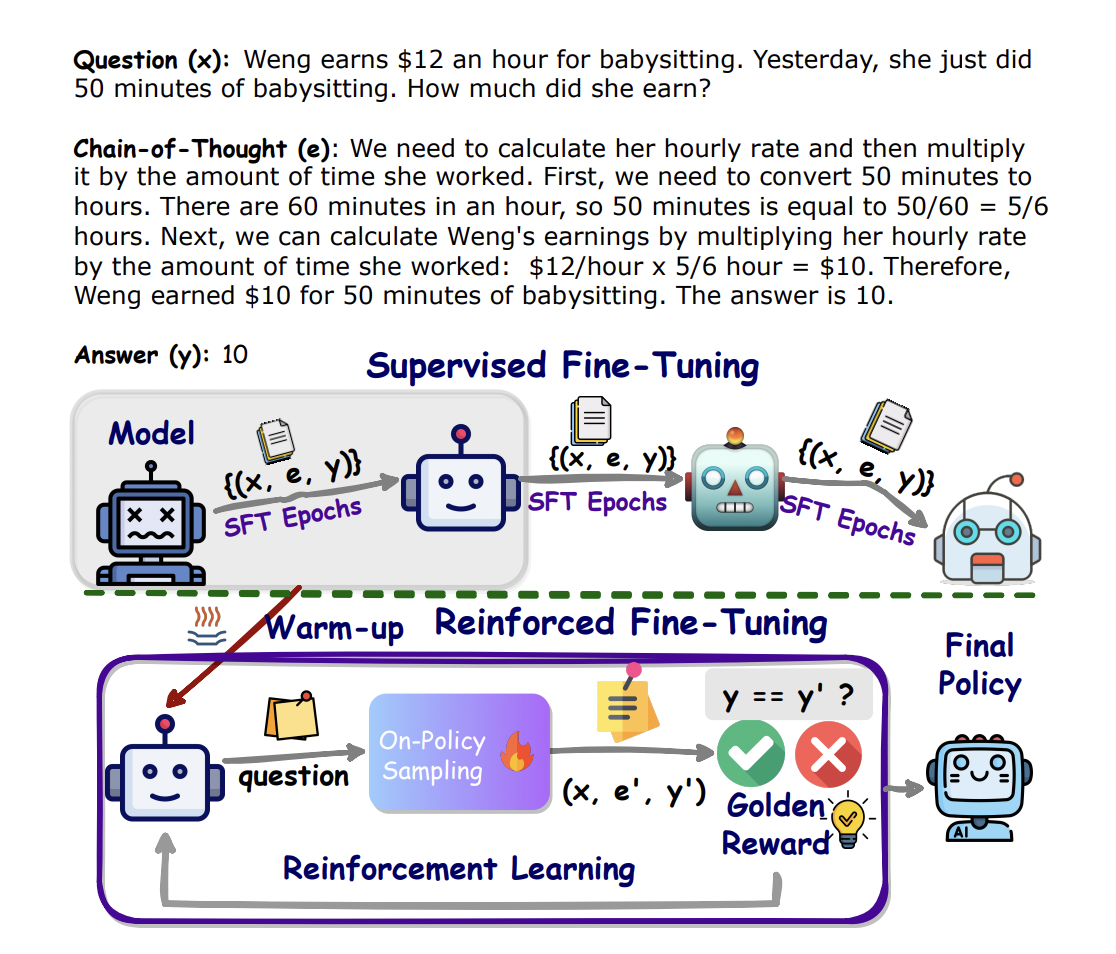
Un método eficaz para mejorar las habilidades de razonamiento de los LLM es emplear ajuste fino supervisado (SFT) con anotaciones de cadena de pensamiento (CoT). Sin embargo, este enfoque tiene limitaciones en términos de generalización porque depende en gran medida de los datos CoT proporcionados. En escenarios como la resolución de problemas matemáticos, cada pregunta de los datos de entrenamiento normalmente tiene solo una ruta de razonamiento anotada. En el caso ideal, sería más beneficioso para el algoritmo aprender de múltiples rutas de razonamiento anotadas asociadas con una pregunta determinada, ya que esto podría mejorar su rendimiento y adaptabilidad generales.
Los investigadores del laboratorio de investigación ByteDance sugieren un método práctico conocido como ajuste fino reforzado (ReFT) para mejorar las capacidades de generalización del aprendizaje de los LLM para el razonamiento, utilizando la resolución de problemas matemáticos como ejemplo ilustrativo. El enfoque ReFT comienza calentando inicialmente el modelo a través de SFT. Posteriormente, aprovecha el aprendizaje por refuerzo en línea, empleando específicamente el algoritmo de optimización de políticas próximas (PPO). Durante este proceso de ajuste, el modelo se expone a varias rutas de razonamiento muestreadas automáticamente en función de la pregunta dada. Las recompensas por el aprendizaje reforzado provienen naturalmente de las respuestas reales, lo que contribuye a un LLM más sólido y adaptable para mejorar las habilidades de razonamiento.
Los esfuerzos de investigación recientes se han centrado en mejorar el diseño rápido de CoT y la ingeniería de datos, con el objetivo de hacer que CoT sea integral y detallado para soluciones de razonamiento paso a paso. Algunos enfoques han utilizado programas Python como indicaciones de CoT, lo que demuestra pasos de razonamiento más precisos y mejoras significativas con respecto a CoT en lenguaje natural. Otra línea de trabajo se centra en mejorar la calidad y cantidad de datos de CoT, incluidos los esfuerzos para aumentar la cantidad de datos de CoT del ChatGPT de OpenAI. El aprendizaje por refuerzo se ha aplicado al ajuste de paradigmas para mejorar el rendimiento con respecto al ajuste supervisado convencional, específicamente para la resolución de problemas matemáticos.

El estudio propone ReFT para mejorar la generalización del aprendizaje de LLM para el razonamiento, específicamente en la resolución de problemas matemáticos. ReFT combina SFT con aprendizaje por refuerzo en línea utilizando el algoritmo PPO. El modelo primero se calienta con SFT y luego se afina mediante el aprendizaje por refuerzo, donde se muestrean automáticamente múltiples rutas de razonamiento dada la pregunta, y las recompensas se derivan de respuestas verdaderas. Además, las estrategias de tiempo de inferencia, como la votación por mayoría y la reclasificación, se combinan con ReFT para impulsar aún más el rendimiento.
El método ReFT supera significativamente al SFT en cuanto a capacidad de razonamiento y generalización para los LLM en resolución de problemas matemáticos. Amplios experimentos con conjuntos de datos GSM8K, MathQA y SVAMP demuestran el mejor rendimiento de ReFT sobre SFT. El rendimiento de ReFT se puede mejorar aún más combinando estrategias de tiempo de inferencia, como la votación por mayoría y la reclasificación. Utilizan programas Python como indicaciones de CoT, lo que muestra pasos de razonamiento más precisos y mejoras significativas con respecto a CoT en lenguaje natural. Trabajos anteriores sobre aprendizaje por refuerzo y reclasificación también han demostrado un mejor rendimiento que el ajuste supervisado y la votación por mayoría.
En conclusión, ReFT se destaca como un método de ajuste para mejorar modelos en la resolución de problemas matemáticos. A diferencia de SFT), ReFT optimiza un objetivo no diferenciable al explorar múltiples anotaciones CoT en lugar de depender de una sola. Amplios experimentos en tres conjuntos de datos utilizando dos modelos fundamentales han demostrado que ReFT supera a SFT en rendimiento y generalización. Los modelos entrenados con ReFT muestran compatibilidad con técnicas como la votación mayoritaria y la reclasificación del modelo de recompensa. ReFT supera a varios modelos de código abierto de tamaños similares en la resolución de problemas matemáticos, destacando su eficacia y valor práctico.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Unirse nuestro SubReddit de 36k+ ML, 41k+ comunidad de Facebook, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Canal de telegramas

A Sana Hassan, pasante de consultoría en Marktechpost y estudiante de doble titulación en IIT Madras, le apasiona aplicar la tecnología y la inteligencia artificial para abordar los desafíos del mundo real. Con un gran interés en resolver problemas prácticos, aporta una nueva perspectiva a la intersección de la IA y las soluciones de la vida real.