
El razonamiento matemático implica la capacidad de resolver problemas y justificar soluciones de forma lógica. Este campo forma la base para desarrollar algoritmos, modelos y simulaciones que resuelvan problemas complejos del mundo real. La creación de LLM especializados en razonamiento matemático sigue siendo un desafío debido a la escasez de conjuntos de datos diversos y de alta calidad. La mayoría de los conjuntos de datos existentes deben ser más grandes para cubrir adecuadamente el vasto espacio de los problemas matemáticos o están cargados de licencias restrictivas que obstaculizan su uso en proyectos de código abierto.
Los enfoques existentes para mejorar el razonamiento matemático en los LLM se han basado principalmente en conjuntos de datos de fuente cerrada generados por LLM comerciales como GPT-3.5 y GPT-4. – Se han utilizado varias técnicas, como cadena de pensamiento, programa de pensamiento, autoconsistencia y autoverificación, para mejorar las capacidades de razonamiento matemático de los LLM. La capacitación previa de modelos de lenguaje sobre contenido con alto contenido matemático ha dado como resultado estudiantes de maestría en maestría con habilidades matemáticas más sólidas. Al mismo tiempo, el entrenamiento específico de conjuntos de datos implica el ajuste de instrucciones en pares de problema-solución derivados de conjuntos de datos de razonamiento matemático.
El equipo de investigación de NVIDIA presentó OpenMathInstruct-1, un novedoso conjunto de datos que comprende 1,8 millones de pares de problemas y soluciones para mejorar el razonamiento matemático en los LLM. Este conjunto de datos se destaca por su licencia abierta y el uso de Mixtral, un LLM de código abierto, para la generación de datos, lo que permite su uso sin restricciones y fomenta la innovación en el campo.

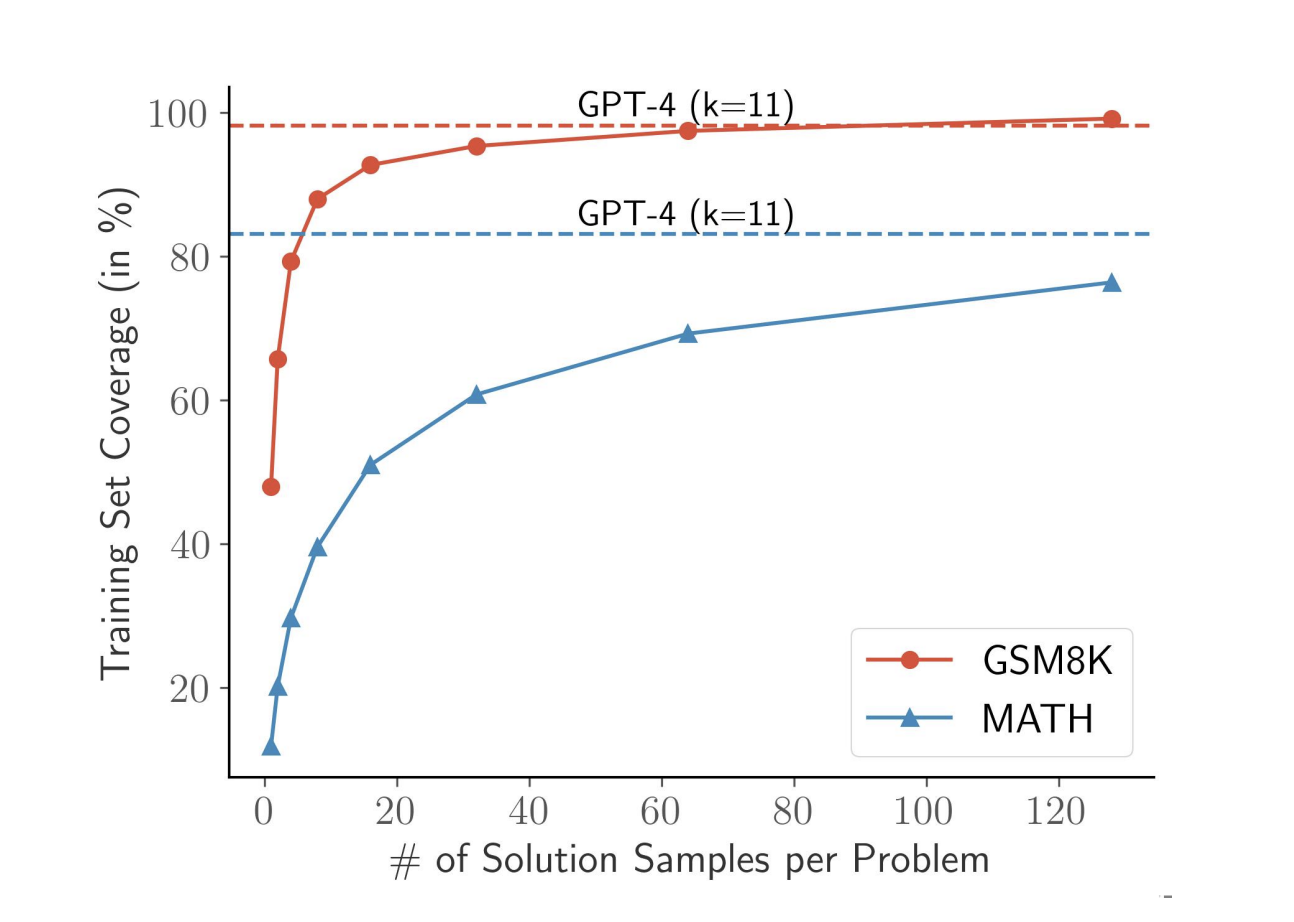
OpenMathInstruct-1 se sintetizó utilizando una combinación de escalamiento de fuerza bruta y estrategias de estimulación novedosas con el modelo Mixtral. Para sintetizar soluciones para los puntos de referencia GSM8K y MATH, la investigación empleó indicaciones breves, incorporando instrucciones, problemas representativos, sus soluciones en formato de intérprete de código y una nueva pregunta del conjunto de capacitación. Si el LLM base generaba una solución que conducía a la respuesta correcta, se incluía en el conjunto de datos de ajuste. Se tomaron muestras de soluciones con restricciones en los números de token y bloques de código, utilizando estrategias como indicaciones de soluciones de texto enmascaradas, específicas del tema y predeterminadas, y estas últimas aumentaron significativamente la cobertura del conjunto de entrenamiento al enmascarar números en cálculos intermedios. Postprocesamiento de soluciones sintácticamente ruidosas corregidas. Las estrategias de selección de datos incluyeron una reducción de muestreo justa versus ingenua y una selección preferencial de código, favoreciendo las soluciones basadas en código. Los modelos se entrenaron durante cuatro épocas, utilizando el optimizador AdamW, y se evaluaron en puntos de referencia utilizando decodificación codiciosa y autoconsistencia/votación mayoritaria.
Los modelos ajustados en una combinación de 512.000 instancias GSM8K y MATH con muestreo reducido, por un total de 1,2 millones, mostraron un rendimiento competitivo frente a modelos destilados de gpt en tareas matemáticas. Por ejemplo, cuando se ajustó con OpenMathInstruct-1, el modelo OpenMath-CodeLlama-70B logró resultados competitivos, con un 84,6 % en GSM8K y un 50,7 % en MATH. Los modelos superaron notablemente a MAmmoTH y MetaMath, con mejoras sostenidas a medida que aumentaron los parámetros del modelo. Mejorada por la decodificación de autoconsistencia, su eficacia varió según las tareas, temas y niveles de dificultad dentro del conjunto de datos MATH. Los estudios de ablación destacaron la superioridad de una reducción de muestra justa sobre los enfoques ingenuos y los beneficios de aumentar el tamaño del conjunto de datos. Si bien las estrategias de selección de código preferencial mejoraron la decodificación codiciosa, tuvieron efectos mixtos en el rendimiento de la decodificación de autoconsistencia.
OpenMathInstruct-1 marca un avance significativo en el desarrollo de LLM para razonamiento matemático. Al ofrecer un conjunto de datos a gran escala con licencia abierta, este trabajo aborda las limitaciones de los conjuntos de datos existentes y establece un nuevo estándar para la investigación colaborativa y accesible en el campo. El éxito del modelo OpenMath-CodeLlama-70B subraya el potencial de los esfuerzos de código abierto para lograr avances en dominios especializados como el razonamiento matemático.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y noticias de Google. Unirse nuestro SubReddit de 37k+ ML, 41k+ comunidad de Facebook, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Canal de telegramas

Nikhil es consultor interno en Marktechpost. Está cursando una doble titulación integrada en Materiales en el Instituto Indio de Tecnología de Kharagpur. Nikhil es un entusiasta de la IA/ML que siempre está investigando aplicaciones en campos como los biomateriales y la ciencia biomédica. Con una sólida formación en ciencia de materiales, está explorando nuevos avances y creando oportunidades para contribuir.