
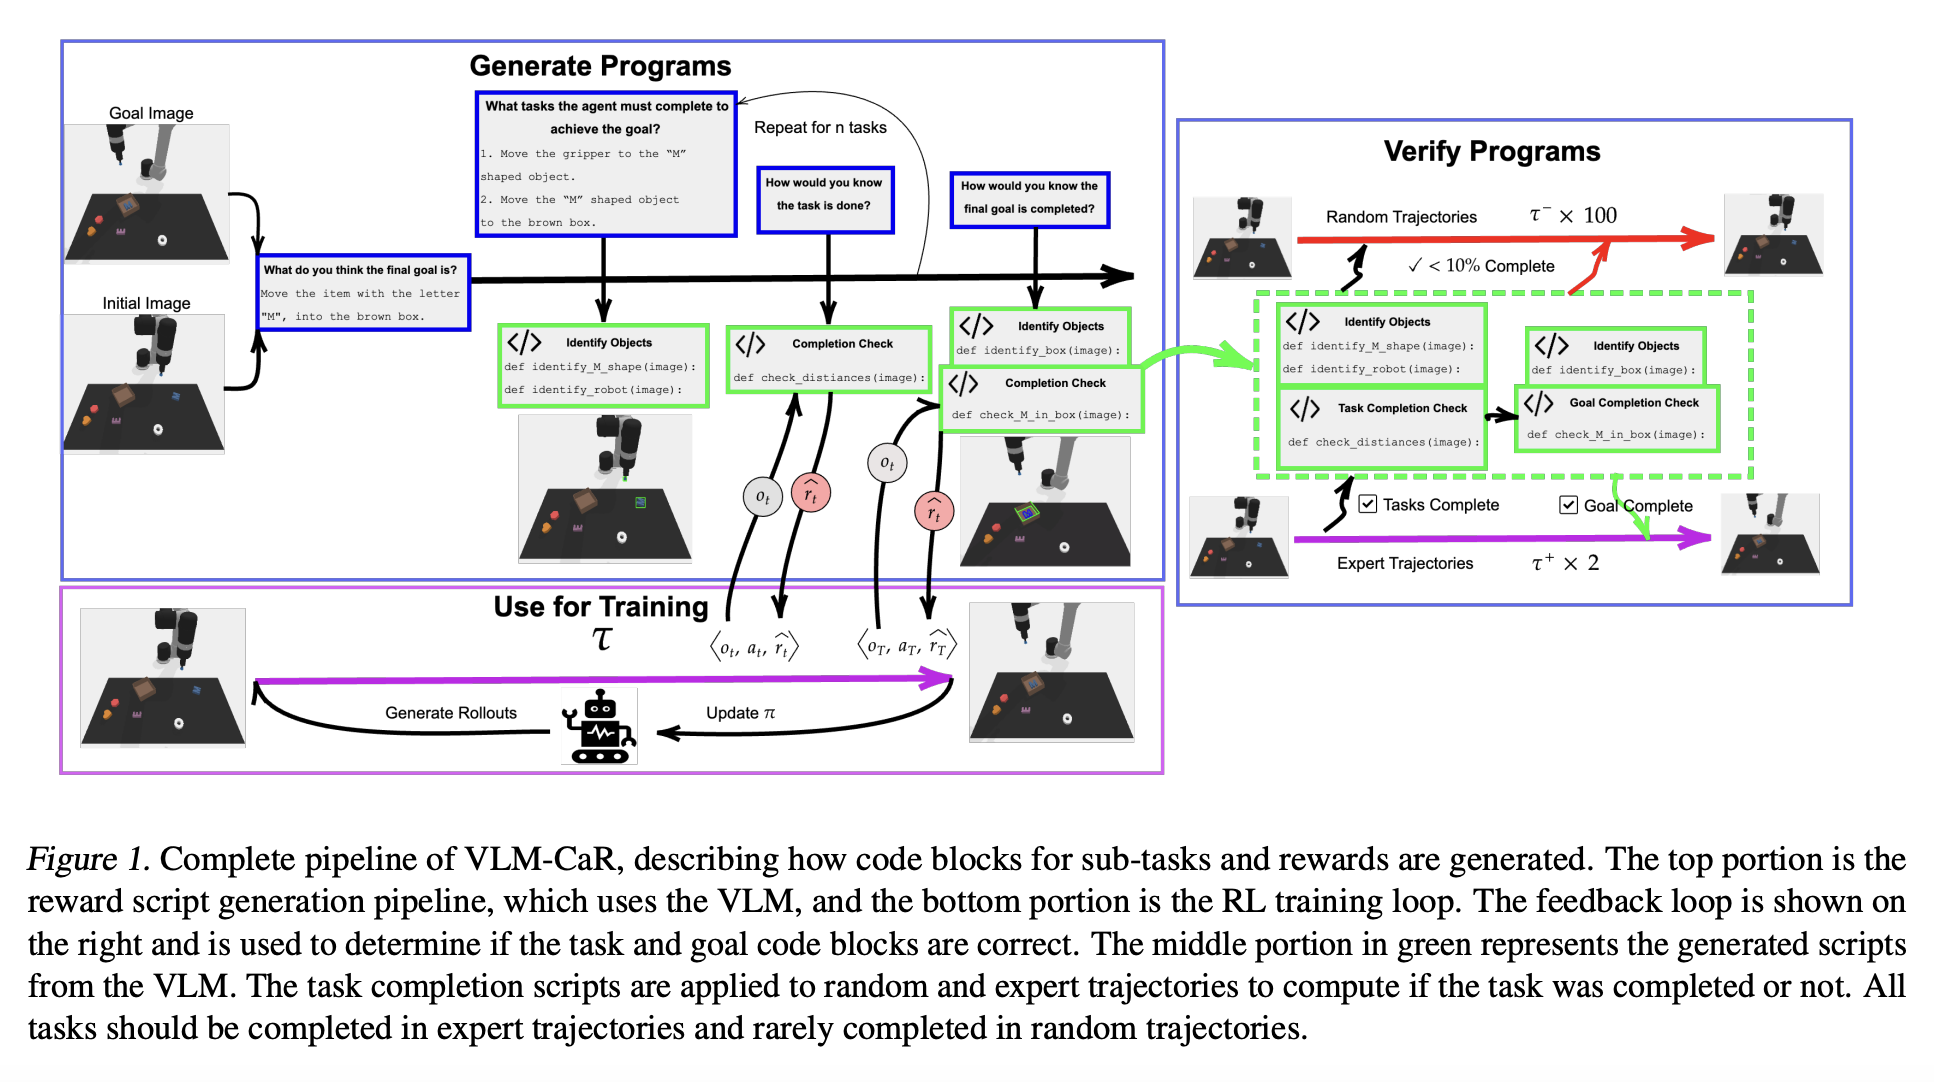
Investigadores de Google DeepMind han colaborado con Mila y la Universidad McGill definieron funciones de recompensa apropiadas para abordar el desafío de entrenar eficientemente agentes de aprendizaje por refuerzo (RL). El método de aprendizaje por refuerzo utiliza un sistema de recompensa por lograr las conductas deseadas y castigar las no deseadas. Por lo tanto, diseñar funciones de recompensa efectivas es crucial para que los agentes de RL aprendan de manera eficiente, pero a menudo requiere un esfuerzo significativo por parte de los diseñadores del entorno. El artículo propone aprovechar los modelos de visión y lenguaje (VLM) para automatizar el proceso de generación de funciones de recompensa.
Los modelos existentes que definen la función de recompensa para los agentes de RL han sido un proceso manual y laborioso, que a menudo requiere experiencia en el dominio. El documento presenta un marco llamado Código como recompensa (VLM-CaR), que utiliza VLM previamente entrenados para generar funciones de recompensa densas para los agentes de RL de forma automática. A diferencia de la consulta directa de recompensas a los VLM, que es computacionalmente costosa y poco confiable, VLM-CaR genera funciones de recompensa a través de la generación de código, lo que reduce significativamente la carga computacional. Con este marco, los investigadores intentaron proporcionar recompensas precisas que sean interpretables y puedan derivarse de información visual.
VLM-CaR opera en tres etapas: generación de programas, verificación de programas y capacitación de RL. En la primera etapa, se solicita a los VLM previamente entrenados que describan tareas y subtareas basadas en imágenes iniciales y de objetivos de un entorno. Las descripciones generadas se utilizan luego para producir programas informáticos ejecutables para cada subtarea. Los programas generados se verifican para garantizar su corrección mediante trayectorias expertas y aleatorias. Después del paso de verificación, los programas actúan como funciones de recompensa para capacitar a los agentes de RL. Utilizando la función de recompensa generada, VLM-CaR está capacitado para políticas de RL y permite una capacitación eficiente incluso en entornos con recompensas escasas o no disponibles.
En conclusión, el método propuesto aborda el problema de definir manualmente funciones de recompensa proporcionando un marco sistemático para generar recompensas interpretables a partir de observaciones visuales. VLM-CaR demuestra el potencial para mejorar significativamente la eficiencia de la capacitación y el desempeño de los agentes de RL en diversos entornos.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y noticias de Google. Unirse nuestro SubReddit de 38k+ ML, 41k+ comunidad de Facebook, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Canal de telegramas
También te puede gustar nuestro Cursos GRATUITOS de IA….
Pragati Jhunjhunwala es pasante de consultoría en MarktechPost. Actualmente está cursando su B.Tech en el Instituto Indio de Tecnología (IIT), Kharagpur. Es una entusiasta de la tecnología y tiene un gran interés en el alcance del software y las aplicaciones de ciencia de datos. Siempre está leyendo sobre los avances en diferentes campos de la IA y el ML.