
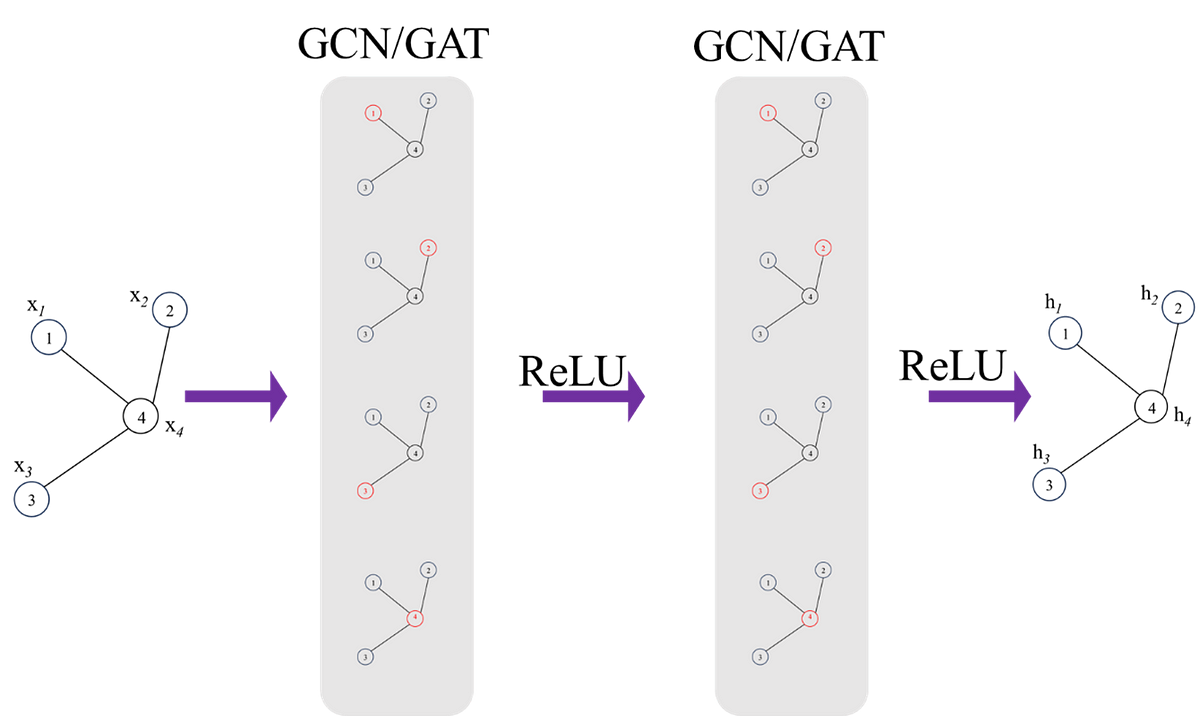
Implementemos un ejemplo de regresión donde el objetivo es entrenar una red para predecir el valor de un nodo dado el valor de todos los demás nodos, es decir, cada nodo tiene una única característica (que es un valor escalar). El objetivo de este ejemplo es aprovechar la información relacional inherente codificada en el gráfico para predecir con precisión los valores numéricos de cada nodo. Lo clave a tener en cuenta es que ingresamos el valor numérico para todos los nodos excepto el nodo objetivo (enmascaramos el valor del nodo objetivo con 0) y luego predecimos el valor del nodo objetivo. Para cada punto de datos, repetimos el proceso para todos los nodos. Quizás esto pueda parecer una tarea extraña, pero veamos si podemos predecir el valor esperado de cualquier nodo dados los valores de los otros nodos. Los datos utilizados son los datos de simulación correspondientes a una serie de sensores de la industria y la estructura gráfica que he elegido en el siguiente ejemplo se basa en la estructura del proceso real. He proporcionado comentarios en el código para que sea fácil de seguir. Puede encontrar una copia del conjunto de datos. aquí (Nota: estos son mis propios datos, generados a partir de simulaciones).
Este código y procedimiento de capacitación están lejos de estar optimizados, pero su objetivo es ilustrar la implementación de GNN y obtener una intuición de cómo funcionan. Un problema con la forma en que lo he hecho actualmente y que definitivamente no debería hacerse de esta manera más allá de los fines de aprendizaje es enmascarar el valor de la característica del nodo y predecirlo a partir de la característica de los vecinos. Actualmente, tendría que recorrer cada nodo (no es muy eficiente), una manera mucho mejor de hacerlo es evitar que el modelo incluya sus propias características en el paso de agregación y, por lo tanto, no necesitaría hacer un nodo a la vez. pero pensé que es más fácil desarrollar la intuición para el modelo con el método actual 🙂
Preprocesamiento de datos
Importando las bibliotecas necesarias y los datos del sensor desde un archivo CSV. Normalice todos los datos en el rango de 0 a 1.
import pandas as pd
import torch
from torch_geometric.data import Data, Batch
from sklearn.preprocessing import StandardScaler, MinMaxScaler
from sklearn.model_selection import train_test_split
import numpy as np
from torch_geometric.data import DataLoader# load and scale the dataset
df = pd.read_csv('SensorDataSynthetic.csv').dropna()
scaler = MinMaxScaler()
df_scaled = pd.DataFrame(scaler.fit_transform(df), columns=df.columns)
Definir la conectividad (índice de borde) entre nodos en el gráfico utilizando un tensor de PyTorch; es decir, esto proporciona la topología gráfica del sistema.
nodes_order = [
'Sensor1', 'Sensor2', 'Sensor3', 'Sensor4',
'Sensor5', 'Sensor6', 'Sensor7', 'Sensor8'
]# define the graph connectivity for the data
edges = torch.tensor([
[0, 1, 2, 2, 3, 3, 6, 2],  # source nodes
[1, 2, 3, 4, 5, 6, 2, 7]   # target nodes
], dtype=torch.long)
Los datos importados desde csv tienen una estructura tabular, pero para usarlos en GNN, se deben transformar a una estructura gráfica. Cada fila de datos (una observación) se representa como un gráfico. Iterar a través de cada fila para crear una representación gráfica de los datos
Se crea una máscara para cada nodo/sensor para indicar la presencia (1) o ausencia (0) de datos, lo que permite flexibilidad en el manejo de datos faltantes. En la mayoría de los sistemas, puede haber elementos sin datos disponibles, de ahí la necesidad de flexibilidad en el manejo de los datos faltantes. Divida los datos en conjuntos de entrenamiento y prueba.
graphs = []# iterate through each row of data to create a graph for each observation
# some nodes will not have any data, not the case here but created a mask to allow us to deal with any nodes that do not have data available
for _, row in df_scaled.iterrows():
node_features = []
node_data_mask = []
for node in nodes_order:
if node in df_scaled.columns:
node_features.append([row[node]])
node_data_mask.append(1) # mask value of to indicate present of data
else:
# missing nodes feature if necessary
node_features.append(2)
node_data_mask.append(0) # data not present
node_features_tensor = torch.tensor(node_features, dtype=torch.float)
node_data_mask_tensor = torch.tensor(node_data_mask, dtype=torch.float)
# Create a Data object for this row/graph
graph_data = Data(x=node_features_tensor, edge_index=edges.t().contiguous(), mask = node_data_mask_tensor)
graphs.append(graph_data)
#### splitting the data into train, test observation
# Split indices
observation_indices = df_scaled.index.tolist()
train_indices, test_indices = train_test_split(observation_indices, test_size=0.05, random_state=42)
# Create training and testing graphs
train_graphs = [graphs[i] for i in train_indices]
test_graphs = [graphs[i] for i in test_indices]
Visualización de gráficos
La estructura del gráfico creada anteriormente usando los índices de borde se puede visualizar usando networkx.
import networkx as nx
import matplotlib.pyplot as pltG = nx.Graph()
for src, dst in edges.t().numpy():
G.add_edge(nodes_order[src], nodes_order[dst])
plt.figure(figsize=(10, 8))
pos = nx.spring_layout(G)
nx.draw(G, pos, with_labels=True, node_color='lightblue', edge_color='gray', node_size=2000, font_weight='bold')
plt.title('Graph Visualization')
plt.show()
Definición del modelo
Definamos el modelo. El modelo incorpora 2 capas convolucionales GAT. La primera capa transforma las características del nodo en un espacio de 8 dimensiones, y la segunda capa GAT lo reduce aún más a una representación de 8 dimensiones.
Los GNN son altamente susceptibles al sobreajuste; la regularización (abandono) se aplica después de cada capa GAT con una probabilidad definida por el usuario para evitar el sobreajuste. La capa de abandono esencialmente pone a cero aleatoriamente algunos de los elementos del tensor de entrada durante el entrenamiento.
Los resultados de salida de la capa de convolución GAT se pasan a través de una capa completamente conectada (lineal) para asignar la salida de 8 dimensiones a la característica del nodo final, que en este caso es un valor escalar por nodo.
Enmascarar el valor del Nodo objetivo; Como se mencionó anteriormente, el objetivo de esta tarea es hacer una regresión del valor del nodo objetivo en función del valor de sus vecinos. Esta es la razón detrás de enmascarar/reemplazar el valor del nodo objetivo por cero.
from torch_geometric.nn import GATConv
import torch.nn.functional as F
import torch.nn as nnclass GNNModel(nn.Module):
def __init__(self, num_node_features):
super(GNNModel, self).__init__()
self.conv1 = GATConv(num_node_features, 16)
self.conv2 = GATConv(16, 8)
self.fc = nn.Linear(8, 1) # Outputting a single value per node
def forward(self, data, target_node_idx=None):
x, edge_index = data.x, data.edge_index
edge_index = edge_index.T
x = x.clone()
# Mask the target node's feature with a value of zero!
# Aim is to predict this value from the features of the neighbours
if target_node_idx is not None:
x[target_node_idx] = torch.zeros_like(x[target_node_idx])
x = F.relu(self.conv1(x, edge_index))
x = F.dropout(x, p=0.05, training=self.training)
x = F.relu(self.conv2(x, edge_index))
x = F.relu(self.conv3(x, edge_index))
x = F.dropout(x, p=0.05, training=self.training)
x = self.fc(x)
return x
Entrenando el modelo
Inicializar el modelo y definir el optimizador, la función de pérdida y los hiperparámetros, incluida la tasa de aprendizaje, la disminución del peso (para la regularización), el tamaño del lote y el número de épocas.
model = GNNModel(num_node_features=1)
batch_size = 8
optimizer = torch.optim.Adam(model.parameters(), lr=0.0002, weight_decay=1e-6)
criterion = torch.nn.MSELoss()
num_epochs = 200
train_loader = DataLoader(train_graphs, batch_size=1, shuffle=True)
model.train()
El proceso de entrenamiento es bastante estándar, cada gráfico (un punto de datos) de datos se pasa a través del paso directo del modelo (iterando sobre cada nodo y prediciendo el nodo objetivo. La pérdida de la predicción se acumula sobre el tamaño de lote definido antes de actualizar el GNN mediante retropropagación.
for epoch in range(num_epochs):
accumulated_loss = 0
optimizer.zero_grad()
loss = 0
for batch_idx, data in enumerate(train_loader):
mask = data.mask
for i in range(1,data.num_nodes):
if mask[i] == 1:  # Only train on nodes with data
output = model(data, i)  # get predictions with the target node masked
# check the feed forward part of the model
target = data.x[i]
prediction = output[i].view(1)
loss += criterion(prediction, target)
#Update parameters at the end of each set of batches
if (batch_idx+1) % batch_size == 0 or (batch_idx +1 ) == len(train_loader):
loss.backward()
optimizer.step()
optimizer.zero_grad()
accumulated_loss += loss.item()
loss = 0average_loss = accumulated_loss / len(train_loader)
print(f'Epoch {epoch+1}, Average Loss: {average_loss}')
Probando el modelo entrenado
Utilizando el conjunto de datos de prueba, pase cada gráfico a través del paso directo del modelo entrenado y prediga el valor de cada nodo en función del valor de sus vecinos.
test_loader = DataLoader(test_graphs, batch_size=1, shuffle=True)
model.eval()actual = []
pred = []
for data in test_loader:
mask = data.mask
for i in range(1,data.num_nodes):
output = model(data, i)
prediction = output[i].view(1)
target = data.x[i]
actual.append(target)
pred.append(prediction)
Visualizando los resultados de la prueba
Usando iplot podemos visualizar los valores predichos de los nodos frente a los valores reales del terreno.
import plotly.graph_objects as go
from plotly.offline import iplotactual_values_float = [value.item() for value in actual]
pred_values_float = [value.item() for value in pred]
scatter_trace = go.Scatter(
x=actual_values_float,
y=pred_values_float,
mode='markers',
marker=dict(
size=10,
opacity=0.5,
color='rgba(255,255,255,0)',
line=dict(
width=2,
color='rgba(152, 0, 0, .8)',
)
),
name='Actual vs Predicted'
)
line_trace = go.Scatter(
x=[min(actual_values_float), max(actual_values_float)],
y=[min(actual_values_float), max(actual_values_float)],
mode='lines',
marker=dict(color='blue'),
name='Perfect Prediction'
)
data = [scatter_trace, line_trace]
layout = dict(
title='Actual vs Predicted Values',
xaxis=dict(title='Actual Values'),
yaxis=dict(title='Predicted Values'),
autosize=False,
width=800,
height=600
)
fig = dict(data=data, layout=layout)
iplot(fig)
A pesar de la falta de ajuste fino de la arquitectura del modelo o los hiperparámetros, en realidad ha hecho un trabajo decente, pudimos ajustar aún más el modelo para obtener una precisión mejorada.
Esto nos lleva al final de este artículo. Los GNN son relativamente más nuevos que otras ramas del aprendizaje automático; será muy emocionante ver los desarrollos de este campo, pero también su aplicación a diferentes problemas. Finalmente, gracias por tomarse el tiempo de leer este artículo. Espero que le haya resultado útil para comprender los GNN o sus antecedentes matemáticos.
A menos que se indique lo contrario, todas las imágenes son del autor.