
La búsqueda de aprovechar todo el potencial de la inteligencia artificial ha dado lugar a investigaciones innovadoras en la intersección del aprendizaje por refuerzo (RL) y los modelos de lenguajes grandes (LLM). El aprendizaje por refuerzo ha sido un campo de juego para algoritmos que aprenden mediante prueba y error, un proceso que se basa fundamentalmente en la capacidad de explorar territorios desconocidos para tomar decisiones informadas. Esta capacidad es vital en entornos complejos e inciertos donde el costo de cada decisión es alto, como en la conducción autónoma, el diagnóstico de atención médica y la gestión de cartera financiera.
Investigadores de Microsoft Research y la Universidad Carnegie Mellon han evaluado la capacidad de los LLM, como GPT-3.5, GPT-4 y Llama2, para actuar como agentes de toma de decisiones en entornos simples de RL, particularmente en problemas de bandidos multiarmados (MAB). Este enfoque evita la necesidad de métodos de entrenamiento algorítmico tradicionales al aprovechar la capacidad inherente de los LLM para aprender del contexto proporcionado directamente dentro de sus indicaciones. El objetivo es comprender si estos modelos sofisticados pueden participar naturalmente en la exploración.
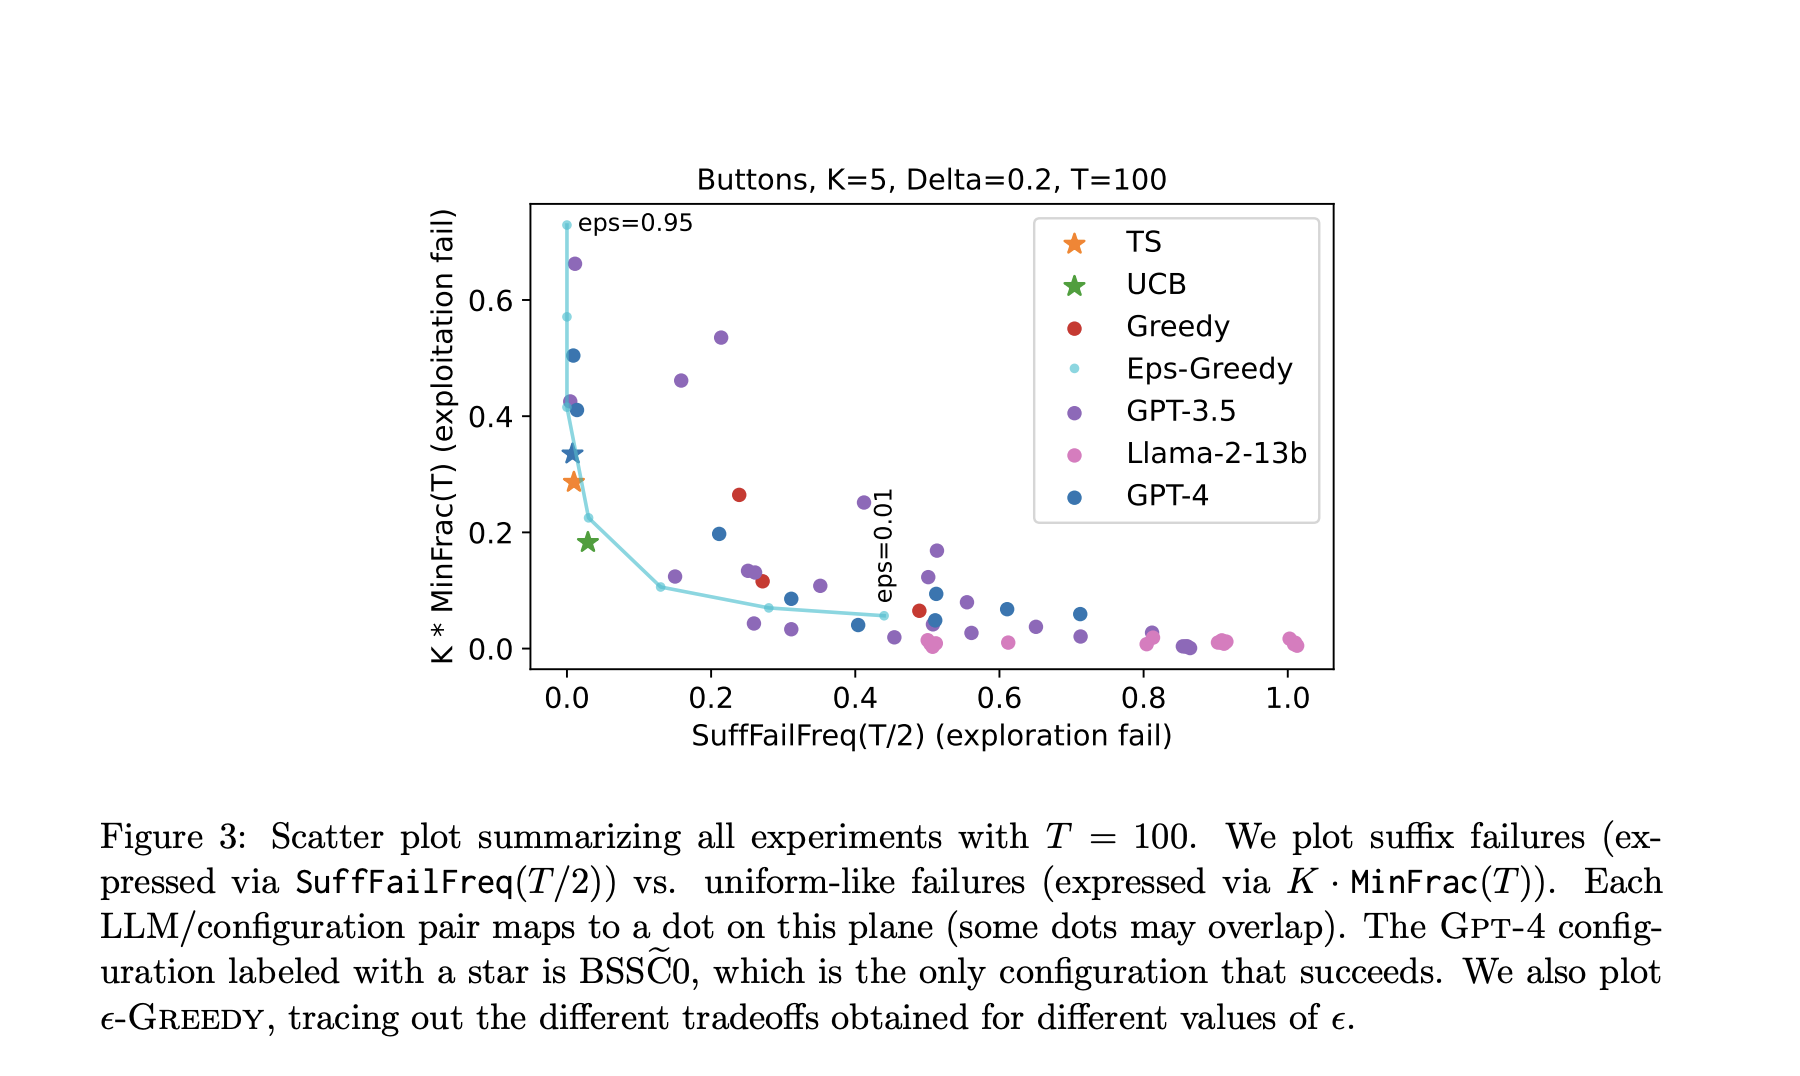
Los resultados de estas investigaciones han revelado que las capacidades de exploración de los LLM son inherentemente limitadas sin intervenciones específicas. Una serie de experimentos que involucraron diferentes configuraciones de indicaciones y versiones de modelos revelaron que casi todas las configuraciones conducían a un comportamiento de exploración subóptimo, excepto una configuración singular que involucraba a GPT-4. Esta configuración utilizó un mensaje especialmente diseñado que animó al modelo a participar en un proceso de razonamiento en cadena de pensamiento y le proporcionó un historial resumido de interacciones pasadas. Esta configuración fue la única que demostró un comportamiento exploratorio satisfactorio.
Sin embargo, este éxito también puso de relieve una limitación crítica: la dependencia del resumen de datos externos para lograr el comportamiento deseado. Este requisito plantea desafíos importantes en escenarios más complejos donde resumir el historial de interacciones no es sencillo o factible, lo que limita la aplicabilidad del modelo en diversos entornos de RL.
La investigación del rendimiento de los modelos en varios escenarios proporcionó información cuantitativa sobre su eficiencia de exploración. Por ejemplo, en la única configuración exitosa de GPT-4, el comportamiento exploratorio se alineó estrechamente con algoritmos diseñados por humanos como Thompson Sampling y Upper Confidence Bound (UCB), conocidos por su equilibrio efectivo entre exploración y explotación. Sin embargo, la frecuencia de fallas de sufijo, donde el modelo dejó de explorar nuevas opciones por completo en las últimas etapas de la toma de decisiones, fue marcadamente alta en casi todas las demás configuraciones del modelo. Esto fue particularmente evidente en configuraciones sin el resumen externo del historial de interacción, donde modelos como GPT-3.5 y Llama2 tuvieron un rendimiento consistentemente inferior.

En conclusión, explorar la capacidad de los LLM para participar en la toma de decisiones revela un panorama lleno de potencial pero plagado de desafíos. Si bien configuraciones específicas de modelos como GPT-4 son prometedoras para navegar en entornos de RL simples a través de una exploración efectiva, la dependencia de intervenciones externas subraya un cuello de botella importante. Esta investigación subraya la necesidad de avances en el diseño rápido y las técnicas algorítmicas para desbloquear toda la capacidad de toma de decisiones de los LLM en un espectro de aplicaciones.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 39k+ ML

Hola, mi nombre es Adnan Hassan. Soy pasante de consultoría en Marktechpost y pronto seré aprendiz de gestión en American Express. Actualmente estoy cursando una doble titulación en el Instituto Indio de Tecnología, Kharagpur. Me apasiona la tecnología y quiero crear nuevos productos que marquen la diferencia.