
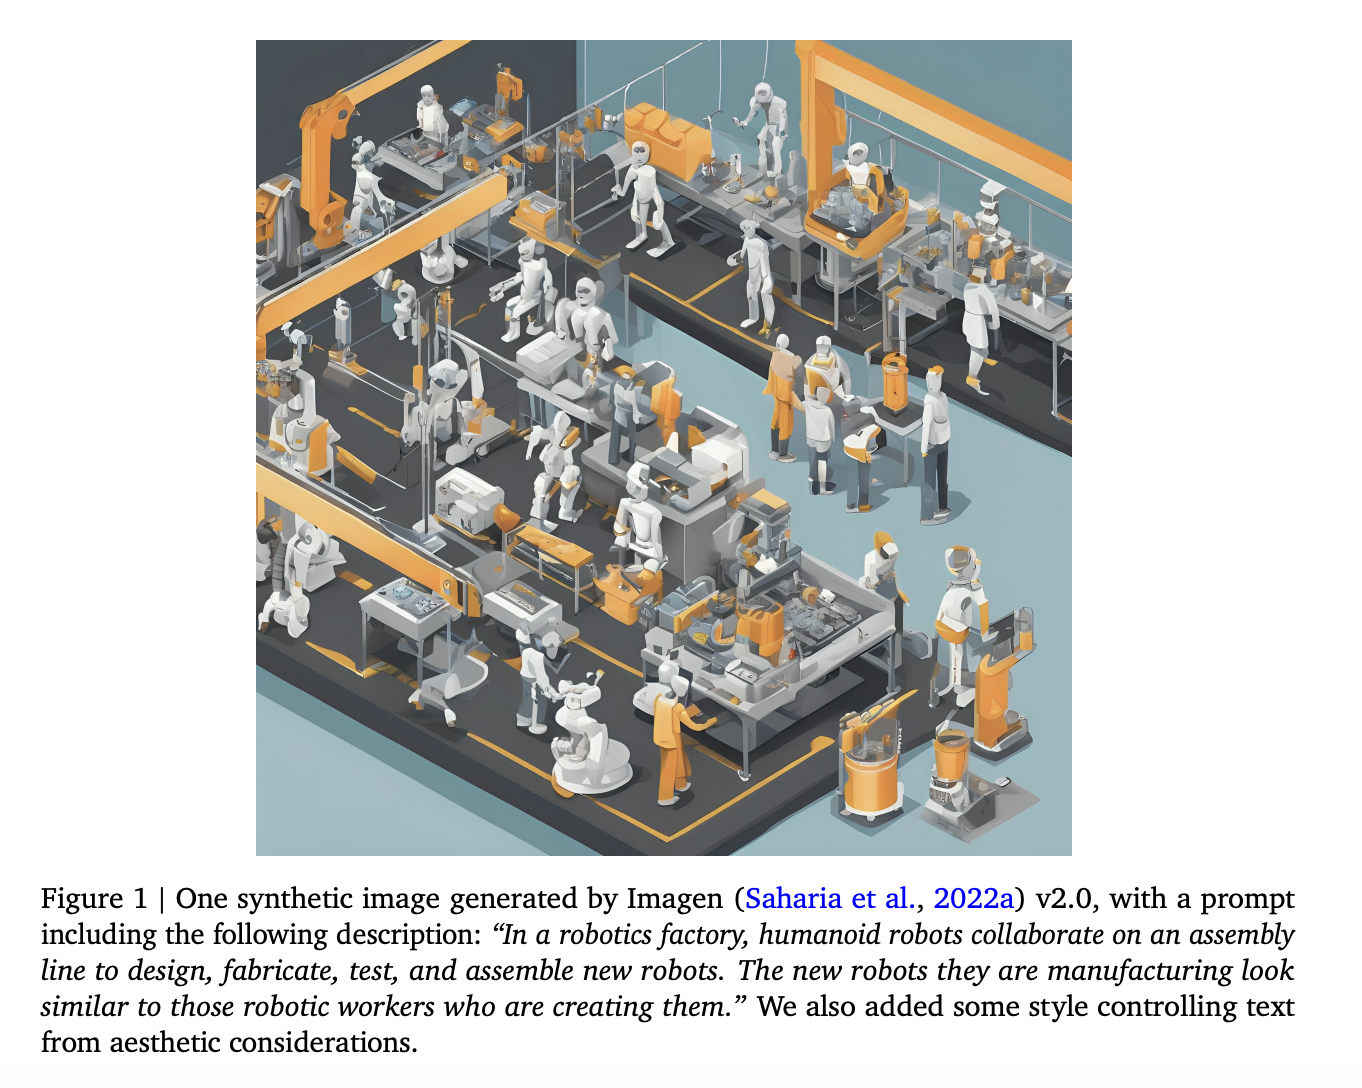
En el panorama de la inteligencia artificial (IA) en rápida evolución, la búsqueda de conjuntos de datos grandes, diversos y de alta calidad representa un obstáculo importante. Datos sintéticos ha sido identificado como una solución fundamental a este desafío, prometiendo cerrar la brecha causada por la escasez de datos, los problemas de privacidad y los altos costos asociados con la adquisición de datos. Estos datos artificiales, elaborados a través de algoritmos y modelos generativos, reflejan los intrincados patrones de la información del mundo real, ofreciendo un rayo de esperanza para una infinidad de aplicaciones de IA que abarcan desde innovaciones en atención médica hasta tecnologías financieras.
El atractivo de los datos sintéticos es su capacidad de producirse bajo demanda, adaptarse a necesidades específicas y estar libres de obstáculos a la privacidad, abordando así tres barreras críticas en el desarrollo de la IA. Por ejemplo, en dominios donde los datos auténticos son raros o confidenciales, los datos sintéticos surgen como una alternativa escalable y personalizable. No solo ayuda a lograr conjuntos de datos equilibrados para entrenar modelos de IA, sino que también desempeña un papel crucial en la preservación de la privacidad del usuario al generar conjuntos de datos anónimos, lo cual es particularmente vital en campos sensibles como la atención médica.
Sin embargo, los datos sintéticos tienen sus desafíos. La integridad de los datos sintéticos: su factibilidad y fidelidad—Es primordial, ya que los datos que se desvían de la realidad corren el riesgo de socavar la generalización de los modelos de IA a contextos del mundo real. Los desafíos se extienden al riesgo de incorporar sesgos en conjuntos de datos sintéticos, lo que requiere una validación rigurosa y evaluaciones de equidad. El artículo profundiza en estos desafíos, proponiendo modelos generativos avanzados y métricas de evaluación como posibles soluciones, al tiempo que destaca la necesidad de pruebas matizadas para garantizar la confiabilidad y el uso ético de los datos sintéticos.
Al explorar varios ámbitos, el artículo proporciona pruebas convincentes de la versatilidad de los datos sintéticos. La amplitud de la aplicación de los datos sintéticos es enorme, desde mejorar el razonamiento matemático en modelos de IA con problemas generados rigurosamente hasta fomentar capacidades de razonamiento de código a través de muestras sintéticas ejecutables. En el uso y la planificación de herramientas, las trayectorias sintéticas y los entornos simulados demuestran cómo se puede enseñar a la IA interacciones de herramientas complejas y estrategias de planificación, lo que subraya el potencial transformador de los datos sintéticos en diversas tareas de razonamiento.
En conclusión, los datos sintéticos han allanado el camino hacia la próxima frontera de la IA, permitiendo el desarrollo de sistemas de IA más potentes, inclusivos y confiables. Al abordar los desafíos y aprovechar el potencial de los datos sintéticos de manera responsable y efectiva, los investigadores pueden desbloquear nuevas posibilidades e impulsar el campo de la IA, beneficiando en última instancia a la sociedad en su conjunto.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de más de 40.000 ml
¿Quiere estar frente a 1,5 millones de audiencias de IA? Trabaja con nosotros aquí
Vineet Kumar es pasante de consultoría en MarktechPost. Actualmente está cursando su licenciatura en el Instituto Indio de Tecnología (IIT), Kanpur. Es un entusiasta del aprendizaje automático. Le apasiona la investigación y los últimos avances en Deep Learning, Computer Vision y campos relacionados.