

En mi último correoAnalizamos en profundidad los modelos básicos y los modelos de lenguaje grandes (LLM). Intentamos comprender qué son, cómo se utilizan y qué los hace especiales. Exploramos dónde funcionan bien y dónde podrían fallar. Analizamos sus aplicaciones en diferentes áreas, como la comprensión de textos y la generación de contenido. Estos LLM han sido transformadores en el campo del procesamiento del lenguaje natural (PLN).
Cuando pensamos en un pipeline de PNL, la ingeniería de características (también conocida como extracción de características o representación de texto o vectorización de texto) es un paso muy importante e integral. Este paso implica técnicas para representar texto como números (vectores de características). Necesitamos realizar este paso cuando trabajamos en un problema de PNL, ya que las computadoras no pueden entender texto, solo entienden números y es esta representación numérica del texto la que se debe introducir en los algoritmos de aprendizaje automático para resolver varios casos de uso basados en texto, como traducción de idiomas, análisis de sentimientos, resumen, etc.
Para aquellos de nosotros que conocemos el flujo de trabajo del aprendizaje automático en general, entendemos que la ingeniería de características es un paso crucial para generar buenos resultados a partir del modelo. El mismo concepto se aplica también en el procesamiento del lenguaje natural. Cuando generamos una representación numérica de datos textuales, un objetivo importante que intentamos lograr es que la representación numérica generada Debería ser capaz de capturar el significado del texto subyacente.. Por eso, hoy en nuestro post no solo hablaremos de las distintas técnicas disponibles para este fin, sino que también evaluaremos qué tan cerca están de nuestro objetivo en cada paso.
Algunos de los enfoques más destacados para la extracción de características son:
– Una codificación en caliente
– Bolsa de palabras (BOW)
– ngramas
– Fuerzas de defensa de las fuerzas armadas de Israel
– Incrustaciones de palabras
Comenzaremos por comprender algunas terminologías básicas y cómo se relacionan entre sí.
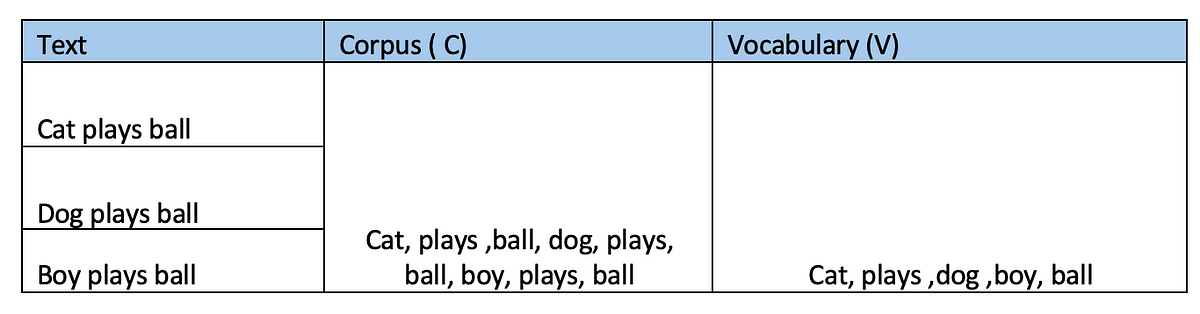
– Cuerpo — Todas las palabras del conjunto de datos
– Vocabulario — Palabras únicas en el conjunto de datos
– Documento — Registros únicos en el conjunto de datos
– Palabra — Cada palabra de un documento
Para simplificar, supongamos que nuestro conjunto de datos tiene solo tres oraciones, la siguiente tabla muestra la diferencia entre el corpus y el vocabulario.
Ahora, cada uno de los tres registros del conjunto de datos anterior se denominará documento (D) y cada palabra del documento será la palabra (W).
Empecemos ahora con las técnicas.
Esta es una de las técnicas más básicas para convertir texto en números.
Utilizaremos el mismo conjunto de datos que el anterior. Nuestro conjunto de datos tiene tres documentos: podemos llamarlos D1, D2 y D3 respectivamente.
Sabemos que el vocabulario (V) es [Cat, plays, dog, boy, ball] que tiene 5 elementos. En One Hot Encoding (OHE), representamos cada una de las palabras de cada documento en función del vocabulario del conjunto de datos. “1” aparece en las posiciones en las que hay una coincidencia.
Por lo tanto, podemos utilizar lo anterior para derivar una representación codificada One Hot de cada uno de los documentos.
Lo que estamos haciendo esencialmente aquí es convertir cada palabra de nuestro documento en un Vector bidimensional donde la primera dimensión es el número de palabras del documento y el segundo valor indica el tamaño del vocabulario. (V=5 en nuestro caso).
Si bien es muy fácil de entender e implementar, este método tiene algunas desventajas por las cuales no se recomienda su uso.
– Representación dispersa (es decir, hay muchos ceros y por cada palabra que ocupa una sola posición hay un 1). Cuanto mayor sea el corpus, mayor será el valor V y mayor será la dispersión.
– Sufre de Sin vocabulario Problemas: es decir, si se introduce una palabra nueva (una palabra que no está presente en V durante el entrenamiento) en el momento de la inferencia, el algoritmo no funciona.
– Por último, y más importante, esto no captura la relación semántica entre las palabras (que es nuestro objetivo principal si recuerda nuestra discusión anterior).
Eso nos lleva a explorar la siguiente técnica.
Es una técnica muy popular y bastante antigua.
El primer paso es volver a crear el vocabulario (V) a partir del conjunto de datos. Luego, comparamos la cantidad de ocurrencias de cada palabra del documento con el vocabulario creado. La siguiente demostración con datos anteriores ayudará a comprender mejor
En el primer documento, “cat” aparece una vez, “plays” aparece una vez y también “ball”. Por lo tanto, 1 es el recuento para cada una de esas palabras y las otras posiciones están marcadas como 0. De manera similar, podemos llegar a los respectivos recuentos para cada uno de los otros dos documentos.
La técnica BOW convierte cada documento en un vector de tamaño igual al Vocabulario V. Aquí obtenemos tres vectores de 5 dimensiones: [1,1,0,0,1], [0,1,1,0,1] y [0,1,0,1,1]
La bolsa de palabras se utiliza en tareas de clasificación y se ha comprobado que funciona bastante bien. Y si observas la tabla, puedes entender que también ayuda a captar la similitud entre las oraciones, al menos un poco. Por ejemplo: “plays” y “ball” aparecen en los tres documentos y, por lo tanto, podemos ver 1 en esas posiciones para los tres documentos.
Ventajas:
– Muy fácil de entender e implementar.
– El problema de longitud fija que se encontró anteriormente no se produce aquí, ya que los recuentos se calculan en función del vocabulario existente, lo que a su vez ayuda a resolver el problema de falta de vocabulario identificado en la técnica anterior. Por lo tanto, si aparece una nueva palabra en los datos en el momento de la inferencia, los cálculos se realizan en función de las palabras existentes y no de las nuevas.
Contras:
– Esta sigue siendo una representación dispersa que es difícil de calcular.
– Aunque no obtenemos errores como antes cuando aparece una nueva palabra, ya que solo se consideran las palabras existentes, en realidad estamos perdiendo información al ignorar las nuevas palabras.
– No tiene en cuenta la secuencia de palabras, ya que el orden de las palabras puede ser muy importante para comprender el texto en cuestión.
– Cuando los documentos tienen palabras comunes la mayor parte del tiempo pero un pequeño cambio puede transmitir un significado opuesto, entonces BOW no funciona. Por ejemplo:
Por ejemplo: Supongamos que hay dos oraciones:
1. Me gusta cuando llueve.
2. No me gusta cuando llueve.
Con la forma en que se calcula BOW, podemos ver que ambas oraciones se considerarán similares ya que todas las palabras excepto “don’t” están presentes en ambas oraciones, pero esa sola palabra cambia completamente el significado de la segunda oración en comparación con la primera.
Esta técnica es similar a BOW que aprendimos hace un momento, pero esta vez, en lugar de palabras individuales, nuestro vocabulario se creará utilizando n-gramas (2 palabras juntas conocidas como bigramas, 3 palabras juntas conocidas como trigramas… o para abordarlo de manera genérica — n palabras juntas conocidas como “n-gramas”)
La técnica de ngramas es una mejora de la técnica Bag of Words, ya que ayuda a captar el significado semántico de las oraciones, al menos hasta cierto punto. Consideremos el ejemplo utilizado anteriormente.
1. Me gusta cuando llueve.
2. No me gusta cuando llueve.
Estas dos oraciones tienen un significado completamente opuesto y, por lo tanto, sus representaciones vectoriales deberían estar muy alejadas.
Cuando utilizamos sólo palabras simples, es decir, BOW con n = 1 o unigramos, su representación vectorial será la siguiente
D1 puede representarse como [1,1,1,1,1,0] mientras que D2 puede representarse como [1,1,1,1,1,1].
D1 y D2 parecen ser muy similares y la diferencia parece darse solo en una dimensión. Por lo tanto, se pueden representar de forma bastante parecida cuando se representan gráficamente en un espacio vectorial.
Ahora, veamos cómo el uso de bigramas puede ser más útil en tal situación.
Con este enfoque podemos ver que los valores no coinciden en tres dimensiones, lo que definitivamente ayuda a representar mejor la disimilitud de las oraciones en el espacio vectorial en comparación con la técnica anterior.
Ventajas
· Es un enfoque muy simple e intuitivo que es fácil de entender e implementar.
· Ayuda a captar el significado semántico del texto, al menos hasta cierto punto.
Contras:
· Es computacionalmente más costoso, ya que en lugar de tokens individuales, ahora usamos una combinación de tokens. El uso de n-gramas aumenta significativamente el tamaño del espacio de características. Por ejemplo, en casos prácticos no trabajaremos con pocas palabras, sino que nuestro vocabulario puede tener miles de palabras, por lo que la cantidad de bigramas posibles será muy alta.
· Este tipo de representación de datos aún es dispersa. Como los n-gramas capturan secuencias específicas de palabras, muchos n-gramas podrían no aparecer con frecuencia en el corpus, lo que daría como resultado una matriz dispersa.
· El problema de OOV aún existe. Si se incluye una nueva oración, se ignorará ya que, de manera similar a la técnica BOW, solo se considerarán las palabras o bigramas existentes en el vocabulario.
Es posible utilizar n-gramas (bigramas, trigramas, etc.) junto con unigramas y puede ayudar a lograr buenos resultados en ciertos casos de uso.
Para las técnicas que hemos discutido hasta ahora, hemos utilizado el valor en cada posición en función de la presencia o ausencia de una palabra/ngrama específico o la frecuencia de la palabra/ngrama.
Esta técnica emplea una lógica única (fórmula) para calcular los pesos de cada palabra en función de dos aspectos:
Frecuencia de término (TF)– Indicador de la frecuencia con la que aparece una palabra en un documento. Es la relación entre el número de veces que aparece una palabra en un documento y el número total de palabras que contiene.
Por otro lado, la frecuencia inversa del documento (IDF) indica la importancia de un término con respecto a todo el corpus.
Fórmula de TF-IDF:
Ahora vamos a realizar el cálculo utilizando nuestro corpus con tres documentos.
1. El gato juega a la pelota (D1)
2. El perro juega a la pelota (D2)
3. El niño juega a la pelota (D3)
Podemos ver en la tabla anterior que el efecto de las palabras que aparecen en todos los documentos (plays y ball) se ha reducido a 0.
Calcular el TF-IDF usando la fórmula TF-IDF(t,d)=TF(t,d)×IDF(t,D)
Podemos ver cómo las palabras comunes “juega” y “pelota” se eliminan y se identifican palabras más importantes como “gato”, “perro” y “niño”.
De esta manera, el enfoque ayuda a: Asigna pesos más altos a las palabras que aparecen con frecuencia en un documento determinado pero que aparecen menos veces en todo el corpus.TF-IDF es muy útil en tareas de aprendizaje automático, como clasificación de texto, recuperación de información, etc.
Ahora pasaremos a aprender una técnica de vectorización más avanzada.
Comenzaré este tema citando la definición de incrustaciones de palabras explicada maravillosamente en enlace
“Las incrustaciones de palabras son una forma de representar palabras como vectores en un espacio multidimensional, donde la distancia y la dirección entre los vectores reflejan la similitud y las relaciones entre las palabras correspondientes”.