
La generación aumentada por recuperación (RAG, por sus siglas en inglés) ha surgido como una aplicación destacada en el campo del procesamiento del lenguaje natural. Este enfoque innovador implica dividir documentos grandes en fragmentos de texto más pequeños y manejables, generalmente limitados a alrededor de 512 tokens. Estos fragmentos de información del tamaño de un bocado se almacenan luego en una base de datos vectorial, y cada fragmento está representado por un vector único generado mediante un modelo de incrustación de texto. Este proceso constituye la base para una recuperación y un procesamiento de información eficientes.
El poder de RAG se hace evidente durante las operaciones de ejecución. Cuando un usuario envía una consulta, entra en juego el mismo modelo de incrustación que procesó los fragmentos almacenados. Codifica la consulta en una representación vectorial, conectando la entrada del usuario con la información almacenada. Este vector se utiliza luego para identificar y recuperar los fragmentos de texto más relevantes de la base de datos, lo que garantiza que solo se acceda a la información más pertinente para su posterior procesamiento.
En octubre de 2023, se alcanzó un hito importante en el procesamiento del lenguaje natural con el lanzamiento de jina-embeddings-v2-base-en, el primer modelo de incrustación de código abierto del mundo con una impresionante longitud de contexto de 8K. Este avance revolucionario generó un debate considerable dentro de la comunidad de IA sobre las aplicaciones prácticas y las limitaciones de los modelos de incrustación de contexto largo. La innovación amplió los límites de lo posible en la representación de texto, pero también planteó preguntas importantes sobre su eficacia en escenarios del mundo real.
A pesar del entusiasmo inicial, muchos expertos comenzaron a cuestionar la viabilidad de codificar documentos extremadamente largos en una única representación integrada. Se hizo evidente que, para numerosas aplicaciones, este enfoque podría no ser ideal. La comunidad de IA reconoció que muchos casos de uso requieren la recuperación de porciones de texto más pequeñas y más específicas en lugar de procesar documentos completos a la vez. Esta constatación condujo a una exploración más profunda de las compensaciones entre la longitud del contexto y la eficiencia de la recuperación.
Además, las investigaciones indican que los sistemas de recuperación de datos basados en vectores densos suelen funcionar de forma más eficaz cuando se trabaja con segmentos de texto más pequeños. El razonamiento que sustenta esta afirmación se basa en el concepto de compresión semántica. Cuando se trabaja con fragmentos de texto más cortos, es menos probable que los vectores de inserción sufran una “sobrecompresión” de la semántica. Esto significa que los significados y contextos matizados dentro del texto se conservan mejor, lo que conduce a resultados de recuperación más precisos y relevantes en diversas aplicaciones.
El debate en torno a los modelos de incrustación de contextos extensos ha llevado a un creciente consenso en cuanto a que incrustar fragmentos de texto más pequeños suele ser más ventajoso. Esta preferencia se debe a dos factores clave: los tamaños de entrada limitados de los modelos de lenguaje grandes (LLM) posteriores y la preocupación de que la información contextual crucial pueda diluirse al comprimir pasajes extensos en una única representación vectorial. Estas limitaciones han hecho que muchos cuestionen el valor práctico de los modelos de entrenamiento con longitudes de contexto extensas, como 8192 tokens.
Sin embargo, descartar por completo los modelos de contexto largo sería prematuro. Si bien la industria puede requerir predominantemente modelos de incrustación con una longitud de contexto de 512 tokens, aún existen razones convincentes para explorar y desarrollar modelos con mayor capacidad. Este artículo tiene como objetivo abordar esta importante, aunque incómoda, pregunta al examinar las limitaciones de la secuencia de fragmentación-incrustación convencional utilizada en los sistemas RAG. Para ello, los investigadores presentan un enfoque único llamado “Fragmentación tardía.“
“La implementación de la fragmentación tardía se puede encontrar en Google Colab enlace“
El método de fragmentación tardía representa un avance significativo en el uso de la rica información contextual proporcionada por los modelos de incrustación de longitud 8192. Esta técnica innovadora ofrece una forma más eficaz de incrustar fragmentos, lo que potencialmente cierra la brecha entre las capacidades de los modelos de contexto largo y las necesidades prácticas de varias aplicaciones. Al explorar este enfoque, los investigadores buscan demostrar el potencial sin explotar de las longitudes de contexto extendidas en los modelos de incrustación.
El flujo de trabajo RAG convencional, que implica fragmentación, incrustación, recuperación y generación, enfrenta desafíos importantes. Uno de los problemas más urgentes es la destrucción de dependencias contextuales de larga distancia. Este problema surge cuando la información relevante se distribuye en múltiples fragmentos, lo que hace que los segmentos de texto pierdan su contexto y se vuelvan ineficaces cuando se los analiza de forma aislada.
Un claro ejemplo de este problema se puede observar en la fragmentación de un artículo de Wikipedia sobre Berlín. Cuando se divide en fragmentos del tamaño de una oración, las referencias cruciales como “its” y “the city” se desconectan de su antecedente, “Berlin”, que aparece solo en la primera oración. Esta separación dificulta que el modelo de incrustación cree representaciones vectoriales precisas que mantengan estas conexiones importantes.
Las consecuencias de esta fragmentación contextual se hacen evidentes cuando se considera una consulta como “¿Cuál es la población de Berlín?”. En un sistema RAG que utiliza fragmentos de texto de la longitud de una oración, responder a esta pregunta se vuelve problemático. El nombre de la ciudad y los datos de su población pueden no aparecer nunca juntos en un solo fragmento, y sin un contexto documental más amplio, un LLM tiene dificultades para resolver referencias anafóricas como “eso” o “la ciudad”.
Si bien se han desarrollado diversas heurísticas para abordar este problema, incluido el remuestreo con ventanas deslizantes, el uso de longitudes de ventana de contexto múltiples y la realización de escaneos de documentos en múltiples pasadas, estas soluciones siguen siendo imperfectas. Como todas las heurísticas, su eficacia es inconsistente y carece de garantías teóricas. Esta limitación resalta la necesidad de enfoques más sólidos para mantener la integridad contextual en los sistemas RAG.
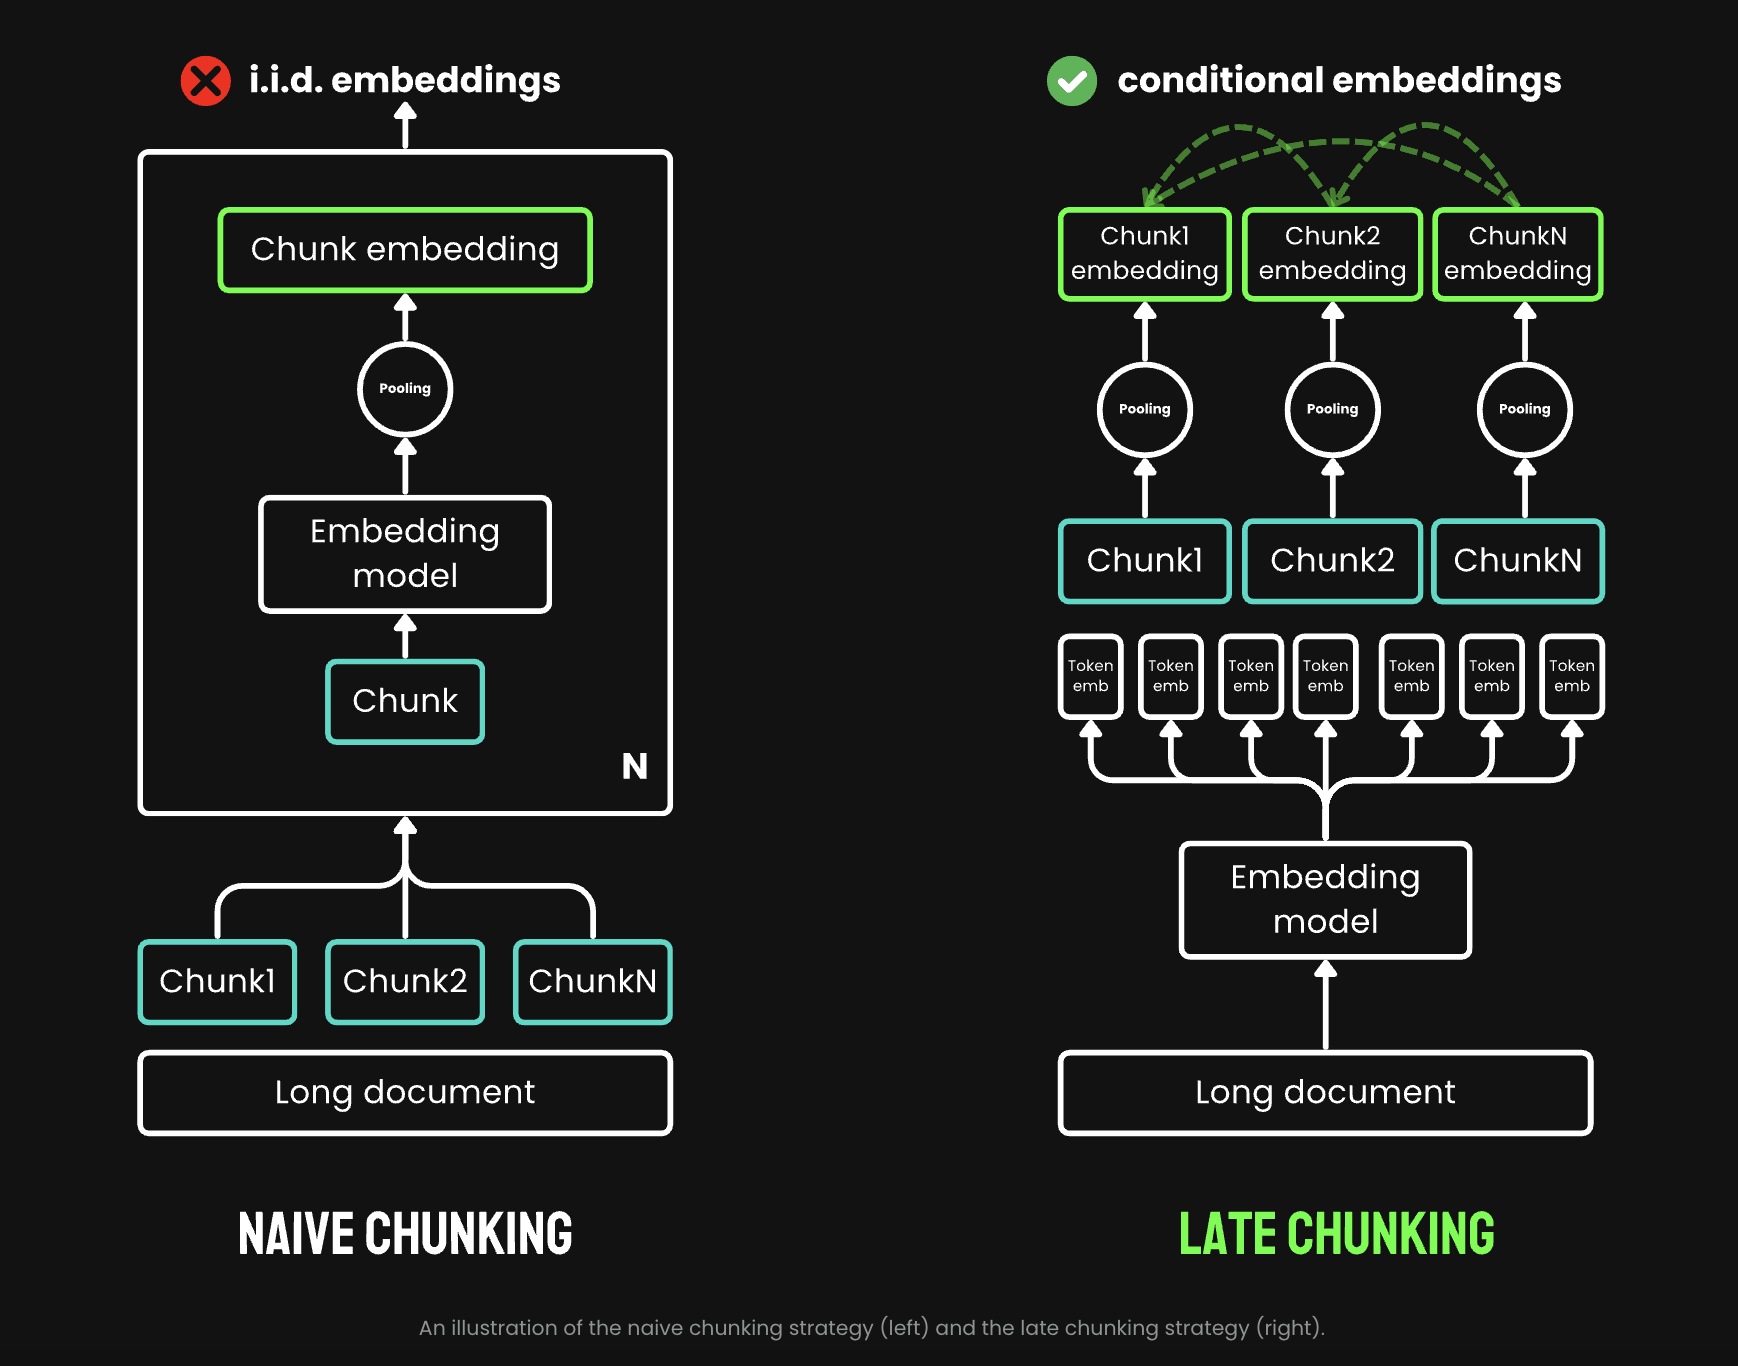
El enfoque de codificación ingenua, que se utiliza habitualmente en muchos sistemas RAG, emplea un método sencillo pero potencialmente problemático para procesar textos largos. Este enfoque, ilustrado en el lado izquierdo de la imagen de referencia, comienza dividiendo el texto en unidades más pequeñas antes de cualquier codificación. Estas unidades suelen estar definidas por oraciones, párrafos o límites de longitud máxima predeterminados.
Una vez que el texto se divide en estos fragmentos, se aplica un modelo de incrustación repetidamente a cada segmento. Este proceso genera incrustaciones a nivel de token para cada palabra o subpalabra dentro de cada fragmento. Para crear una única incrustación representativa para todo el fragmento, muchos modelos de incrustación utilizan una técnica denominada agrupación de medias. Este método implica calcular el promedio de todas las incrustaciones a nivel de token dentro del fragmento, lo que da como resultado un único vector de incrustación.
Si bien este enfoque es eficiente desde el punto de vista computacional y fácil de implementar, tiene desventajas significativas. Al dividir el texto antes de codificarlo, se corre el riesgo de perder información contextual importante que se extiende a través de los límites de los fragmentos. Además, la técnica de agrupamiento de medias, si bien es simple, puede no siempre capturar las relaciones matizadas entre las diferentes partes del texto de manera efectiva, lo que puede llevar a la pérdida de información semántica.

El método de “fragmentación tardía” representa un avance significativo en el procesamiento de texto para sistemas RAG. A diferencia del método ingenuo, aplica primero la capa de transformador a todo el texto, generando vectores de tokens que capturan toda la información contextual. Luego se aplica la agrupación de medias a fragmentos de estos vectores, creando incrustaciones que consideran el contexto de todo el texto. Este método produce incrustaciones de fragmentos que están “condicionadas a” los anteriores, codificando más información contextual que las incrustaciones independientes del método ingenuo. La implementación de la fragmentación tardía requiere modelos de incrustación de contexto largo como jina-embeddings-v2-base-en, que puede manejar hasta 8192 tokens. Si bien las señales de límite siguen siendo necesarias, se aplican después de obtener incrustaciones a nivel de token, lo que preserva una mayor integridad contextual.
Para validar la eficacia de la fragmentación tardía, los investigadores realizaron pruebas utilizando los parámetros de recuperación de BeIR. Estas pruebas implicaron conjuntos de consultas, corpus de documentos de texto y archivos QRels que contenían información sobre documentos relevantes para cada consulta. Los resultados mostraron consistentemente puntuaciones mejoradas para la fragmentación tardía en comparación con el enfoque ingenuo. En algunos casos, la fragmentación tardía incluso superó a la codificación de documentos completos con una sola incrustación. Además, surgió una correlación entre la longitud del documento y la mejora del rendimiento lograda mediante la fragmentación tardía. A medida que aumentaba la longitud del documento, la eficacia de la estrategia de fragmentación tardía se hizo más pronunciada, lo que demostró su valor particular para procesar textos más largos en tareas de recuperación.
Este estudio introdujo “fragmentación tardía”, un enfoque innovador que utiliza modelos de incrustación de contexto largo para mejorar el procesamiento de texto en sistemas RAG. Al aplicar la capa de transformador a textos completos antes de la fragmentación, este método preserva información contextual crucial que a menudo se pierde en la incrustación de fragmentos iid tradicional. La efectividad de la fragmentación tardía aumenta con la longitud del documento, lo que resalta la importancia de modelos avanzados como jina-embeddings-v2-base-en que pueden manejar contextos extensos. Esta investigación no solo valida la importancia de los modelos de incrustación de contexto largo, sino que también abre caminos para una mayor exploración en el mantenimiento de la integridad contextual en las tareas de procesamiento y recuperación de texto.
Echa un vistazo a la Detalles y Cuaderno de Colab. Todo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de Telegram y LinkedIn Gr¡Arriba!. Si te gusta nuestro trabajo, te encantará nuestro hoja informativa..
No olvides unirte a nuestro Subreddit con más de 50 000 millones de usuarios
A continuación se muestra un seminario web muy recomendado por nuestro patrocinador: ‘Desarrollo de aplicaciones de IA de alto rendimiento con NVIDIA NIM y Haystack’

Asjad es consultor en prácticas en Marktechpost. Está cursando la licenciatura en ingeniería mecánica en el Instituto Indio de Tecnología de Kharagpur. Asjad es un entusiasta del aprendizaje automático y del aprendizaje profundo que siempre está investigando las aplicaciones del aprendizaje automático en el ámbito de la atención médica.