
Los modelos de lenguaje grande (LLM) han adquirido cada vez mayor importancia en materia de ciberseguridad, en particular en su aplicación a prácticas de codificación seguras. Como estos modelos impulsados por IA pueden generar texto similar al humano, ahora se utilizan para detectar y mitigar vulnerabilidades de seguridad en el software. El objetivo principal es aprovechar estos modelos para mejorar la seguridad del código, lo que es esencial para prevenir posibles ciberataques y garantizar la integridad de los sistemas de software. La integración de la IA en la ciberseguridad representa un avance significativo en la automatización de la identificación y resolución de vulnerabilidades de código, que tradicionalmente se ha basado en procesos manuales.
Un problema acuciante en materia de ciberseguridad es la presencia persistente de vulnerabilidades en el código de software que pueden ser explotadas por actores maliciosos. Estas vulnerabilidades suelen surgir de errores de codificación simples o fallas de seguridad que se pasan por alto durante el desarrollo del software. Los métodos tradicionales, como las revisiones manuales de código y el análisis estático, solo son eficaces en ocasiones para detectar todas las vulnerabilidades posibles, especialmente a medida que los sistemas de software se vuelven cada vez más complejos. El desafío radica en desarrollar soluciones automatizadas que puedan identificar y solucionar con precisión estos problemas antes de que se exploten, mejorando así la seguridad general del software.
Las herramientas actuales para la codificación segura incluyen analizadores estáticos como CodeQL y Bandit, que se utilizan ampliamente en la industria para escanear bases de código en busca de vulnerabilidades de seguridad conocidas. Estas herramientas funcionan analizando el código sin ejecutarlo e identificando posibles fallas de seguridad según patrones y reglas predefinidos. Sin embargo, si bien estas herramientas detectan de manera efectiva las vulnerabilidades comunes, están limitadas por su dependencia de reglas predefinidas, que pueden no tener en cuenta amenazas de seguridad nuevas o complejas. Además, se han desarrollado herramientas de reparación automática de programas (APR) para corregir errores en el código automáticamente. Sin embargo, estas herramientas generalmente se centran en problemas más simples y a menudo no abordan vulnerabilidades más complejas, lo que deja brechas en la seguridad del código.
Investigadores de la Universidad Tecnológica de Chalmers en Suecia han presentado LLMSecCode, un innovador marco de código abierto diseñado para evaluar las capacidades de codificación segura de los LLM. Este marco representa un avance significativo en la estandarización y evaluación comparativa de los LLM para tareas de codificación segura. LLMSecCode proporciona una plataforma integral para evaluar la eficacia de los distintos LLM para generar código seguro y reparar vulnerabilidades. Al integrar este marco, los investigadores pretenden agilizar el proceso de evaluación de los LLM, facilitando la determinación de qué modelos son más eficaces para la codificación segura. La naturaleza de código abierto del marco también fomenta un mayor desarrollo y colaboración dentro de la comunidad de investigación.
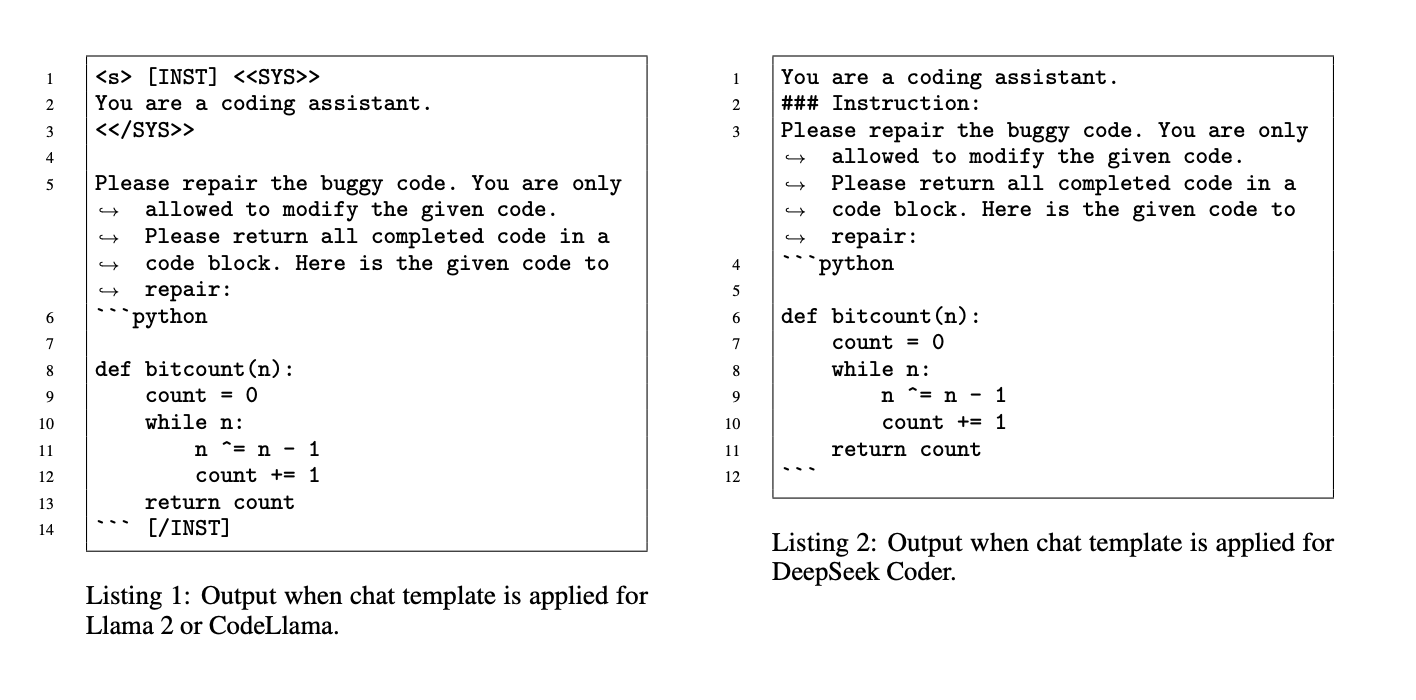
El marco LLMSecCode funciona modificando parámetros clave de los LLM, como la temperatura y el punto máximo, que son cruciales para determinar el resultado del modelo. Al ajustar estos parámetros, los investigadores pueden observar cómo los cambios afectan la capacidad del LLM para generar código seguro e identificar vulnerabilidades. El marco admite varios LLM, incluidos CodeLlama y DeepSeekCoder, entre los modelos de vanguardia actuales en codificación segura. LLMSecCode también permite la personalización de las indicaciones, lo que permite a los investigadores adaptar las tareas a necesidades específicas. Esta personalización es esencial para evaluar el rendimiento del modelo en escenarios de codificación segura. El marco está diseñado para ser adaptable y escalable, lo que lo hace adecuado para varias tareas de codificación segura.

El rendimiento de LLMSecCode se probó rigurosamente utilizando varios LLM, lo que arrojó información significativa sobre sus capacidades. Los investigadores descubrieron que DeepSeek Coder 33B Instruct logró un éxito notable en las tareas de reparación automática de programas (APR), resolviendo hasta el 78,7 % de los desafíos que se le presentaron. En cambio, Llama 2 7B Chat se destacó en las tareas relacionadas con la seguridad, ya que el 76,5 % de su código generado estuvo libre de vulnerabilidades. Estas cifras resaltan las diferentes fortalezas de los diferentes LLM y subrayan la importancia de seleccionar el modelo correcto para tareas específicas. Además, el marco demostró una diferencia del 10 % en el rendimiento al variar los parámetros del modelo y una diferencia del 9 % al modificar las indicaciones, lo que muestra la sensibilidad de los LLM a estos factores. Los investigadores también compararon los resultados de LLMSecCode con los de actores externos confiables y encontraron solo una diferencia del 5 %, lo que da fe de la precisión y confiabilidad del marco.
En conclusión, la investigación realizada por el equipo de la Universidad Tecnológica de Chalmers presenta a LLMSecCode como una herramienta innovadora para evaluar las capacidades de codificación segura de los LLM. Al proporcionar un marco de evaluación estandarizado, LLMSecCode ayuda a identificar los LLM más eficaces para la codificación segura, contribuyendo así al desarrollo de sistemas de software más seguros. Los hallazgos enfatizan la importancia de seleccionar el modelo apropiado para tareas de codificación específicas y demuestran que, si bien los LLM han logrado avances significativos en la codificación segura, aún hay margen para mejorar y realizar más investigaciones.
Echa un vistazo a la Papel. Todo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y LinkedInÚnete a nuestro Canal de Telegram. Si te gusta nuestro trabajo, te encantará nuestro hoja informativa..
No olvides unirte a nuestro Subreddit con más de 50 000 millones de usuarios

Nikhil es consultor en prácticas en Marktechpost. Está cursando una doble titulación integrada en Materiales en el Instituto Indio de Tecnología de Kharagpur. Nikhil es un entusiasta de la IA y el aprendizaje automático que siempre está investigando aplicaciones en campos como los biomateriales y la ciencia biomédica. Con una sólida formación en ciencia de los materiales, está explorando nuevos avances y creando oportunidades para contribuir.