
Una respuesta y muchas prácticas recomendadas sobre cómo las organizaciones más grandes pueden implementar programas de calidad de datos para plataformas de datos modernas

He hablado con docenas de profesionales de datos empresariales de las corporaciones más grandes del mundo, y una de las preguntas más comunes sobre calidad de datos es: “¿quién hace qué?”. A esto le sigue rápidamente: “¿por qué y cómo?”.
Hay una razón para esto. La calidad de los datos es como una carrera de relevos. El éxito de cada etapa (detección, clasificación, resolución y medición) depende de las demás. Cada vez que se pasa el testigo, las probabilidades de fracaso se disparan.
Las preguntas prácticas merecen respuestas prácticas.
Sin embargo, cada organización se organiza en torno a los datos de forma ligeramente diferente. He visto organizaciones con 15.000 empleados que centralizan la propiedad de todos los datos críticos, mientras que organizaciones de la mitad de su tamaño deciden federar por completo la propiedad de los datos en todos los dominios empresariales.
Para los fines de este artículo, haré referencia a la arquitectura empresarial más común, que es un híbrido de las dos. Esta es la aspiración de la mayoría de los equipos de datos y también presenta muchas responsabilidades entre equipos que la hacen particularmente compleja y digna de ser analizada.
Simplemente tenga en cuenta que lo que sigue es UNA respuesta, no LA respuesta.
En este artículo:
Ya sea que esté persiguiendo un malla de datos Ya sea una estrategia o algo completamente distinto, una constatación común para los equipos de datos modernos es la necesidad de alinearse e invertir en sus datos más valiosos. productos de datos.
Se trata de una denominación que se da a un conjunto de datos, una aplicación o un servicio con un resultado particularmente valioso para la empresa. Puede tratarse de una aplicación de aprendizaje automático que genere ingresos o de un conjunto de conocimientos derivados de datos bien seleccionados.
A medida que la escala y la sofisticación crecen, los equipos de datos diferenciarán aún más entre Productos de datos fundamentales y derivadosUn producto de datos fundamental suele ser propiedad de un equipo de plataforma de datos central (o, a veces, de un equipo de ingeniería de datos alineado con la fuente). Están diseñados para servir a cientos de casos de uso en muchos equipos o dominios comerciales.
Los productos de datos derivados se construyen sobre estos productos de datos básicos. Son propiedad de equipos de datos alineados con el dominio y están diseñados para un caso de uso específico.
Por ejemplo, una “visión única del cliente” es un producto de datos fundamental común que podría alimentar productos de datos derivados, como un modelo de venta adicional de productos, pronósticos de abandono y un panel empresarial.
Existen diferentes procesos para detectar, clasificar, resolver y medir incidentes de calidad de datos en estos dos tipos de productos de datos. Es fundamental salvar la brecha que los separa. He visto que los equipos de datos utilizan una forma popular de hacerlo.
Productos de datos fundamentales
Antes de que se pueda descubrir, debe haber un nombre designado Propietario de ingeniería de plataforma de datos para cada Producto de datos fundamental. Este es el equipo responsable de aplicar el control de la frescura, el volumen, el esquema y la calidad de referencia de principio a fin en todo el proceso de producción. Una buena regla general que siguen la mayoría de los equipos es: “lo creaste, es tuyo”.
Por calidad de base, me refiero muy específicamente a requisitos que pueden generalizarse ampliamente a muchos conjuntos de datos y dominios. A menudo, los define un equipo de gobernanza central para elementos de datos críticos y, por lo general, se ajustan a las 6 dimensiones de la calidad de los datosRequisitos como “las columnas de identificación siempre deben ser únicas” o “este campo siempre tiene el formato de código de estado válido de EE. UU.”.
En otras palabras, los propietarios de productos de datos básicos no pueden simplemente garantizar que los datos lleguen a tiempo. Deben asegurarse de que los datos de origen estén completos y sean válidos; que los datos sean consistentes en todas las fuentes y cargas posteriores; y que los campos críticos estén libres de errores. Los modelos de detección de anomalías de aprendizaje automático pueden ser particularmente eficaces en este sentido.
Los requisitos de calidad de datos más precisos y personalizados suelen depender del caso de uso y son mejor aplicados por los propietarios de productos de datos derivados y los analistas posteriores.
Productos de datos derivados
El monitoreo de la calidad de los datos también debe realizarse a nivel del producto de datos derivado, ya que los datos erróneos pueden infiltrarse en cualquier punto del ciclo de vida de los datos.
Sin embargo, en este nivel hay más superficie que cubrir. “Monitorear todas las mesas para cada posibilidad” no es una opción práctica.
Existen muchos factores que determinan cuándo una colección de tablas debería convertirse en un producto de datos derivado, pero todos ellos pueden resumirse en un juicio de valor sostenido. Esto suele ejecutarse mejor mediante administradores de datos basados en dominios que estén cerca de la empresa y estén capacitados para seguir pautas generales sobre la frecuencia y criticidad del uso.
Por ejemplo, uno de mis colegas, en su puesto anterior como jefe de la plataforma de datos en una empresa de medios nacional, encargó a un analista que desarrollara un panel de control de contenido maestro que rápidamente se hizo popular en toda la sala de redacción. Una vez que se integró en el flujo de trabajo de una cantidad suficiente de usuarios, se dieron cuenta de que este panel de control ad hoc debía convertirse en un producto.
Cuando se crea o identifica un producto de datos derivado, debe tener un propietario alineado con el dominio responsable del monitoreo de extremo a extremo y la calidad de los datos de referencia. Para muchas organizaciones, estos serán administradores de datos de dominio, ya que están más familiarizados con las políticas globales y locales. Otros modelos de propiedad incluyen la designación del ingeniero de datos integrados que creó la cadena de productos de datos derivados o el analista que posee la tabla de última milla.
La otra diferencia clave en el flujo de trabajo de detección a nivel de producto de datos derivados son las reglas comerciales.
Existen algunas reglas de calidad de datos que no se pueden automatizar ni generar a partir de estándares centrales. Solo pueden surgir de la empresa. Reglas como, “el campo discount_percentage nunca puede ser mayor a 10 cuando account_type es igual a comercial y customer_region es igual a EMEA”.
Estas reglas las aplican mejor los analistas, específicamente el propietario de la tabla, basándose en su experiencia y los comentarios de la empresa. No es necesario que cada regla active la creación de un producto de datos, ya que es demasiado pesado y engorroso. Este proceso debería ser completamente descentralizado, autogestionado y liviano.
Productos de datos fundamentales
En cierto modo, garantizar la calidad de los datos de los productos básicos es menos complejo que en el caso de los productos derivados. Por definición, hay menos productos básicos y, por lo general, son propiedad de equipos técnicos.
Esto significa que el propietario del producto de datos, o un ingeniero de datos de guardia dentro del equipo de la plataforma, puede ser responsable de las tareas de clasificación comunes. como responder a alertas, determinar un punto de origen probable, evaluar la gravedad y comunicarse con los consumidores.
Cada producto de datos fundamental debe tener al menos un canal de alerta dedicado en Slack o Teams.
Esto evita la fatiga por alertas y puede servir como un canal de comunicación central para todos los propietarios de productos de datos derivados con dependencias. En la medida que lo deseen, pueden mantenerse al tanto de los problemas y recibir información proactiva sobre cualquier cambio futuro en el esquema u otros cambios que puedan afectar sus operaciones.
Productos de datos derivados
Normalmente, hay demasiados productos de datos derivados como para que los ingenieros de datos puedan clasificarlos adecuadamente dado su ancho de banda.
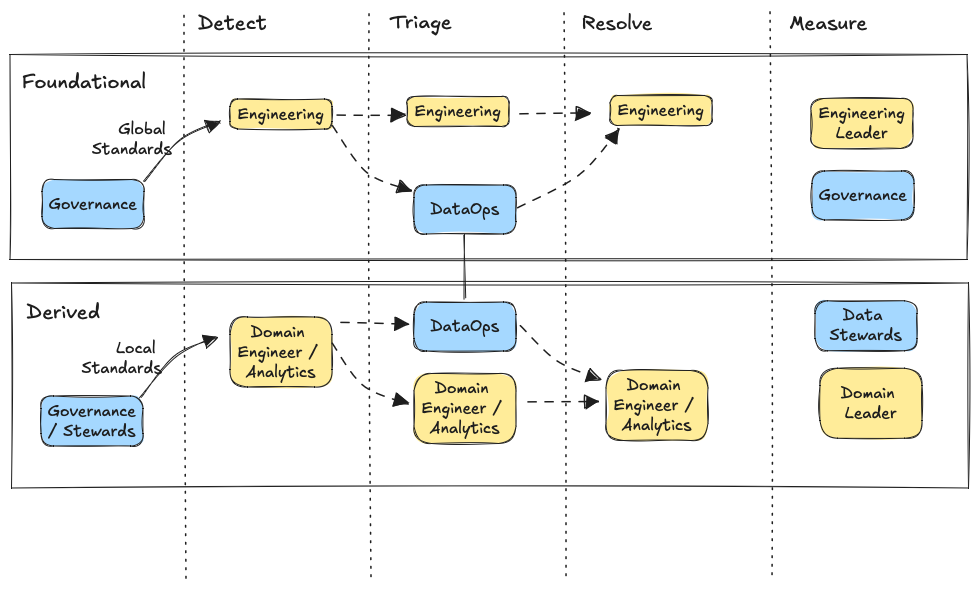
Hacer que cada propietario de un producto de datos derivado sea responsable de clasificar las alertas es una estrategia comúnmente implementada (ver la imagen a continuación), pero también puede fallar a medida que aumenta la cantidad de dependencias.
Por ejemplo, un trabajo de orquestación fallido puede tener consecuencias en cadena y generar docenas de alertas para varios propietarios de productos de datos. Los simulacros de incendio superpuestos son una pesadilla.
Una práctica recomendada cada vez más adoptada es contar con un equipo de clasificación dedicado (a menudo denominado dataops) para respaldar todos los productos dentro de un dominio determinado.
Esta puede ser una zona ideal que aproveche las ventajas de la especialización, sin llegar a ser tan imposiblemente grande como para convertirse en un cuello de botella carente de contexto. Estos equipos debe ser entrenado y capacitado para trabajar en todos los dominios, o simplemente reintroducirá los silos y los simulacros de incendio superpuestos.
En este modelo, el propietario del producto de datos tiene responsabilidad, pero no rendición de cuentas.
Encuesta de Wakefield Research Más de 200 profesionales de datos, y el promedio de incidentes por mes fue de 60 y el tiempo medio para resolver cada incidente una vez detectado fue de 15 horas. Es fácil ver cómo los ingenieros de datos quedan enterrados en el trabajo atrasado.
Hay muchos factores que contribuyen a esto, pero el más importante es que hemos separado la anomalía de la causa raíz, tanto a nivel tecnológico como procedimental. Los ingenieros de datos se encargan de sus procesos y los analistas de sus métricas. Los ingenieros de datos configuran sus alertas de Airflow y los analistas escriben sus reglas SQL.
Pero los pipelines (las fuentes de datos, los sistemas que mueven los datos y el código que los transforma) son la causa principal de que se produzcan anomalías métricas..
Para reducir el tiempo promedio de resolución, estos solucionadores de problemas técnicos necesitan una plataforma de observación de datos o algún tipo de plano de control central que conecte la anomalía con la causa raíz. Por ejemplo, una solución que muestre cómo una anomalía de distribución en el campo discount_amount se relaciona con un cambio en una consulta anterior que ocurrió al mismo tiempo.
Productos de datos fundamentales
Hablando de comunicaciones proactivas, medir y poner de manifiesto la salud de los productos de datos fundamentales es vital para su adopción y éxito. Si los dominios consumidores posteriores no confían en la calidad de los datos o en la fiabilidad de su entrega, acudirán directamente a la fuente. Todas. Las. Veces.
Por supuesto, esto frustra por completo el propósito de los productos de datos básicos. Las economías de escala, los controles de gobernanza de incorporación estándar y la visibilidad clara de la procedencia y el uso ahora están fuera de juego.
Puede resultar complicado proporcionar un estándar general de calidad de datos que sea aplicable a un conjunto diverso de casos de uso. Sin embargo, lo que los equipos de datos posteriores realmente quieren saber es:
- ¿Con qué frecuencia se actualizan los datos?
- ¿Qué tan bien se mantiene? ¿Con qué rapidez se resuelven los incidentes?
- ¿Habrá cambios frecuentes en el esquema que interrumpan mis canalizaciones?
Los equipos de gobernanza de datos pueden ayudar aquí descubriendo estos requisitos comunes y elementos de datos críticos para ayudar a establecer y presentar SLA inteligentes en un mercado o catálogo (más detalles de los que podría desear sobre la implementación) aquí).
Este es el Enfoque del equipo de datos de Roche que ha creado una de las mallas de datos empresariales más exitosas del mundo, que ellos estiman Ha generado alrededor de 200 productos de datos y un valor estimado de 50 millones de dólares.
Productos de datos derivados
En el caso de los productos de datos derivados, se deben establecer acuerdos de nivel de servicio explícitos en función del caso de uso definido. Por ejemplo, un informe financiero puede necesitar ser muy preciso y tener cierto margen de puntualidad, mientras que un modelo de aprendizaje automático puede ser exactamente lo opuesto.
Las puntuaciones de estado de las tablas pueden ser útiles, pero el error más común es suponer que en una tabla compartida las reglas de negocio colocadas por un analista serán relevantes para otro. Una tabla parece ser de baja calidad, pero al examinarla más de cerca, algunas reglas obsoletas han fallado repetidamente día tras día sin que se haya tomado ninguna medida para resolver el problema o el umbral de la regla.
Hemos cubierto mucho terreno. Este artículo fue más una maratón que una carrera de relevos.
Los flujos de trabajo anteriores son a Una forma de tener éxito con los programas de calidad y observabilidad de datos, pero no lo son. el único manera. Si priorizas procesos claros para:
- Creación y propiedad de productos de datos;
- Aplicar cobertura de extremo a extremo en todos esos productos de datos;
- Reglas de negocio de autoservicio para activos posteriores;
- Responder e investigar alertas;
- Acelerar el análisis de causa raíz; y
- Generar confianza mediante la comunicación de la salud de los datos y la respuesta operativa
…verá que su equipo cruza la línea de meta en materia de calidad de datos.
Sígueme en Medium para más historias sobre ingeniería de datos, calidad de datos y temas relacionados.