
Universidad Hebrea Los investigadores abordaron el desafío de comprender cómo fluye la información a través de diferentes capas de modelos de lenguaje grandes (LLM) basados en decodificadores. En concreto, investigan si los estados ocultos de tokens anteriores en capas superiores son tan cruciales como se cree. Los LLM actuales, como los modelos basados en transformadores, utilizan el mecanismo de atención para procesar tokens prestando atención a todos los tokens anteriores en cada capa. Si bien cada capa de transformador aplica esta atención de manera uniforme, investigaciones anteriores indican que diferentes capas capturan diferentes tipos de información. El estudio se basa en la idea de que no todas las capas pueden depender por igual de los estados ocultos de tokens anteriores, especialmente en capas superiores.
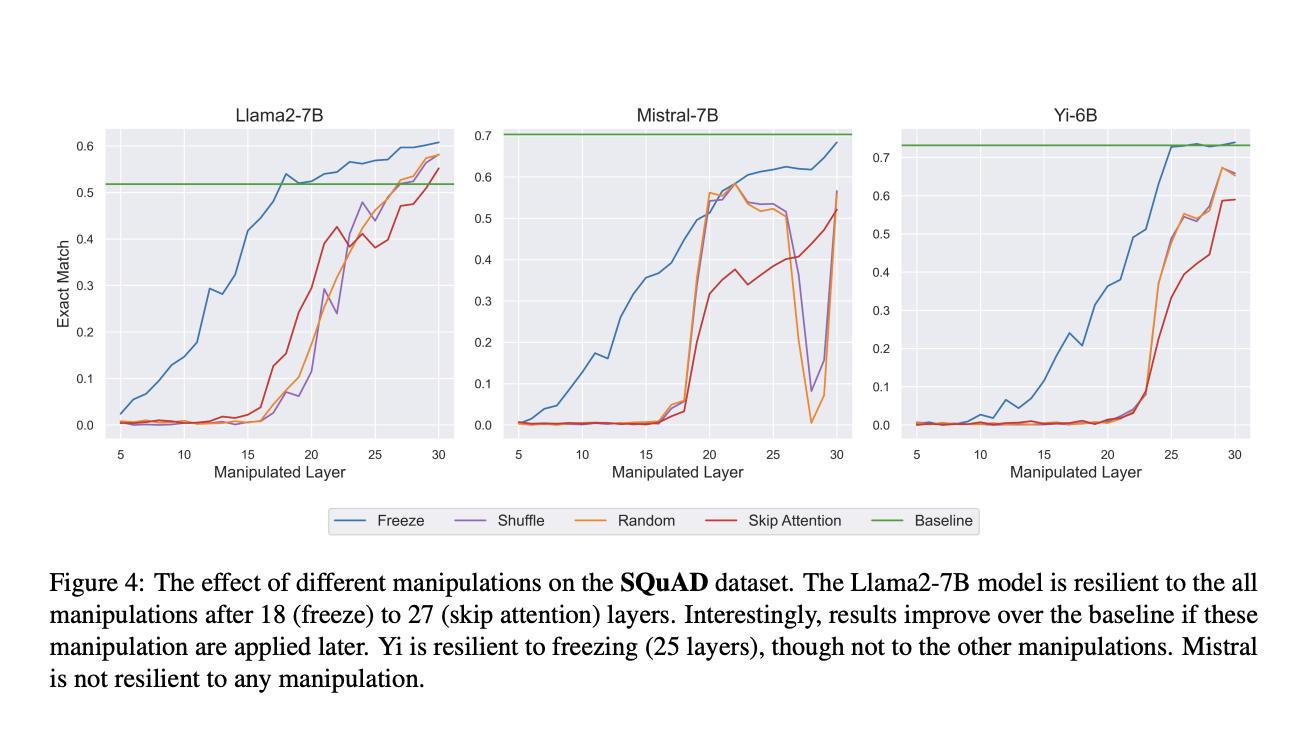
El equipo de investigación planteó la hipótesis de que, mientras que las capas inferiores se centran en la agregación de información de tokens anteriores, las capas superiores pueden depender menos de esta información. Proponen varias manipulaciones en los estados ocultos de tokens anteriores en diferentes capas del modelo. Estas incluyen reemplazar estados ocultos con vectores aleatorios, congelar estados ocultos en capas específicas e intercambiar los estados ocultos de un token con otro de un mensaje diferente. Realizan experimentos en cuatro LLM de código abierto (Llama2-7B, Mistral-7B, Yi-6B y Llemma-7B) y cuatro tareas, que incluyen respuesta a preguntas y resumen, para evaluar el impacto de estas manipulaciones en el rendimiento del modelo.
Una técnica consiste en introducir ruido mediante la sustitución de estados ocultos por vectores aleatorios, lo que permite a los investigadores evaluar si el contenido de estos estados ocultos sigue siendo importante en determinadas capas. El segundo método, la congelación, bloquea los estados ocultos en una capa concreta y los reutiliza para las capas siguientes, lo que reduce la carga computacional.
Los investigadores descubrieron que cuando se aplicaron estas manipulaciones al 30-50% superior del modelo, el rendimiento en múltiples tareas experimentó poca o ninguna caída, lo que sugiere que las capas superiores dependen menos de las representaciones ocultas de tokens anteriores. Por ejemplo, al congelar hasta el 50% de las capas, los modelos mantuvieron un rendimiento similar al de la línea base. Además, intercambiar estados ocultos de diferentes indicaciones confirmó aún más esta observación; el modelo ignoró los cambios realizados en las capas superiores, mientras que los cambios en las capas inferiores alteraron significativamente el resultado. Los experimentos se llevaron a cabo para comprender si se necesitaba atención en las capas superiores del modelo saltando el bloque de atención en esas capas. Esta prueba demostró que saltarse la atención en las capas superiores tuvo un impacto mínimo en tareas como resumir y responder preguntas, mientras que hacerlo en las capas inferiores provocó una degradación grave del rendimiento.
En conclusión, el estudio revela un proceso de dos fases en los LLM basados en transformadores: las primeras capas recopilan información de tokens anteriores, mientras que las capas superiores procesan esa información principalmente de forma interna. Los hallazgos sugieren que las capas superiores dependen menos de la representación detallada de tokens anteriores, lo que ofrece posibles optimizaciones, como omitir la atención en estas capas para reducir los costos computacionales. En general, el artículo profundiza en la naturaleza jerárquica del procesamiento de la información en los LLM y conduce a diseños de modelos más informados y eficientes.
Echa un vistazo a la PapelTodo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de Telegram y LinkedIn Gr¡Arriba!. Si te gusta nuestro trabajo, te encantará nuestro hoja informativa..
No olvides unirte a nuestro Subreddit con más de 50 000 millones de usuarios
Pragati Jhunjhunwala es pasante de consultoría en MarktechPost. Actualmente está cursando su licenciatura en tecnología en el Instituto Indio de Tecnología (IIT) de Kharagpur. Es una entusiasta de la tecnología y tiene un gran interés en el ámbito de las aplicaciones de software y ciencia de datos. Siempre está leyendo sobre los avances en diferentes campos de la IA y el ML.