
Guía práctica para crear un modelo de lenguaje para tareas de MLM desde cero utilizando la biblioteca Python y Transformers

En los últimos años, los grandes modelos de lenguajes (LLM) han acaparado toda la atención de la comunidad de aprendizaje automático. Antes de que aparecieran los LLM, tuvimos una fase de investigación crucial sobre varias técnicas de modelado del lenguaje, incluido el modelado del lenguaje enmascarado, el modelado del lenguaje causal y el modelado del lenguaje secuencia a secuencia.
De la lista anterior, los modelos de lenguaje enmascarado como BERT se volvieron más utilizables en tareas posteriores de PNL, como la clasificación y la agrupación. Gracias a bibliotecas como Hugging Face Transformers, la adaptación de estos modelos para tareas posteriores se volvió más accesible y manejable. Además, gracias a la comunidad de código abierto, tenemos muchos modelos de idiomas para elegir que cubren idiomas y dominios ampliamente utilizados.
Al adaptar los modelos de lenguaje existentes a sus casos de uso específicos, a veces podemos usar los modelos existentes sin realizar más ajustes (el llamado ajuste fino). Por ejemplo, si desea un modelo de detección de intención/sentimiento en inglés, puede ingresar a HuggingFace.co y encontrar un modelo adecuado para su caso de uso.
Sin embargo, esto sólo puede esperarse para algunas de las tareas que se encuentran en el mundo real. Ahí es donde necesitamos una técnica adicional llamada ajuste fino. Primero, debes elegir un modelo base que será afinado. En este caso, debe tener cuidado con el modelo seleccionado y la similitud léxica de su idioma de destino.
Sin embargo, si no puede encontrar un modelo adecuado reentrenado en el idioma deseado, considere crear uno desde cero. En este tutorial, implementaremos el modelo BERT para el modelo de lenguaje enmascarado.
Aunque describir la arquitectura BERT está fuera del alcance de este tutorial, en aras de la claridad, repasémosla de manera muy detallada. BERT, o Bidireccional micodificador Rrepresentaciones de transformers, pertenece a la familia de transformadores solo codificadores. Fue introducido en el año 2018 por investigadores de Google.
Resumen del artículo:
Nosotros introducir un nuevo modelo de representación de lenguaje llamado BERT, que significa Representaciones de codificador bidireccional de Transformers. A diferencia de los modelos recientes de representación de lenguaje, BERT está diseñado para entrenar previamente representaciones bidireccionales profundas a partir de texto sin etiquetar acondicionando conjuntamente el contexto izquierdo y derecho en todas las capas. Como resultado, el modelo BERT previamente entrenado se puede ajustar con solo una capa de salida adicional para crear modelos de última generación para una amplia gama de tareas, como la respuesta a preguntas y la inferencia del lenguaje, sin tareas sustanciales. modificaciones específicas de la arquitectura.
BERT es conceptualmente simple y empíricamente poderoso. Obtiene nuevos resultados de última generación en once tareas de procesamiento del lenguaje natural, incluido el aumento de la puntuación GLUE al 80,5 % (mejora absoluta del 7,7 %), la precisión de MultiNLI al 86,7 % (mejora absoluta del 4,6 %), SQuAD v1.1 Prueba de respuesta a preguntas F1 a 93,2 (mejora absoluta de 1,5 puntos) y Prueba SQuAD v2.0 F1 a 83,1 (mejora absoluta de 5,1 puntos).
Papel: https://arxiv.org/abs/1810.04805
En lo anterior podemos ver una palabra clave interesante, Bidireccional. La naturaleza bidireccional le da a BERT un poder similar al humano. Supongamos que tiene que completar un espacio en blanco como el siguiente,
“A veces la guerra puede ser un mal necesario. Pero no importa lo necesario que sea, siempre es un _____, nunca un bien”.
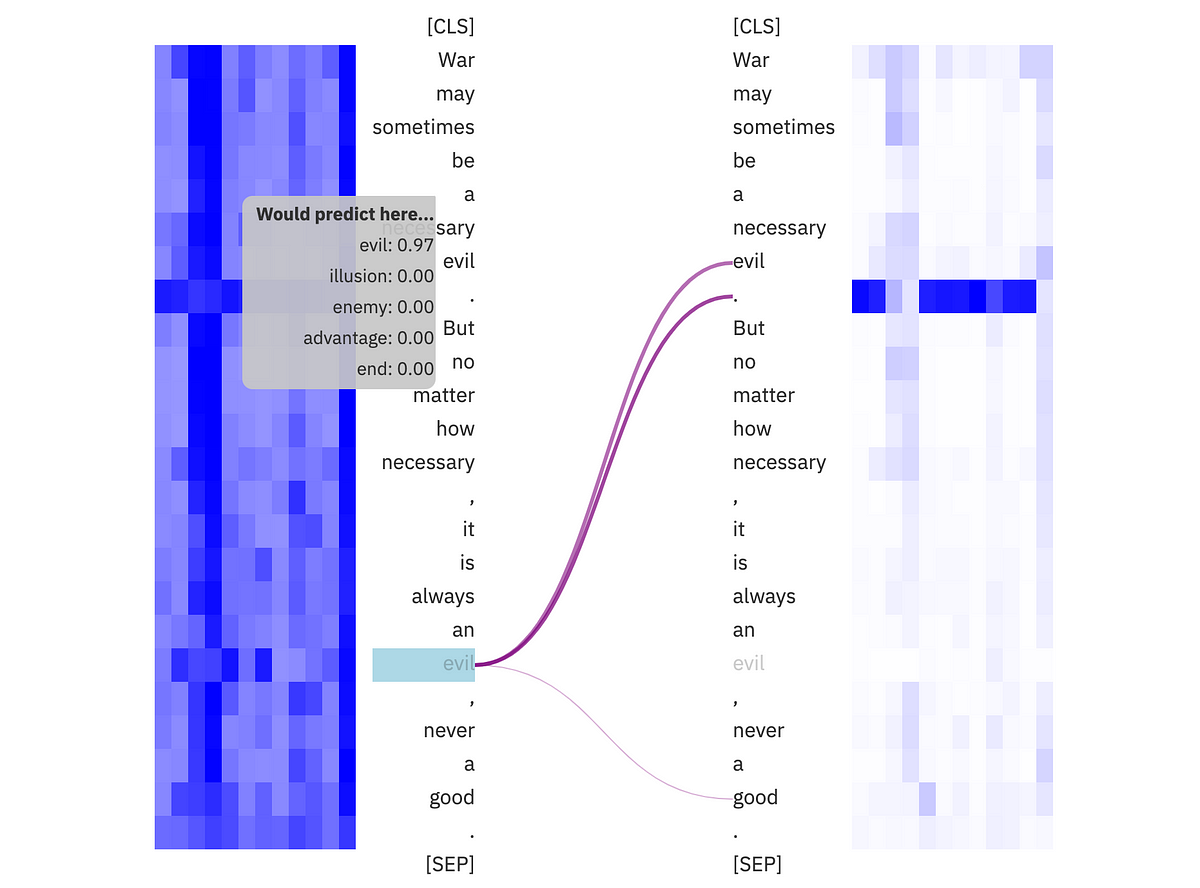
Para adivinar la palabra que está en una posición en blanco, debes tener en cuenta algunas cosas: las palabras antes del espacio en blanco, las palabras después del espacio en blanco y el contexto general de la oración. Adaptando esta naturaleza humana, BERT funciona de la misma manera. Durante el entrenamiento, ocultamos algunas palabras y le pedimos a BERT que intente predecirlas. Cuando finaliza el entrenamiento, BERT puede predecir tokens enmascarados en función de sus palabras antes y después. Para hacer esto, el modelo debe prestar diferente atención a las palabras presentadas en la secuencia de entrada, lo que puede afectar significativamente la predicción de tokens enmascarados.
Como puede ver aquí, el modelo ve una palabra adecuada para la posición oculta como demonio y la primera frase demonio según sea necesario para hacer esta predicción. Este es un punto notable e implica que el modelo comprende el contexto de la secuencia de entrada. Este conocimiento del contexto permite a BERT generar incrustaciones de oraciones significativas para tareas determinadas. Además, estas incorporaciones se pueden utilizar en tareas posteriores, como la agrupación y la clasificación. Ya basta de BERT; construyamos uno desde cero.
Generalmente tenemos BERT(base) y BERT(grande). Ambos tienen 64 dimensiones por cabeza. El grande La variante contiene 24 capas de codificador, mientras que la base La variante solo tiene 12. Sin embargo, no estamos limitados a estas configuraciones. Sorprendentemente, tenemos control total sobre la definición del modelo utilizando la biblioteca Hugging Face Transformers. Todo lo que tenemos que hacer es definir las configuraciones del modelo deseadas usando el BertConfig clase.
Elegí 6 cabezales y 384 dimensiones totales del modelo para cumplir con la implementación original. De esta forma, cada cabezal tiene 64 dimensiones similares a la implementación original. Inicialicemos nuestro modelo BERT.
from transformers import BertConfig, BertForMaskedLMconfig = BertConfig(
hidden_size = 384,
vocab_size= tokenizer.vocab_size,
num_hidden_layers = 6,
num_attention_heads = 6,
intermediate_size = 1024,
max_position_embeddings = 256
)
model = BertForMaskedLM(config=config)
print(model.num_parameters()) #10457864
Aquí, no describiré cómo funciona la tokenización internamente. En su lugar, entrenemos uno desde cero usando la biblioteca de tokenizadores Hugging Face. Tenga en cuenta que el tokenizador utilizado en la implementación BERT original es el tokenizador de WordPieza, otro método de tokenización basado en subpalabras. Puede obtener más información sobre esta tokenización utilizando el interesante recurso HuggingFace a continuación.
El conjunto de datos utilizado aquí es el conjunto de datos Sinhala-400M. (bajo apache-2.0). Puede seguir lo mismo con cualquier conjunto de datos que tenga.
Como habrás notado, algunas palabras en cingalés también se han escrito en inglés. Entrenemos un tokenizador para estos corpus.
Primero importemos los módulos necesarios. Lo bueno de entrenar tokenizadores usando la biblioteca Hugging Face Tokenizers es que podemos usar tokenizadores existentes y reemplazar solo el vocabulario (y fusionarlo cuando corresponda) según nuestro corpus de entrenamiento. Esto significa que se conservarán los pasos de tokenización, como la pretokenización y la postokenización. Para esto, podemos usar un método, tren_nuevo_desde_iterador Clase BertTokenizer.
from tokenizers.implementations import ByteLevelBPETokenizer
from tokenizers.processors import BertProcessing
from transformers import AutoTokenizer
from datasets import Dataset
import pandas as pd#load base tokenizer to train on dataset
tokenizer_base = AutoTokenizer.from_pretrained("bert-base-cased")
# convert pandas dataset to HF dataset
dataset = Dataset.from_pandas(df.rename(columns={"comment":'text'}))
# define iterator
training_corpus = (
dataset[i : i + 1000]["text"]
for i in range(0, len(dataset), 1000)
)
#train the new tokenizer for dataset
tokenizer = tokenizer_base.train_new_from_iterator(training_corpus, 5000)
#test trained tokenizer for sample text
text = dataset['text'][123]
print(text)
# let's check tokenization process
input_ids = tokenizer(text).input_ids
subword_view = [tokenizer.convert_ids_to_tokens(id) for id in input_ids]
np.array(subword_view)
Puedes ver palabras como “jugador de críquet” descompuestas en Grillo y ##er, indicando que el tokenizador ha sido entrenado adecuadamente. Sin embargo, pruebe con diferentes tamaños de vocabulario; el mío es 5000, que es relativamente pequeño pero adecuado para este ejemplo de juguete.
Finalmente, podemos guardar el tokenizador entrenado en nuestro directorio.
tokenizer.save_pretrained("tokenizer/sinhala-wordpiece-yt-comments")
Definamos un clasificador para tareas de MLM. Aquí enmascararemos el 15% de los tokens. De todos modos, podemos establecer diferentes probabilidades de enmascaramiento.
from transformers import DataCollatorForLanguageModelingdata_collator = DataCollatorForLanguageModeling(
tokenizer=tokenizer, mlm=True, mlm_probability=0.15
)
Tokenicemos el conjunto de datos utilizando un tokenizador creado previamente. estoy reemplazando el original LineByLineTextConjunto de datos usando mi clase personalizada utilizando la aceleración Hugging Face.
import torch
from torch.utils.data import Dataset
from accelerate import Accelerator, DistributedTypeclass LineByLineTextDataset(Dataset):
def __init__(self, tokenizer, raw_datasets, max_length: int):
self.padding = "max_length"
self.text_column_name = 'text'
self.max_length = max_length
self.accelerator = Accelerator(gradient_accumulation_steps=1)
self.tokenizer = tokenizer
with self.accelerator.main_process_first():
self.tokenized_datasets = raw_datasets.map(
self.tokenize_function,
batched=True,
num_proc=4,
remove_columns=[self.text_column_name],
desc="Running tokenizer on dataset line_by_line",
)
self.tokenized_datasets.set_format('torch',columns=['input_ids'],dtype=torch.long)
def tokenize_function(self,examples):
examples[self.text_column_name] = [
line for line in examples[self.text_column_name] if len(line[0]) > 0 and not line[0].isspace()
]
return self.tokenizer(
examples[self.text_column_name],
padding=self.padding,
truncation=True,
max_length=self.max_length,
return_special_tokens_mask=True,
)
def __len__(self):
return len(self.tokenized_datasets)
def __getitem__(self, i):
return self.tokenized_datasets[i]
Tokenicemos el conjunto de datos.
tokenized_dataset_train = LineByLineTextDataset(
tokenizer= tokenizer,
raw_datasets = dataset,
max_length=256,
)
Muy bien, codifiquemos nuestro ciclo de entrenamiento.
from transformers import Trainer, TrainingArgumentstraining_args = TrainingArguments(
output_dir="./model",
overwrite_output_dir=True,
push_to_hub=True,
hub_model_id="Ransaka/sinhala-bert-yt-comments",
num_train_epochs=2,
per_device_train_batch_size=32,
save_steps=5_000,
logging_steps = 1000,
save_total_limit=2,
use_mps_device = True, # disable this if you're running non-mac env
hub_private_repo = False, # please set true if you want to save model privetly
save_safetensors= True,
learning_rate = 1e-4,
report_to='wandb'
)
trainer = Trainer(
model=model,
args=training_args,
data_collator=data_collator,
train_dataset=tokenized_dataset_train
)trainer.train()
Podemos invocar al entrenador usando su tren() método.
trainer.train()
Después de una capacitación suficiente, nuestro modelo se puede utilizar para tareas posteriores, como la clasificación y la agrupación en clústeres. Puede encontrar el ejemplo utilizando este espacio Abrazando la cara para obtener más detalles.
Con recursos limitados, es posible que los modelos previamente entrenados solo reconozcan patrones lingüísticos específicos, pero aún así pueden ser útiles para casos de uso particulares. Se recomienda encarecidamente realizar ajustes cuando sea posible.
En este artículo, todas las imágenes, a menos que se indique lo contrario, son del autor.
- Un BERT explorable – https://huggingface.co/spaces/exbert-project/exbert
- Papel BERT – https://arxiv.org/abs/1810.04805
- Conjunto de datos — https://huggingface.co/datasets/Ransaka/Sinhala-400M