
Los modelos de lenguajes grandes (LLM), como ChatGPT y Llama, han atraído una atención sustancial debido a sus excepcionales capacidades de procesamiento del lenguaje natural, lo que permite diversas aplicaciones que van desde la generación de texto hasta la finalización de código. A pesar de su inmensa utilidad, los altos costos operativos de estos modelos han planteado un desafío importante, lo que ha llevado a los investigadores a buscar soluciones innovadoras para mejorar su eficiencia y escalabilidad.
Dado que la generación de una única respuesta incurre en un costo promedio de $0,01, los gastos asociados con la ampliación de estos modelos para atender a miles de millones de usuarios, cada uno con múltiples interacciones diarias, pueden volverse sustanciales rápidamente. Estos costos pueden aumentar exponencialmente, particularmente en tareas complejas como el autocompletado de código, donde el modelo participa continuamente durante el proceso de codificación. Al reconocer la urgente necesidad de optimizar el proceso de decodificación, los investigadores han explorado técnicas para agilizar y acelerar la operación de atención, un componente crucial en la generación de texto coherente y contextualmente relevante.
La inferencia LLM, a menudo llamada decodificación, implica la generación de tokens paso a paso, siendo la operación de atención un factor importante para determinar el tiempo total de generación. Si bien avances como FlashAttention v2 y FasterTransformer han mejorado el proceso de capacitación al optimizar el ancho de banda de la memoria y los recursos computacionales, los desafíos durante la fase de inferencia persisten. Una de las principales limitaciones encontradas durante la decodificación se refiere a la escalabilidad de la operación de atención con contextos más largos. A medida que los LLM tienen cada vez más la tarea de manejar documentos, conversaciones y bases de código más extensos, la operación de atención puede consumir una cantidad sustancial de tiempo de inferencia, lo que impide la eficiencia general del modelo.
Los investigadores introdujeron una técnica innovadora llamada Flash-Decoding para abordar estos desafíos, basándose en la base establecida por metodologías anteriores. La innovación clave de Flash-Decoding radica en su novedoso enfoque de paralelización, que se centra en la longitud de la secuencia de claves y valores. Al dividir estratégicamente claves y valores en fragmentos más pequeños, el enfoque permite una utilización altamente eficiente de la GPU, incluso con tamaños de lote más pequeños y contextos extendidos. Flash-Decoding reduce significativamente los requisitos de memoria de la GPU al aprovechar los cálculos de atención en paralelo y la función log-sum-exp, lo que facilita un cálculo optimizado y eficiente en toda la arquitectura del modelo.
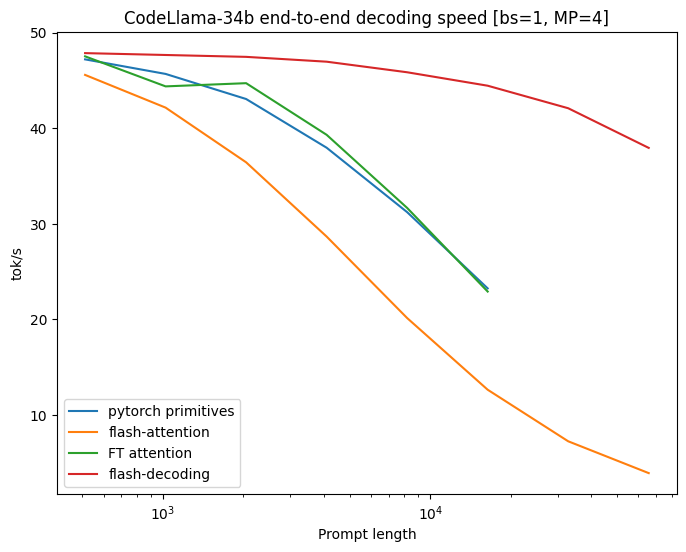
Para evaluar la efectividad de Flash-Decoding, se realizaron pruebas comparativas integrales en el modelo CodeLLaMa-34b de última generación, reconocido por su arquitectura robusta y capacidades avanzadas. Los resultados mostraron una impresionante mejora de 8 veces en las velocidades de decodificación para secuencias más largas en comparación con los enfoques existentes. Además, los micropuntos de referencia realizados en la atención de múltiples cabezales escalada para varias longitudes de secuencia y tamaños de lote validaron aún más la eficacia de Flash-Decoding, demostrando su rendimiento constante incluso cuando la longitud de la secuencia se amplió hasta 64k. Este rendimiento excepcional ha desempeñado un papel fundamental en la mejora significativa de la eficiencia y la escalabilidad de los LLM, lo que marca un avance sustancial en las tecnologías de inferencia de modelos de lenguajes grandes.
En resumen, Flash-Decoding ha surgido como una solución transformadora para abordar los desafíos asociados con la operación de atención durante el proceso de decodificación de modelos de lenguaje grandes. Al optimizar la utilización de la GPU y mejorar el rendimiento general del modelo, Flash-Decoding tiene el potencial de reducir sustancialmente los costos operativos y promover una mayor accesibilidad de estos modelos en diversas aplicaciones. Esta técnica pionera representa un hito importante en la inferencia de modelos de lenguaje grande, allanando el camino para una mayor eficiencia y avances acelerados en las tecnologías de procesamiento del lenguaje natural.
Revisar la Página de referencia y Página del proyecto. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 31k+ ML, Comunidad de Facebook de más de 40.000 personas, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
También estamos en WhatsApp. Únase a nuestro canal de IA en Whatsapp.

Madhur Garg es pasante de consultoría en MarktechPost. Actualmente está cursando su Licenciatura en Ingeniería Civil y Ambiental en el Instituto Indio de Tecnología (IIT), Patna. Comparte una gran pasión por el aprendizaje automático y disfruta explorando los últimos avances en tecnologías y sus aplicaciones prácticas. Con un gran interés en la inteligencia artificial y sus diversas aplicaciones, Madhur está decidido a contribuir al campo de la ciencia de datos y aprovechar su impacto potencial en diversas industrias.