
Con el crecimiento de grandes modelos de lenguaje, el procesamiento del lenguaje natural se ha revolucionado. El año pasado surgieron muchos LLM, como GPT-3.5, LLaMA y Mixtral, que ayudaron a abordar diversas tareas lingüísticas. Aunque actualmente existen muchos LLM de este tipo, los modelos de código abierto no tienen modelos confiables para las tareas de traducción. Se han realizado investigaciones exhaustivas para abordar este desafío.
En consecuencia, una colaboración entre los investigadores de Unbabel, el Laboratorio SARDINE del Instituto Superior Técnico y los investigadores del laboratorio MICS de CentraleSupélec de la Universidad de Paris-Saclay, ha creado un nuevo modelo de Torre multilingüe. Este LLM multilingüe basado en Llama 2 tiene parámetros 7B diseñados específicamente para tareas relacionadas con la traducción. Lo más destacado de este modelo es que, a diferencia de otros modelos de código abierto, que se construyen predominantemente con datos en inglés, Tower admite 10 idiomas. Estos idiomas son inglés, alemán, francés, español, chino, portugués, italiano, ruso, coreano y holandés.
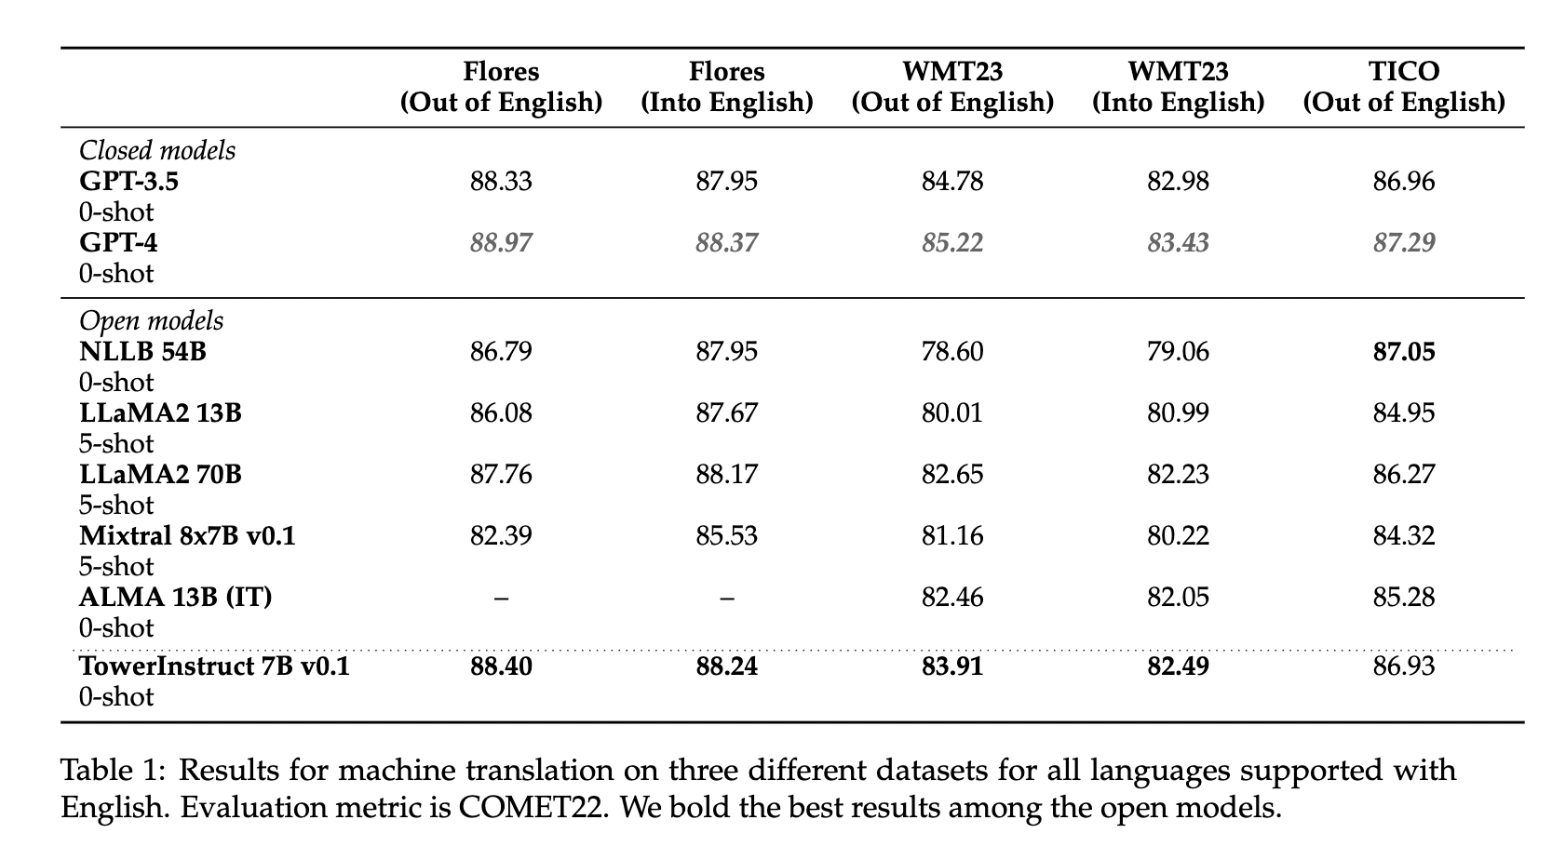
Además de la traducción multilingüe, también tiene capacidades para actividades previas a la traducción, como mejora gramatical, y trabajos de evaluación de traducción, como traducción automática y posedición automática. Los investigadores de esta colaboración descubrieron que este modelo funcionó mejor que sus homólogos de última generación en traducción y mejor que las soluciones alternativas de código abierto, incluidas ALMA 13B y LLaMA-2 70B.
Los investigadores utilizaron dos etapas para formular Tower: preentrenamiento extendido y ajuste de instrucciones. Los investigadores enfatizaron que utilizaron un entrenamiento previo continuo, ya que mejora el dominio de LLaMA2 en idiomas distintos del inglés, mientras que el ajuste de la instrucción mejora su desempeño al abordar problemas particulares sin experiencia previa. Para realizar una capacitación previa continua, utilizaron un conjunto de datos de 20 mil millones de tokens distribuidos uniformemente entre diferentes idiomas. Obtuvieron dos tercios de los tokens de datos monolingües y un tercio de los datos de conjuntos de datos bilingües de acceso público, como OPUS.
El segundo paso del ajuste de instrucciones mejoró la capacidad del modelo para manejar tareas específicas en un nivel superior en forma de 0 disparos. Desarrollaron un conjunto de datos llamado TowerBlocks para un ajuste supervisado. El conjunto de datos comprende instrucciones de código y datos conversacionales y tiene registros de tareas específicas. Este conjunto de datos ayudó al modelo a mantener la competencia en diversas tareas relacionadas con la traducción al proporcionar indicaciones para todas las tareas, incluidas las plantillas de cero y pocas tomas.
En conclusión, TowerInstruct puede suponer un paso importante en la traducción automática multilingüe, ya que supera a los modelos GPT-3.5 y Mixtral 8x7B. Sus funciones, incluida la posedición automática, el reconocimiento de entidades nombradas o la corrección de errores de fuente, pueden resultar muy útiles en este ámbito. A medida que los investigadores se centran en mejorar la eficiencia del modelo, este puede ser un paso revolucionario en la traducción multilingüe. Los investigadores de esta colaboración también esperan con ansias el lanzamiento de TowerEval, un repositorio de evaluación centrado en la traducción automática y tareas relacionadas. Esto ayudará a los usuarios a reproducir puntos de referencia y evaluar el rendimiento de sus modelos de lenguaje frente a los estándares de Tower.
Revisar la Modelo y Blog de referencia. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Unirse nuestro SubReddit de 36k+ ML, 41k+ comunidad de Facebook, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Canal de telegramas
Rachit Ranjan es pasante de consultoría en MarktechPost. Actualmente está cursando su B.Tech en el Instituto Indio de Tecnología (IIT) de Patna. Está dando forma activamente a su carrera en el campo de la inteligencia artificial y la ciencia de datos y le apasiona y se dedica a explorar estos campos.