
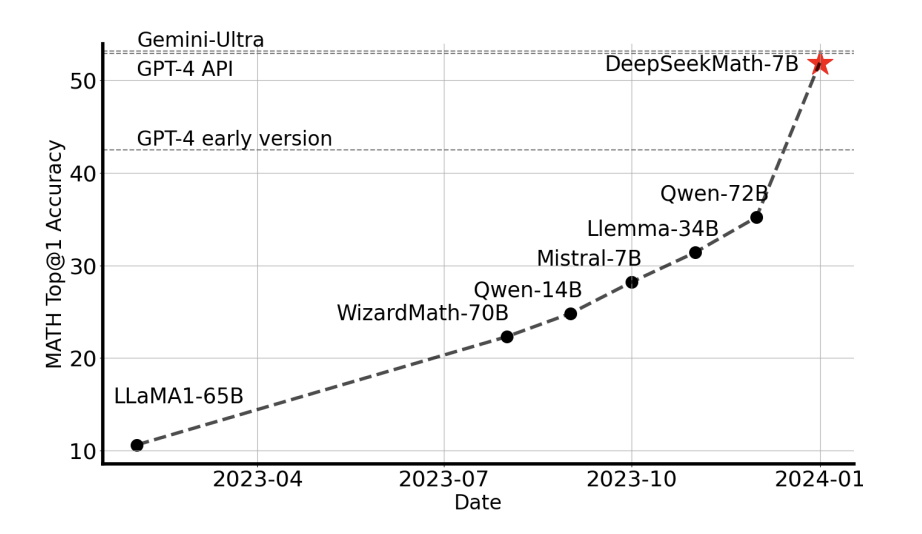
El razonamiento matemático en inteligencia artificial representa una frontera que ha desafiado durante mucho tiempo a investigadores y desarrolladores. Si bien son eficaces para tareas específicas, los métodos computacionales tradicionales a menudo necesitan ponerse al día cuando se enfrentan a las complejidades y matices de problemas matemáticos complejos. Esta limitación ha estimulado la búsqueda de soluciones más sofisticadas, lo que ha llevado a explorar modelos de lenguajes grandes (LLM) como vehículos potenciales para el razonamiento matemático avanzado. El desarrollo de estos modelos marca un cambio fundamental hacia el aprovechamiento de las vastas capacidades de la IA para descifrar, interpretar y resolver desafíos matemáticos.
A la vanguardia de esta innovación se encuentran DeepSeek-AI, la Universidad de Tsinghua y DeepSeekMath de la Universidad de Pekín, un modelo de lenguaje innovador diseñado específicamente para navegar por las complejidades del razonamiento matemático. A diferencia de los modelos convencionales que se basan en un alcance limitado de algoritmos y conjuntos de datos predefinidos, DeepSeekMath se beneficia de una experiencia de capacitación rica y diversa. La génesis de este modelo radica en la compilación estratégica de un vasto conjunto de datos que comprende más de 120 mil millones de tokens de contenido relacionado con las matemáticas de los amplios ámbitos de Internet. Este enfoque amplía la exposición del modelo a una amplia gama de conceptos matemáticos y enriquece su comprensión, permitiéndole abordar diversos problemas matemáticos con una precisión sin precedentes.
Lo que distingue a DeepSeekMath es su innovadora metodología de capacitación, particularmente utilizando la optimización de políticas relativas al grupo (GRPO). Esta variante del aprendizaje por refuerzo representa un importante avance, ya que optimiza las capacidades de resolución de problemas del modelo y, al mismo tiempo, gestiona de manera eficiente el uso de la memoria. La eficacia de GRPO es evidente en la capacidad de DeepSeekMath para formular soluciones paso a paso a problemas matemáticos complejos. Esta hazaña refleja los procesos humanos de resolución de problemas y supera las capacidades de los modelos anteriores.

El rendimiento y los resultados del modelo DeepSeekMath demuestran un razonamiento matemático superior en una variedad de puntos de referencia y muestran mejoras significativas con respecto a los modelos de código abierto existentes. Los aspectos más destacados incluyen:
- Lograr una precisión superior del 51,7 % en el competitivo punto de referencia MATH es un testimonio de sus capacidades de razonamiento avanzadas.
- Superó el rendimiento de modelos muchas veces su tamaño, lo que ilustra que la calidad de los datos y la eficiencia de los algoritmos de aprendizaje pueden superar la pura potencia computacional.
- La aplicación exitosa de GRPO ha demostrado mejorar notablemente el rendimiento, estableciendo un nuevo estándar para la integración del aprendizaje por refuerzo en el entrenamiento de modelos de lenguaje para el razonamiento matemático.
Esta investigación no sólo subraya el potencial de la IA para revolucionar el razonamiento matemático, sino que también abre nuevas vías de exploración. El éxito de DeepSeekMath allana el camino para mayores avances en las matemáticas impulsadas por la IA, ofreciendo perspectivas prometedoras para herramientas educativas, asistencia en investigación y más. La convergencia de la IA y las matemáticas a través de iniciativas como DeepSeekMath presagia un futuro en el que los límites de lo que las máquinas pueden entender y resolver seguirán ampliándose, cerrando las brechas entre la inteligencia computacional y la compleja belleza de las matemáticas.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y noticias de Google. Unirse nuestro SubReddit de 36k+ ML, 41k+ comunidad de Facebook, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Canal de telegramas

Hola, mi nombre es Adnan Hassan. Soy pasante de consultoría en Marktechpost y pronto seré aprendiz de gestión en American Express. Actualmente estoy cursando una doble titulación en el Instituto Indio de Tecnología, Kharagpur. Me apasiona la tecnología y quiero crear nuevos productos que marquen la diferencia.