
Con la llegada de la inteligencia artificial generativa (IA), los modelos básicos (FM) pueden generar contenido como responder preguntas, resumir texto y proporcionar aspectos destacados del documento fuente. Sin embargo, para la selección de modelos, existe una amplia variedad de proveedores de modelos, como Amazon, Anthropic, AI21 Labs, Cohere y Meta, junto con formatos de datos discretos del mundo real en PDF, Word, texto, CSV, imagen, audio o video.
Roca Amazónica es un servicio completamente administrado que facilita la creación y el escalado de aplicaciones de IA generativas. Amazon Bedrock ofrece una selección de FM de alto rendimiento de empresas de IA líderes, incluidas AI21 Labs, Anthropic, Cohere, Meta, Stability AI y Amazon, a través de una única API. Le permite personalizar de forma privada los FM con sus datos mediante técnicas como el ajuste fino, la ingeniería rápida y la generación aumentada de recuperación (RAG), y crear agentes que ejecuten tareas utilizando sus sistemas empresariales y fuentes de datos, al tiempo que cumplen con los requisitos de seguridad y privacidad.
En esta publicación, le mostramos una solución para crear un chatbot conversacional de interfaz única que permite a los usuarios finales elegir entre diferentes modelos de lenguaje grandes (LLM) y parámetros de inferencia para diversos formatos de datos de entrada. La solución utiliza Amazon Bedrock para crear opciones y flexibilidad para mejorar la experiencia del usuario y comparar los resultados del modelo de diferentes opciones.
Toda la base del código está disponible en GitHubjunto con un Formación en la nube de AWS plantilla.
¿Qué es el trapo?
Recuperación de Generación Aumentada (RAG) puede mejorar el proceso de generación utilizando los beneficios de la recuperación, permitiendo que un modelo de generación de lenguaje natural produzca respuestas más informadas y contextualmente apropiadas. Al incorporar información relevante de la recuperación en el proceso de generación, RAG tiene como objetivo mejorar la precisión, coherencia e informatividad del contenido generado.
Para implementar un sistema RAG eficaz se requieren varios componentes clave que trabajen en armonía:
- Modelos de fundación – La base de una arquitectura RAG es un modelo de lenguaje previamente entrenado que maneja la generación de texto. Amazon Bedrock abarca modelos de empresas líderes en inteligencia artificial como AI21 Labs, Anthropic, Cohere, Meta, Mistral AI y Amazon que poseen una sólida comprensión del lenguaje y capacidades de síntesis para entablar un diálogo conversacional.
- Tienda de vectores – En el centro de la funcionalidad de recuperación se encuentra una base de datos de almacenamiento de vectores que conserva las incrustaciones de documentos para la búsqueda de similitudes. Esto permite una rápida identificación de información contextual relevante. AWS ofrece muchos servicios para sus requisitos de bases de datos vectoriales:
- Perdiguero – El módulo de recuperación utiliza el almacén de vectores para encontrar de manera eficiente documentos y pasajes pertinentes para aumentar las indicaciones.
- Incrustador – Para llenar el almacén de vectores, un modelo de incrustación codifica los documentos fuente en representaciones vectoriales consumibles por el recuperador. Modelos como Amazon Titan Embeddings G1 – Text v1.2 son ideales para esta abstracción de texto a vector.
- Ingestión de documentos – Canalizaciones sólidas que incorporan, preprocesan y tokenizan documentos fuente, dividiéndolos en pasajes manejables para su integración y búsqueda eficiente. Para esta solución utilizamos el Marco LangChain para el preprocesamiento de documentos. Al orquestar estos componentes centrales utilizando LangChain, los sistemas RAG permiten que los modelos de lenguaje accedan a un vasto conocimiento para una generación basada en tierra.
Hemos gestionado completamente el soporte para nuestro flujo de trabajo RAG de extremo a extremo utilizando Bases de conocimiento para Amazon Bedrock. Con Knowledge Bases para Amazon Bedrock, puede brindar a los FM y agentes información contextual de las fuentes de datos privadas de su empresa para que RAG brinde respuestas más relevantes, precisas y personalizadas.
Para equipar a los FM con información actualizada y patentada, las organizaciones utilizan RAG para obtener datos de las fuentes de datos de la empresa y enriquecer el mensaje para proporcionar respuestas más relevantes y precisas. Knowledge Bases for Amazon Bedrock es una capacidad totalmente administrada que le ayuda a implementar todo el flujo de trabajo de RAG, desde la ingesta hasta la recuperación y el aumento rápido, sin tener que crear integraciones personalizadas con fuentes de datos ni administrar flujos de datos. La gestión del contexto de la sesión está integrada, por lo que su aplicación puede admitir fácilmente conversaciones de varios turnos.
Descripción general de la solución
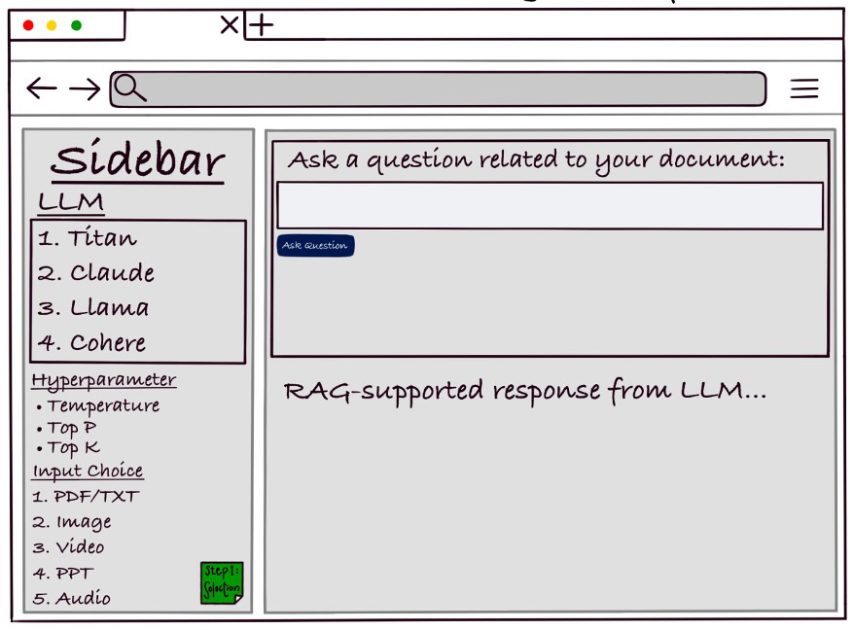
Este chatbot está construido con RAG, lo que le permite proporcionar capacidades de conversación versátiles. La siguiente figura ilustra una interfaz de usuario de muestra de la interfaz de preguntas y respuestas utilizando Streamlit y el flujo de trabajo.
Esta publicación proporciona una interfaz de usuario única con múltiples opciones para las siguientes capacidades:
- Principales FM disponibles a través de Amazon Bedrock
- Parámetros de inferencia para cada uno de estos modelos
- Formatos de entrada de datos de origen para RAG:
- Texto (PDF, CSV, Word)
- Enlace de página web
- Video de Youtube
- Audio
- Imagen escaneada
- PowerPoint
- Operación RAG utilizando el LLM, el parámetro de inferencia y las fuentes:
- Preguntas y respuestas
- Resumen: resumir, obtener aspectos destacados, extraer texto
Hemos utilizado uno de los muchos cargadores de documentos de LangChain, Cargador de YouTube. El from_you_tube_url La función ayuda a extraer transcripciones y metadatos del vídeo de YouTube.
Los documentos contienen dos atributos:
page_contentcon las transcripcionesmetadataCon información básica sobre el vídeo.
El texto se extrae de la transcripción y, utilizando Langchain TextLoader, el documento se divide y fragmenta, y se crean incrustaciones, que luego se almacenan en el almacén de vectores.
El siguiente diagrama ilustra la arquitectura de la solución.

Prerrequisitos
Para implementar esta solución, debe tener los siguientes requisitos previos:
- Un cuenta de AWS con los permisos necesarios para iniciar la pila mediante AWS CloudFormation.
- Nube informática elástica de Amazon (Amazon EC2) que aloja la aplicación debe tener acceso a Internet para descargar todos los parches necesarios del sistema operativo y las bibliotecas relacionadas con la aplicación (python).
- Una comprensión básica de Amazon Bedrock y FM.
- Esta solución utiliza el Incrustación de texto de Amazon Titan modelo. Asegúrese de que este modelo esté habilitado para su uso en Amazon Bedrock. En la consola de Amazon Bedrock, elija Acceso al modelo en el panel de navegación.
- Si Amazon Titan Text Embeddings está habilitado, el estado de acceso indicará Acceso concedido.
- Si el modelo no está disponible, habilite el acceso al modelo eligiendo Administrar el acceso al modeloseleccionando Incrustaciones multimodales Titan G1y eligiendo Solicitar acceso al modelo. El modelo está habilitado para su uso inmediatamente.
Implementar la solución
La plantilla de CloudFormation implementa una Nube informática elástica de Amazon (Amazon EC2) para alojar la aplicación Streamlit, junto con otros recursos asociados como un Gestión de acceso e identidad de AWS (IAM) rol y Servicio de almacenamiento simple de Amazon (Amazon S3) cubo. Para obtener más información sobre Amazon Bedrock e IAM, consulte Cómo funciona Amazon Bedrock con IAM.
En esta publicación, implementamos la aplicación Streamlit en una instancia EC2 dentro de una VPC, pero usted puede implementarla como una aplicación en contenedores utilizando una solución sin servidor con AWS FargateDiscutiremos esto con más detalle en la Parte 2.
Complete los siguientes pasos para implementar los recursos de la solución mediante AWS CloudFormation:
- Descargue la plantilla de CloudFormation StreamlitAppServer_Cfn.yml desde el repositorio de GitHub.
- En AWS CloudFormation, cree una nueva pila.
- Para preparar plantillaseleccionar La plantilla está lista.
- En el Especificar plantilla sección, proporcione la siguiente información:
- Para Fuente de la plantillaseleccionar Cargar un archivo de plantilla.
- Elegir archivo y sube la plantilla que descargaste.
- Elegir Próximo.
- Para el nombre de la pilaingresa un nombre (para esta publicación,
StreamlitAppServer). - En el Parámetros sección, proporcione la siguiente información:
- Para Especifique el ID de VPC donde desea implementar su servidor de aplicaciones, ingrese el ID de VPC donde desea implementar este servidor de aplicaciones.
- Para VPCCidringrese el CIDR de la VPC que está utilizando.
- Para ID de subredingrese el ID de subred de la misma VPC.
- Para MYIPCidringrese la dirección IP de su computadora o estación de trabajo para que pueda abrir la aplicación Streamlit en su navegador local.
Puedes ejecutar el comando curl https://api.ipify.org en su terminal local para obtener su dirección IP.
- Deje el resto de los parámetros como predeterminados.
- Elegir Próximo.
- En el Capacidades sección, seleccione la casilla de verificación de reconocimiento.
- Elegir Entregar.
Espere hasta que vea que el estado de la pila se muestra como CREATE_COMPLETE.
- Elige la pila Recursos para ver los recursos que lanzó como parte de la implementación de la pila.
- Elija el enlace para que S3Bucket sea redirigido a la consola de Amazon S3.
- Anote el nombre del depósito S3 para actualizar el script de implementación más tarde.
- Elegir Crear carpeta para crear una nueva carpeta.
- Para Nombre de la carpetaingresa un nombre (para esta publicación,
gen-ai-qa).
Asegúrese de seguir las mejores prácticas de seguridad de AWS para proteger los datos en Amazon S3. Para más detalles, ver Las 10 mejores prácticas de seguridad para proteger los datos en Amazon S3.
- Regresar a la pila Recursos y elija el enlace a StreamlitAppServer para ser redirigido a la consola de Amazon EC2.
- Seleccionar
StreamlitApp_Severy elige Conectar.
- Seleccionar
Esto abrirá una nueva página con varias formas de conectarse a la instancia EC2 iniciada.
- Para esta solución, seleccione Conectar usando Conexión de instancia EC2entonces escoge Conectar.
Esto abrirá una sesión de Amazon EC2 en su navegador.
- Ejecute el siguiente comando para monitorear el progreso de todas las bibliotecas relacionadas con Python que se instalan como parte de los datos del usuario:
- Cuando veas el mensaje
Finished running user data...puedes salir de la sesión pulsando Ctrl+C.
Esto tarda unos 15 minutos en completarse.
- Ejecute los siguientes comandos para iniciar la aplicación:
- Tome nota del valor de la URL externa.
- Si por casualidad sales de la sesión (o se detiene la aplicación), puedes reiniciar la aplicación ejecutando el mismo comando resaltado en el Paso n.° 18
Usa el chatbot
Utilice la URL externa que copió en el paso anterior para acceder a la aplicación.
Puede cargar su archivo para comenzar a usar el chatbot para preguntas y respuestas.
Limpiar
Para evitar incurrir en cargos futuros, elimine los recursos que creó:
- Vaciar el contenido del depósito S3 que creaste como parte de esta publicación.
- Eliminar la pila de CloudFormation que creaste como parte de esta publicación.
Conclusión
En esta publicación, le mostramos cómo crear un chatbot de preguntas y respuestas que pueda responder preguntas en todo el corpus de documentos de una empresa con opciones de FM disponibles en Amazon Bedrock, dentro de una única interfaz.
En la Parte 2, le mostramos cómo usar bases de conocimiento para Amazon Bedrock con bases de datos vectoriales de nivel empresarial como OpenSearch Service, Amazon Aurora PostgreSQL, MongoDB Atlas, Weaviate y Pinecone con su chatbot de preguntas y respuestas.
Sobre los autores
Anand Mandilwar es arquitecto de soluciones empresariales en AWS. Trabaja con clientes empresariales ayudándolos a innovar y transformar sus negocios en AWS. Le apasiona la automatización en torno a las operaciones en la nube, el aprovisionamiento de infraestructura y la optimización de la nube. También le gusta la programación en Python. En su tiempo libre, disfruta perfeccionando sus habilidades fotográficas, especialmente en el área de retratos y paisajes.
NagaBharathi Challa es arquitecta de soluciones en el equipo civil federal de EE. UU. en Amazon Web Services (AWS). Trabaja en estrecha colaboración con los clientes para utilizar eficazmente los servicios de AWS para sus casos de uso de misión, proporcionando las mejores prácticas arquitectónicas y orientación sobre una amplia gama de servicios. Fuera del trabajo, disfruta de pasar tiempo con la familia y difundir el poder de la meditación.