
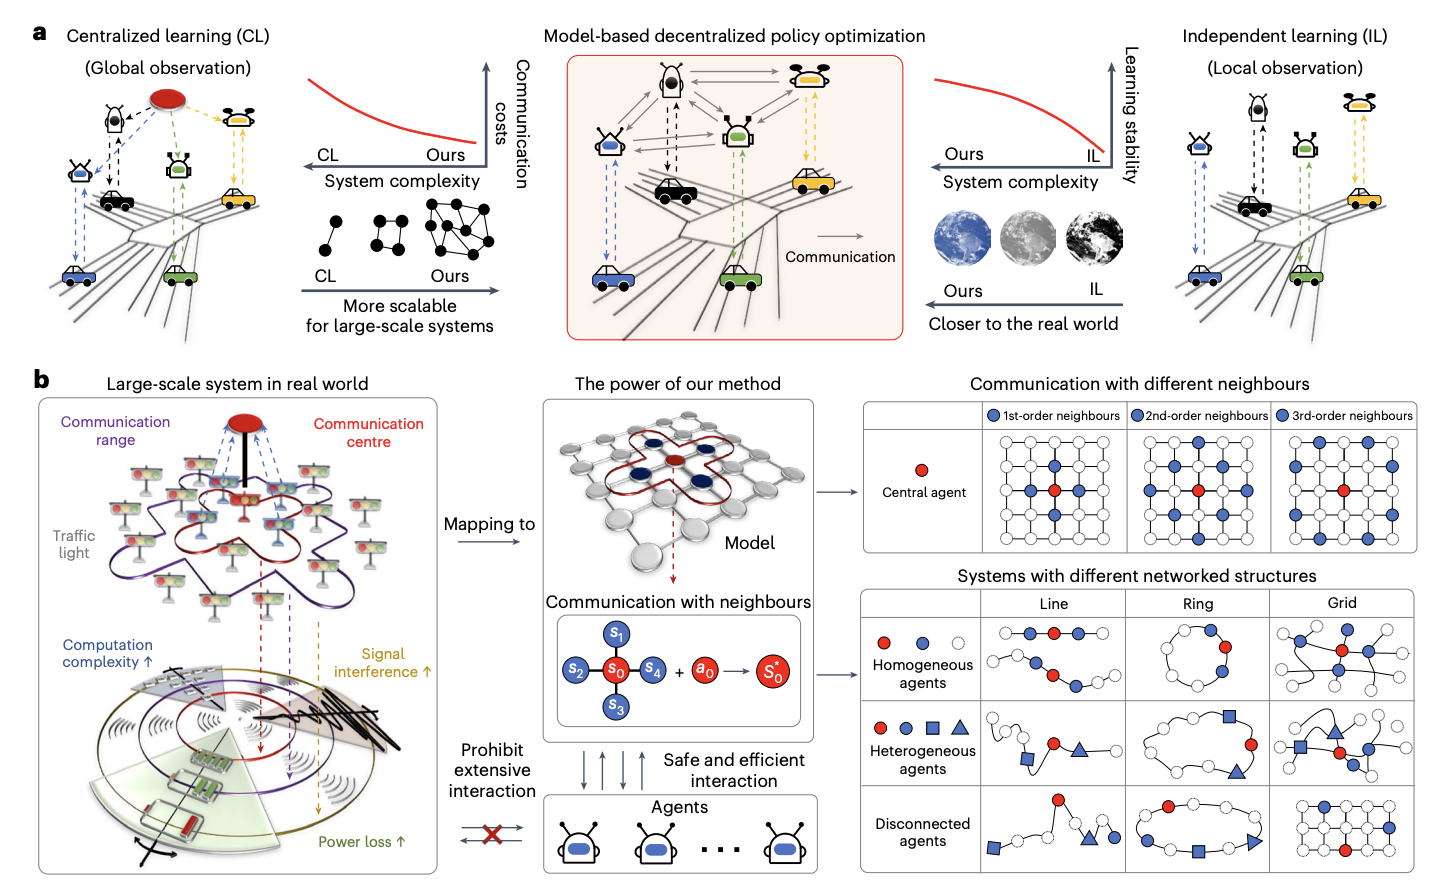
El principal desafío en la ampliación de los sistemas de IA a gran escala es lograr una toma de decisiones eficiente manteniendo el rendimiento. La IA distribuida, en particular el aprendizaje por refuerzo multiagente (MARL), ofrece potencial al descomponer tareas complejas y distribuirlas entre nodos colaborativos. Sin embargo, las aplicaciones del mundo real enfrentan limitaciones debido a los altos requisitos de comunicación y datos. Los métodos tradicionales, como el control predictivo de modelos (MPC), requieren una dinámica de sistema precisa y, a menudo, simplifican en exceso las complejidades no lineales. Si bien MARL es prometedor en áreas como la conducción autónoma y los sistemas de energía, aún tiene dificultades para lograr un intercambio de información eficiente y escalabilidad en entornos complejos del mundo real debido a las limitaciones de comunicación y a suposiciones poco prácticas.
Los investigadores de la Universidad de Pekín y del King’s College de Londres desarrollaron un marco de optimización de políticas descentralizadas para sistemas multiagente. Al aprovechar las observaciones locales mediante el desacoplamiento topológico de la dinámica global, permiten realizar estimaciones precisas de la información internacional. Su enfoque integra el aprendizaje de modelos para mejorar la optimización de políticas con datos limitados. A diferencia de los métodos anteriores, este marco mejora la escalabilidad al reducir la comunicación y la complejidad del sistema. Los resultados empíricos en diversos escenarios, incluidos los sistemas de transporte y energía, demuestran su eficacia en el manejo de sistemas a gran escala con cientos de agentes. Ofrece un rendimiento superior en aplicaciones del mundo real con comunicación limitada y agentes heterogéneos.
En el marco de optimización de políticas basado en modelos descentralizados, cada agente mantiene modelos localizados que predicen estados y recompensas futuras al observar sus acciones y los estados de sus vecinos. Las políticas se optimizan utilizando dos reservas de experiencia: una para datos del entorno real y otra para datos generados por modelos. Se utiliza una técnica de implementación ramificada para evitar errores de acumulación al iniciar implementaciones de modelos a partir de estados aleatorios dentro de trayectorias recientes para mejorar la precisión. Las actualizaciones de políticas incorporan funciones de valor localizadas y aprovechan los agentes PPO, lo que garantiza la mejora de las políticas al minimizar gradualmente los sesgos de aproximación y dependencia durante el entrenamiento.
Los métodos describen un proceso de decisión de Markov (MDP) en red con múltiples agentes representados como nodos en un gráfico. Cada agente se comunica con sus vecinos para optimizar una política de aprendizaje de refuerzo descentralizada para mejorar las recompensas locales y el rendimiento del sistema global. Se analizan dos tipos de sistemas: sistemas en red independientes (INS), donde las interacciones de los agentes son mínimas y sistemas dependientes de ξ, que tienen en cuenta la disminución de la influencia con la distancia. Un enfoque de aprendizaje basado en modelos se aproxima a la dinámica del sistema, lo que garantiza mejoras de políticas monótonas. Este método se prueba en escenarios de gran escala como el control del tráfico y las redes eléctricas, centrándose en el control descentralizado de los agentes para un rendimiento óptimo.
El estudio demuestra el rendimiento superior de un marco MARL descentralizado, probado tanto en simuladores como en sistemas del mundo real. En comparación con las líneas base centralizadas como MAG y CPPO, el enfoque reduce significativamente los costos de comunicación (entre un 5 y un 35 %) al tiempo que mejora la convergencia y la eficiencia de la muestra. El método funcionó bien en todas las tareas de control, como la gestión de vehículos y señales de tráfico, el control de la red pandémica y las operaciones de la red eléctrica, superando constantemente las líneas base. Las longitudes de implementación más cortas y la selección optimizada de vecinos mejoraron las predicciones del modelo y los resultados de la capacitación. Estos resultados resaltan la escalabilidad y la eficacia del marco en la gestión de sistemas complejos a gran escala.
En conclusión, el estudio presenta un marco MARL escalable y eficaz para gestionar grandes sistemas con cientos de agentes, superando las capacidades de los métodos descentralizados anteriores. El enfoque aprovecha el intercambio mínimo de información para evaluar las condiciones globales, de manera similar a la teoría de los seis grados de separación. Integra la optimización de políticas descentralizadas basada en modelos, lo que mejora la eficiencia y la escalabilidad de la toma de decisiones al reducir las necesidades de comunicación y datos. Al centrarse en las observaciones locales y refinar las políticas mediante el aprendizaje de modelos, el marco mantiene un alto rendimiento incluso a medida que aumenta el tamaño del sistema. Los resultados destacan su potencial para aplicaciones avanzadas de gestión del tráfico, la energía y las pandemias.
Echa un vistazo a la Papel. Todo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y LinkedInÚnete a nuestro Canal de Telegram.
Si te gusta nuestro trabajo, te encantará nuestro hoja informativa..
No olvides unirte a nuestro Subreddit con más de 50 000 millones de usuarios

A Sana Hassan, pasante de consultoría en Marktechpost y estudiante de doble titulación en el IIT Madrás, le apasiona aplicar la tecnología y la IA para abordar desafíos del mundo real. Con un gran interés en resolver problemas prácticos, aporta una perspectiva nueva a la intersección de la IA y las soluciones de la vida real.