
La inteligencia artificial (IA) ha avanzado mucho en los últimos años, especialmente con el desarrollo de modelos lingüísticos a gran escala. Estos modelos, entrenados con conjuntos de datos masivos como textos de Internet, han demostrado capacidades impresionantes en tareas basadas en el conocimiento, como responder preguntas, resumir contenido y comprender instrucciones. Sin embargo, a pesar de su éxito, estos modelos necesitan ayuda en dominios especializados donde los datos son escasos o muy específicos. Entrenar estos modelos para que funcionen bien en áreas específicas sigue siendo un obstáculo importante, ya que solo se dispone de una pequeña cantidad de texto.
Un problema central en la investigación de la IA es la forma ineficiente en que los modelos adquieren conocimiento a partir de pequeños conjuntos de datos. Los modelos actuales necesitan estar expuestos a miles de variaciones del mismo hecho para aprenderlo de manera efectiva. Esto plantea un problema cuando un hecho aparece solo una o dos veces en un corpus especializado, lo que dificulta que los modelos comprendan y generalicen a partir de una información tan limitada. Esta ineficiencia es aún más pronunciada cuando se adapta un modelo de lenguaje general a un campo nuevo y específico en el que no existen representaciones diversas de conceptos clave.
Los métodos actuales de IA intentan abordar este problema mediante un entrenamiento previo con conjuntos de datos masivos, lo que proporciona a los modelos una comprensión amplia de temas generales. Sin embargo, este enfoque no es eficaz para dominios con un corpus de información pequeño. Algunos investigadores han intentado resolver esto parafraseando el texto original varias veces para crear representaciones diversas. Sin embargo, este método, aunque sencillo, necesita más capacidad para introducir nuevas perspectivas o profundizar la comprensión. Después de unas cuantas rondas de reformulación, el rendimiento del modelo tiende a estancarse, ya que la reformulación por sí sola no proporciona suficiente variación para lograr mejoras significativas en el aprendizaje.
Investigadores de la Universidad de Stanford presentaron EntiGraph, un enfoque innovador para resolver este problema mediante la generación de datos sintéticos. El equipo, compuesto por miembros del Departamento de Estadística y del Departamento de Ciencias de la Computación, desarrolló EntiGraph para generar un gran corpus sintético a partir de un pequeño conjunto de datos específicos de un dominio. El objetivo es ayudar a los modelos a aprender de manera más eficaz al proporcionar una mayor diversidad de ejemplos. EntiGraph identifica las entidades clave dentro del texto original y luego utiliza un modelo de lenguaje para generar contenido nuevo y variado en torno a las relaciones entre estas entidades. Este método permite la creación de un conjunto de entrenamiento diverso, incluso a partir de una pequeña cantidad de datos.
EntiGraph comienza extrayendo entidades importantes de un conjunto de datos determinado. Las entidades pueden ser personas, lugares o conceptos centrales del texto. Después de identificar estas entidades, el algoritmo utiliza un modelo de lenguaje para describir sus relaciones. Estas descripciones se combinan luego en un conjunto de datos sintético que amplía el corpus original, lo que proporciona al modelo de lenguaje un conjunto de datos de entrenamiento mucho más grande y rico. Este proceso permite que el modelo de lenguaje aprenda conexiones entre entidades de formas que no están presentes en el texto original, lo que conduce a una mejor adquisición de conocimientos. Además, EntiGraph organiza estas relaciones en un gráfico de conocimiento, que permite una mayor exploración de cómo interactúan las diferentes entidades dentro del conjunto de datos.
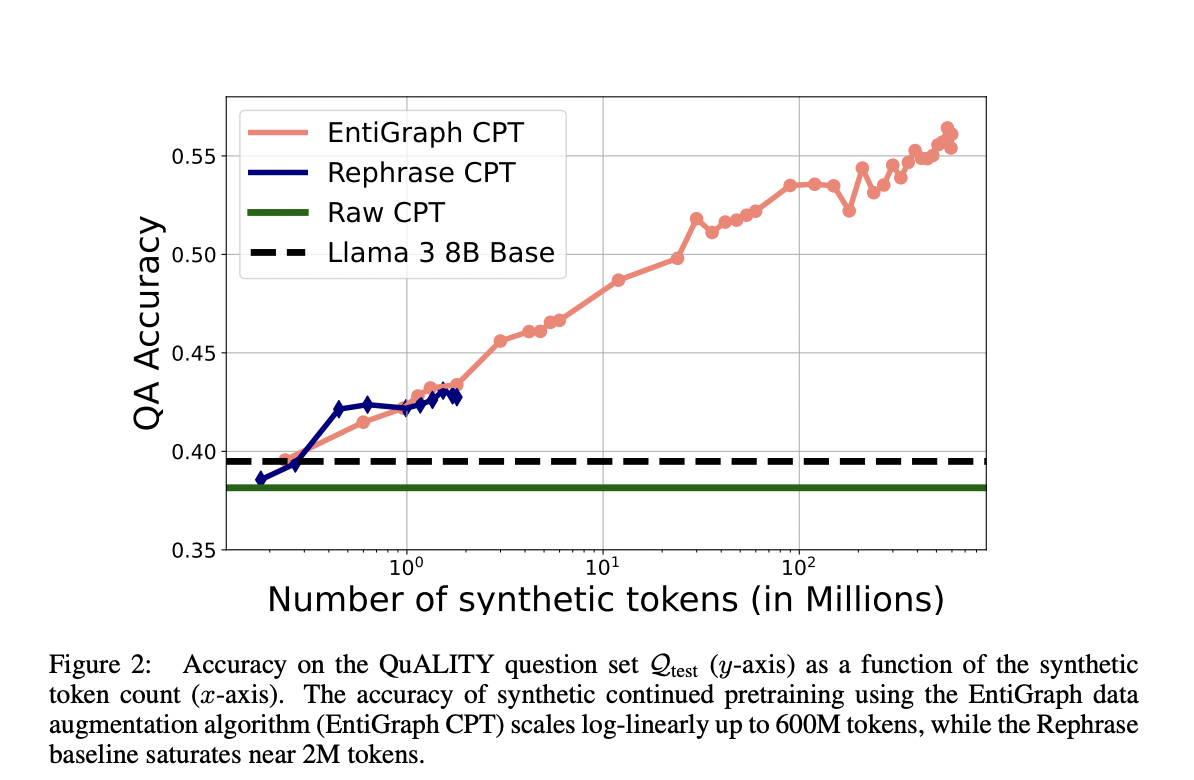
El rendimiento de EntiGraph se puso a prueba en una serie de experimentos y los resultados fueron prometedores. Los investigadores tomaron un corpus de 1,3 millones de tokens y utilizaron EntiGraph para generar un conjunto de datos sintéticos que contenía 600 millones de tokens. Luego, entrenaron previamente un modelo de lenguaje, Llama 3 8B, en este conjunto de datos más grande. Los resultados mostraron una mejora log-lineal en la precisión a medida que aumentaba la cantidad de tokens sintéticos. Por ejemplo, la precisión del modelo en tareas de preguntas y respuestas mejoró del 39,49 % cuando se utilizó el conjunto de datos original al 56,42 % después del entrenamiento previo en el corpus sintético. Además, el entrenamiento previo sintético con EntiGraph proporcionó hasta un 80 % del aumento de precisión que los modelos logran cuando pueden acceder a los documentos originales durante la inferencia. Esto demuestra que incluso sin acceso a los datos originales, los modelos pueden funcionar bien después del entrenamiento en un corpus sintético.
El estudio también reveló que EntiGraph supera a los métodos existentes, como la simple reformulación del conjunto de datos. En una comparación, el corpus reformulado contenía solo 1,8 millones de tokens y la precisión del modelo se estancó en el 43,08 %. En cambio, EntiGraph mejoró el rendimiento del modelo incluso cuando el conjunto de datos sintéticos creció hasta los 600 millones de tokens. La capacidad de sintetizar conjuntos de datos más grandes y diversos permitió una transferencia de conocimiento más eficaz, lo que demuestra la superioridad de este método para permitir que los modelos de lenguaje aprendan de conjuntos de datos pequeños y especializados.
En conclusión, la introducción de EntiGraph marca un avance significativo a la hora de abordar los desafíos de la eficiencia de los datos en los modelos de IA. El método genera con éxito un corpus sintético diverso a partir de un pequeño conjunto de datos, lo que permite a los modelos adquirir conocimientos específicos del dominio de forma más eficaz. Esta investigación destaca un enfoque novedoso que podría conducir a nuevos desarrollos en las técnicas de entrenamiento de IA, en particular para campos especializados donde los datos son limitados. Los resultados muestran que EntiGraph proporciona una solución viable para superar las limitaciones de los métodos existentes, lo que permite que los modelos de lenguaje se adapten mejor a dominios específicos y realicen tareas complejas con mayor precisión.
Echa un vistazo a la PapelTodo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de Telegram y LinkedIn Gr¡Arriba!. Si te gusta nuestro trabajo, te encantará nuestro hoja informativa..
No olvides unirte a nuestro Subreddit con más de 50 000 millones de usuarios

Nikhil es consultor en prácticas en Marktechpost. Está cursando una doble titulación integrada en Materiales en el Instituto Indio de Tecnología de Kharagpur. Nikhil es un entusiasta de la IA y el aprendizaje automático que siempre está investigando aplicaciones en campos como los biomateriales y la ciencia biomédica. Con una sólida formación en ciencia de los materiales, está explorando nuevos avances y creando oportunidades para contribuir.