
La IA ha tenido un impacto significativo en la atención médica, particularmente en el diagnóstico de enfermedades y la planificación del tratamiento. Un área que está ganando atención es el desarrollo de modelos médicos de lenguaje y visión amplia (Med-LVLM), que combinan datos visuales y textuales para herramientas de diagnóstico avanzadas. Estos modelos han demostrado un gran potencial para mejorar el análisis de imágenes médicas complejas, ofreciendo respuestas interactivas e inteligentes que pueden ayudar a los médicos en la toma de decisiones clínicas. Sin embargo, por muy prometedoras que sean estas herramientas, no están exentas de desafíos críticos que limitan su adopción generalizada en la atención médica.
Un problema importante al que se enfrentan los Med-LVLM es la tendencia a producir información médica inexacta o “alucinada”. Estas alucinaciones objetivas pueden afectar gravemente los resultados de los pacientes si los modelos generan diagnósticos erróneos o malinterpretan imágenes médicas. Las razones principales de estos problemas son la necesidad de conjuntos de datos médicos etiquetados de gran tamaño y de alta calidad y las brechas de distribución entre los datos utilizados para entrenar estos modelos y los datos encontrados en entornos clínicos del mundo real. Esta discrepancia entre los datos de entrenamiento y los datos de implementación reales crea importantes preocupaciones sobre la confiabilidad, lo que dificulta la confianza en estos modelos en escenarios médicos críticos. Además, las soluciones actuales, como las técnicas de ajuste fino y generación aumentada de recuperación (RAG), tienen limitaciones, especialmente cuando se aplican en diversos campos médicos como radiología, patología y oftalmología.
Los métodos existentes para mejorar el rendimiento de Med-LVLM se centran principalmente en dos enfoques: ajuste fino y RAG. El ajuste fino implica ajustar los parámetros del modelo basándose en conjuntos de datos más pequeños y especializados para mejorar la precisión, pero la disponibilidad limitada de datos etiquetados de alta calidad obstaculiza este método. Además, los modelos ajustados a menudo necesitan funcionar mejor cuando se aplican a datos nuevos e invisibles. Por el contrario, RAG permite que los modelos recuperen conocimiento externo durante el proceso de inferencia, ofreciendo referencias en tiempo real que podrían ayudar a mejorar la precisión de los hechos. Sin embargo, esta técnica podría ser aún mejor. Los sistemas actuales basados en RAG a menudo necesitan ayuda para generalizarse en diferentes dominios médicos, lo que limita su confiabilidad y provoca una posible desalineación entre la información recuperada y el problema médico real que se aborda.
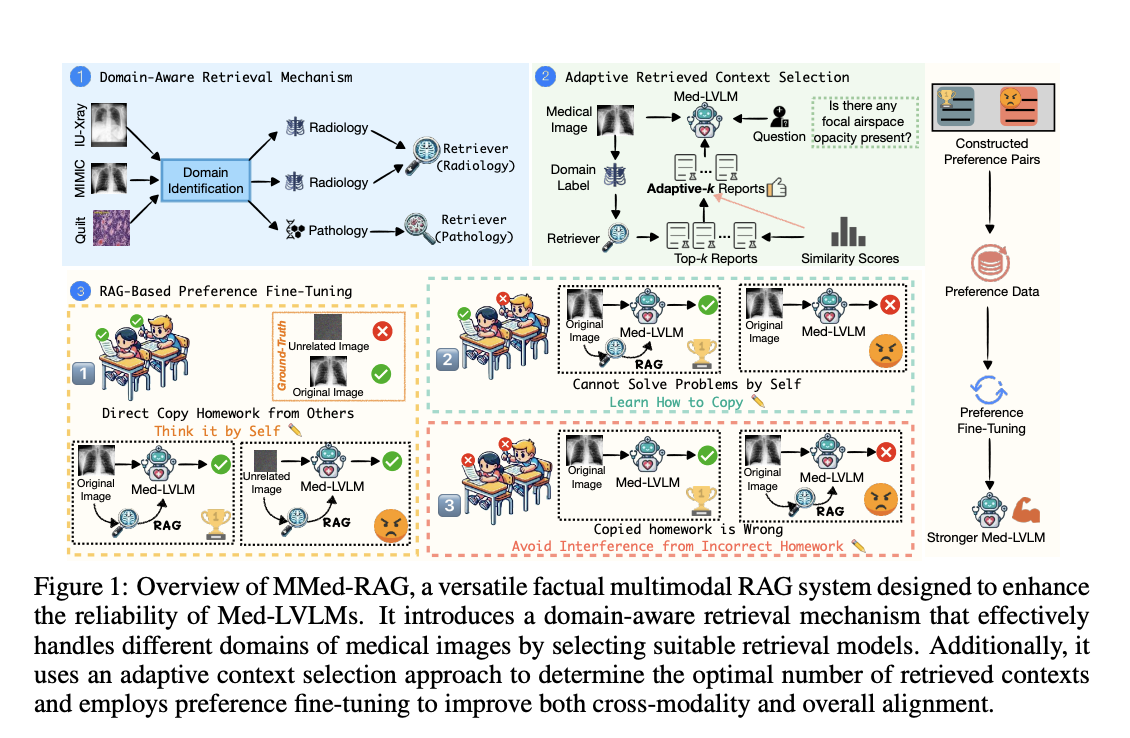
Investigadores de la UNC-Chapel Hill, la Universidad de Stanford, la Universidad de Rutgers, la Universidad de Washington, la Universidad de Brown y PloyU introdujeron un nuevo sistema llamado MMed-RAGun versátil sistema de generación aumentada de recuperación multimodal diseñado específicamente para modelos médicos de visión y lenguaje. MMed-RAG tiene como objetivo mejorar significativamente la precisión fáctica de Med-LVLM mediante la implementación de un mecanismo de recuperación con reconocimiento de dominio. Este mecanismo puede manejar varios tipos de imágenes médicas, como radiología, oftalmología y patología, asegurando que el modelo de recuperación sea apropiado para el dominio médico específico. Los investigadores también desarrollaron un método de selección de contexto adaptativo que ajusta la cantidad de contextos recuperados durante la inferencia, asegurando que el modelo utilice solo información relevante y de alta calidad. Esta selección adaptativa ayuda a evitar errores comunes cuando los modelos recuperan demasiados o muy pocos datos, lo que podría generar imprecisiones.
El sistema MMed-RAG se basa en tres componentes clave:
- El recuperación con reconocimiento de dominio El mecanismo garantiza que el modelo recupere información específica del dominio que se alinea estrechamente con la imagen médica de entrada. Por ejemplo, las imágenes de radiología se combinarían con información radiológica adecuada, mientras que las imágenes de patología se extraerían de bases de datos específicas de patología.
- El selección de contexto adaptativo El método mejora la calidad de la información recuperada mediante el uso de puntuaciones de similitud para filtrar datos irrelevantes o de baja calidad. Este enfoque dinámico garantiza que el modelo sólo considere los contextos más relevantes, lo que reduce el riesgo de alucinaciones factuales.
- El Ajuste de preferencias basado en RAG optimiza la alineación entre modalidades del modelo, asegurando que la información recuperada y la entrada visual estén correctamente alineadas con la verdad del terreno, mejorando así la confiabilidad general del modelo.
MMed-RAG se probó en cinco conjuntos de datos médicos, que abarcan radiología, patología y oftalmología, con resultados sobresalientes. El sistema logró una mejora del 43,8 % en la precisión objetiva en comparación con los Med-LVLM anteriores, destacando su capacidad para mejorar la confiabilidad del diagnóstico. En las tareas de respuesta a preguntas médicas (VQA), MMed-RAG mejoró la precisión en un 18,5% y en la generación de informes médicos logró una notable mejora del 69,1%. Estos resultados demuestran la eficacia del sistema en tareas cerradas y abiertas, donde la información recuperada es fundamental para obtener respuestas precisas. Además, la técnica de ajuste de preferencias utilizada por MMed-RAG aborda la desalineación entre modalidades, un problema común en otros Med-LVLM, donde los modelos luchan por equilibrar la entrada visual con la información textual recuperada.

Las conclusiones clave de esta investigación incluyen:
- MMed-RAG logró un aumento del 43,8 % en la precisión fáctica en cinco conjuntos de datos médicos.
- El sistema mejoró la precisión del VQA médico en un 18,5 % y la generación de informes médicos en un 69,1 %.
- El mecanismo de recuperación con reconocimiento de dominio garantiza que las imágenes médicas se combinen con el contexto correcto, lo que mejora la precisión del diagnóstico.
- La selección de contexto adaptativa ayuda a reducir la recuperación de datos irrelevantes, lo que aumenta la confiabilidad de la salida del modelo.
- El ajuste de preferencias basado en RAG aborda eficazmente la desalineación entre las entradas visuales y la información recuperada, mejorando el rendimiento general del modelo.

En conclusión, MMed-RAG avanza significativamente los modelos médicos de visión y lenguaje al abordar desafíos clave relacionados con la precisión fáctica y la alineación del modelo. Al incorporar la recuperación consciente del dominio, la selección adaptativa del contexto y el ajuste de preferencias, el sistema mejora la confiabilidad objetiva de los Med-LVLM y mejora su generalización en múltiples dominios médicos. Este sistema ha mostrado mejoras sustanciales en la precisión del diagnóstico y la calidad de los informes médicos generados. Estos avances posicionan a MMed-RAG como un paso crucial para hacer que los diagnósticos médicos asistidos por IA sean más confiables y dignos de confianza.
Mira el Papel y GitHub. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de telegramas y LinkedIn Grarriba. Si te gusta nuestro trabajo, te encantará nuestro hoja informativa.. No olvides unirte a nuestro SubReddit de más de 50.000 ml.
[Upcoming Live Webinar- Oct 29, 2024] La mejor plataforma para ofrecer modelos optimizados: motor de inferencia Predibase (promocionado)
Asif Razzaq es el director ejecutivo de Marktechpost Media Inc.. Como emprendedor e ingeniero visionario, Asif está comprometido a aprovechar el potencial de la inteligencia artificial para el bien social. Su esfuerzo más reciente es el lanzamiento de una plataforma de medios de inteligencia artificial, Marktechpost, que se destaca por su cobertura en profundidad del aprendizaje automático y las noticias sobre aprendizaje profundo que es técnicamente sólida y fácilmente comprensible para una amplia audiencia. La plataforma cuenta con más de 2 millones de visitas mensuales, lo que ilustra su popularidad entre el público.