
La integración de capacidades de visión y lenguaje en la IA ha dado lugar a avances en los modelos de visión-lenguaje (VLM). Estos modelos tienen como objetivo procesar e interpretar datos visuales y textuales simultáneamente, permitiendo aplicaciones como subtítulos de imágenes, respuesta visual a preguntas, reconocimiento óptico de caracteres y análisis de contenido multimodal. Los VLM desempeñan un papel importante en el desarrollo de sistemas autónomos, interacciones mejoradas entre humanos y computadoras y herramientas eficientes de procesamiento de documentos al cerrar la brecha entre estas dos modalidades de datos. Aún así, la complejidad de manejar datos visuales de alta resolución junto con diversas entradas de texto sigue siendo un desafío importante en este dominio.
Las investigaciones existentes han abordado algunas de estas limitaciones utilizando codificadores de visión estática que carecen de adaptabilidad a alta resolución y tamaños de entrada variables. Los modelos de lenguaje previamente entrenados que se utilizan con codificadores de visión a menudo introducen ineficiencias, ya que no están optimizados para tareas multimodales. Si bien algunos modelos incorporan escasas técnicas de cálculo para gestionar la complejidad, con frecuencia necesitan mejorar la precisión en diversos conjuntos de datos. Además, los conjuntos de datos de entrenamiento utilizados en estos modelos a menudo necesitan más diversidad y granularidad específica de la tarea, lo que dificulta aún más el rendimiento. Por ejemplo, muchos modelos tienen un rendimiento inferior en tareas especializadas como la interpretación de gráficos o el análisis de documentos densos debido a estas limitaciones.
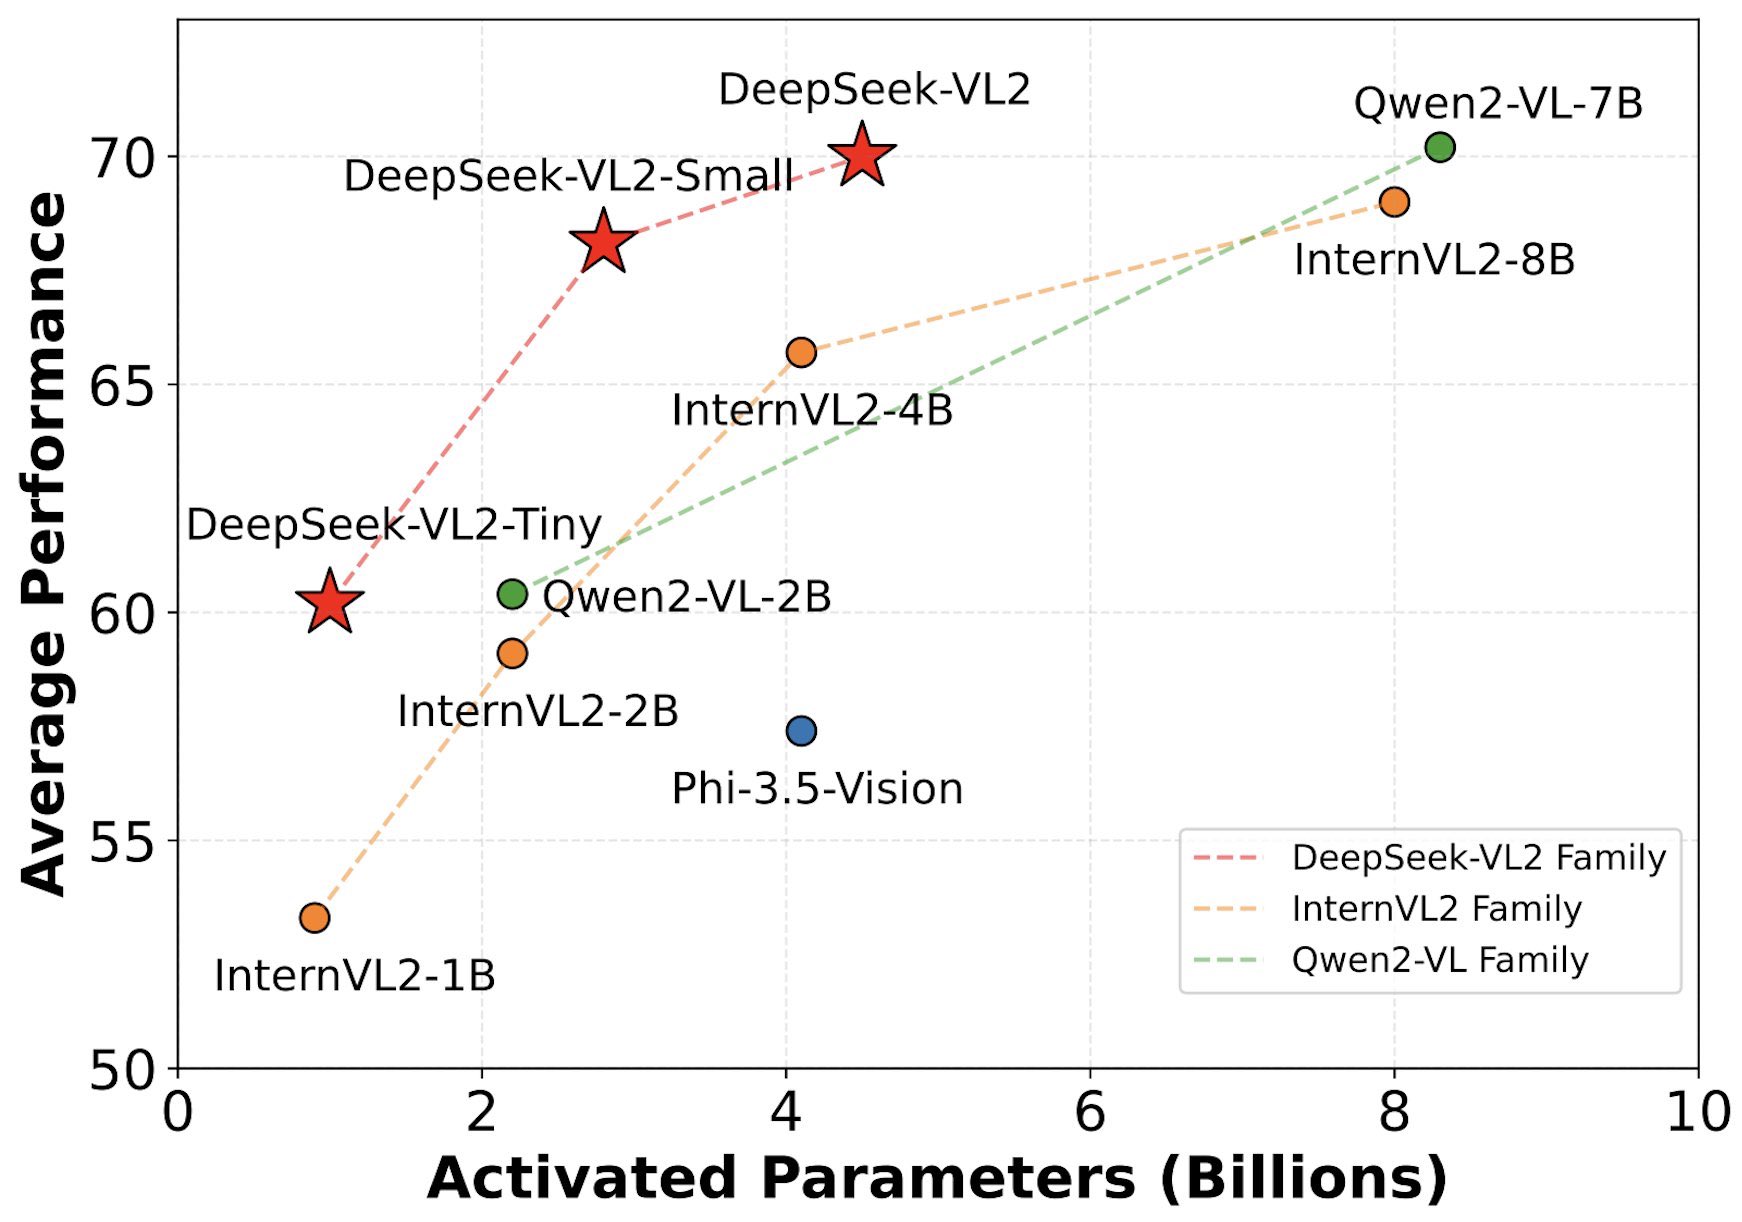
Los investigadores de DeepSeek-AI han presentado el Serie DeepSeek-VL2una nueva generación de modelos de visión y lenguaje de combinación de expertos (MoE) de código abierto. Estos modelos aprovechan innovaciones de vanguardia, incluido el mosaico dinámico para la codificación de la visión, un mecanismo de atención latente de cabezas múltiples para tareas lingüísticas y un marco DeepSeek-MoE. DeepSeek-VL2 ofrece tres configuraciones con diferentes parámetros activados (Los parámetros activados se refieren al subconjunto de parámetros de un modelo que se utilizan dinámicamente durante una tarea o cálculo específico.):
- DeepSeek-VL2-Tiny con 3,37 mil millones de parámetros (1,0 mil millones de parámetros activados)
- DeepSeek-VL2-Small con 16,1 mil millones de parámetros (2,8 mil millones de parámetros activados)
- DeepSeek-VL2 con 27,5 mil millones de parámetros (4,5 mil millones de parámetros activados)
Esta escalabilidad garantiza la adaptabilidad a diversas necesidades de aplicaciones y presupuestos computacionales.
La arquitectura de DeepSeek-VL2 está diseñada para optimizar el rendimiento y al mismo tiempo minimizar las demandas computacionales. El enfoque de mosaico dinámico garantiza que las imágenes de alta resolución se procesen sin perder detalles críticos, lo que lo hace particularmente efectivo para el análisis de documentos y las tareas de conexión visual. Además, el mecanismo de atención latente de múltiples cabezas permite que el modelo administre grandes volúmenes de datos textuales de manera eficiente, reduciendo la sobrecarga computacional típicamente asociada con el procesamiento de entradas de lenguaje denso. El marco DeepSeek-MoE, que activa solo un subconjunto de parámetros durante la ejecución de la tarea, mejora aún más la escalabilidad y la eficiencia. La capacitación de DeepSeek-VL2 incorpora un conjunto de datos multimodal diverso y completo, lo que permite que el modelo sobresalga en diversas tareas, incluido el reconocimiento óptico de caracteres (OCR), la respuesta visual a preguntas y la interpretación de gráficos.
Mientras verifica las actuaciones, la configuración pequeña, por ejemplo, logró una impresionante precisión del 92,3 % en tareas de OCR, superando a los modelos existentes por un margen significativo. En las pruebas de puesta a tierra visual, el modelo demostró una mejora del 15 % en precisión en comparación con sus predecesores. Además, DeepSeek-VL2 mostró una eficiencia notable, ya que requirió un 30 % menos de recursos computacionales que modelos comparables y, al mismo tiempo, mantuvo una precisión de última generación. Los resultados también destacaron la capacidad del modelo para generalizar entre tareas, y su variante Estándar logró puntuaciones destacadas en puntos de referencia de razonamiento multimodal. Estos logros subrayan la eficacia de los modelos propuestos para abordar los desafíos asociados con el procesamiento de imágenes y textos de alta resolución.
Varias conclusiones de la serie de modelos DeepSeek-VL2 son las siguientes:
- Al dividir imágenes de alta resolución en mosaicos más pequeños, los modelos mejoran la extracción de características y reducen la sobrecarga computacional. Este enfoque es útil para análisis de documentos densos y diseños visuales complejos.
- La disponibilidad de configuraciones pequeñas (3B), pequeñas (16B) y estándar (27B) garantiza la adaptabilidad a diversas aplicaciones, desde implementaciones livianas hasta tareas que consumen muchos recursos.
- El uso de un conjunto de datos completo que abarca OCR y tareas de conexión visual mejora la generalización del modelo y el rendimiento de tareas específicas.
- El escaso marco de cálculo activa solo los parámetros necesarios, lo que permite reducir los costos computacionales sin comprometer la precisión.
En conclusión, DeepSeek-VL2 es una serie de modelos de lenguaje de visión de código abierto con tres variantes (parámetros activados 1.8B, 2.8B y 4.5B). El equipo de investigación ha introducido una serie de modelos que sobresale en aplicaciones del mundo real al abordar limitaciones críticas en escalabilidad, eficiencia computacional y adaptabilidad de tareas. Sus mecanismos innovadores y dinámicos de mosaico y atención latente de múltiples cabezales permiten un procesamiento de imágenes preciso y un manejo eficiente del texto, logrando resultados de última generación en tareas como OCR y conexión a tierra visual. La serie de modelos establece un nuevo estándar en rendimiento de IA con configuraciones escalables y un conjunto de datos multimodal completo.
Verificar el Modelos abrazando la cara. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de telegramas y LinkedIn Grarriba. No olvides unirte a nuestro SubReddit de más de 60.000 ml.
Asif Razzaq es el director ejecutivo de Marktechpost Media Inc.. Como emprendedor e ingeniero visionario, Asif está comprometido a aprovechar el potencial de la inteligencia artificial para el bien social. Su esfuerzo más reciente es el lanzamiento de una plataforma de medios de inteligencia artificial, Marktechpost, que se destaca por su cobertura en profundidad del aprendizaje automático y las noticias sobre aprendizaje profundo que es técnicamente sólida y fácilmente comprensible para una amplia audiencia. La plataforma cuenta con más de 2 millones de visitas mensuales, lo que ilustra su popularidad entre el público.