
Las organizaciones enfrentan desafíos significativos al implementar LLM en el panorama tecnológico actual. Los problemas principales incluyen la gestión de las enormes demandas computacionales requeridas para procesar altos volúmenes de datos, lograr una baja latencia y garantizar un equilibrio óptimo entre las tareas intensivas en CPU, como la programación y la asignación de memoria, y los cálculos intensivos en GPU. Procesar repetidamente las entradas similares agravan aún más las ineficiencias en muchos sistemas, lo que lleva a cálculos redundantes que ralentizan el rendimiento general. Además, la generación de salidas estructuradas como JSON o XML en tiempo real introduce más retrasos, lo que dificulta que las aplicaciones entreguen un rendimiento rápido, confiable y rentable a escala.
Sglang es un motor de inferencia de código abierto diseñado por el equipo SGLANG para abordar estos desafíos. Optimiza los recursos de CPU y GPU durante la inferencia, logrando un rendimiento significativamente mayor que muchas soluciones competitivas. Su diseño utiliza un enfoque innovador que reduce los cálculos redundantes y mejora la eficiencia general, lo que permite a las organizaciones administrar mejores las complejidades asociadas con la implementación de LLM.
Radixatention es fundamental para Sglang, que reutiliza prefijos rápidos compartidos en múltiples solicitudes. Este enfoque minimiza efectivamente el procesamiento repetido de secuencias de entrada similares, mejorando el rendimiento. La técnica es ventajosa en las interfaces conversacionales o aplicaciones de generación de recuperación auge, donde se procesan con frecuencia indicaciones similares. Al eliminar los cálculos redundantes, el sistema asegura que los recursos se usen de manera más eficiente, contribuyendo a tiempos de procesamiento más rápidos y aplicaciones más receptivas.
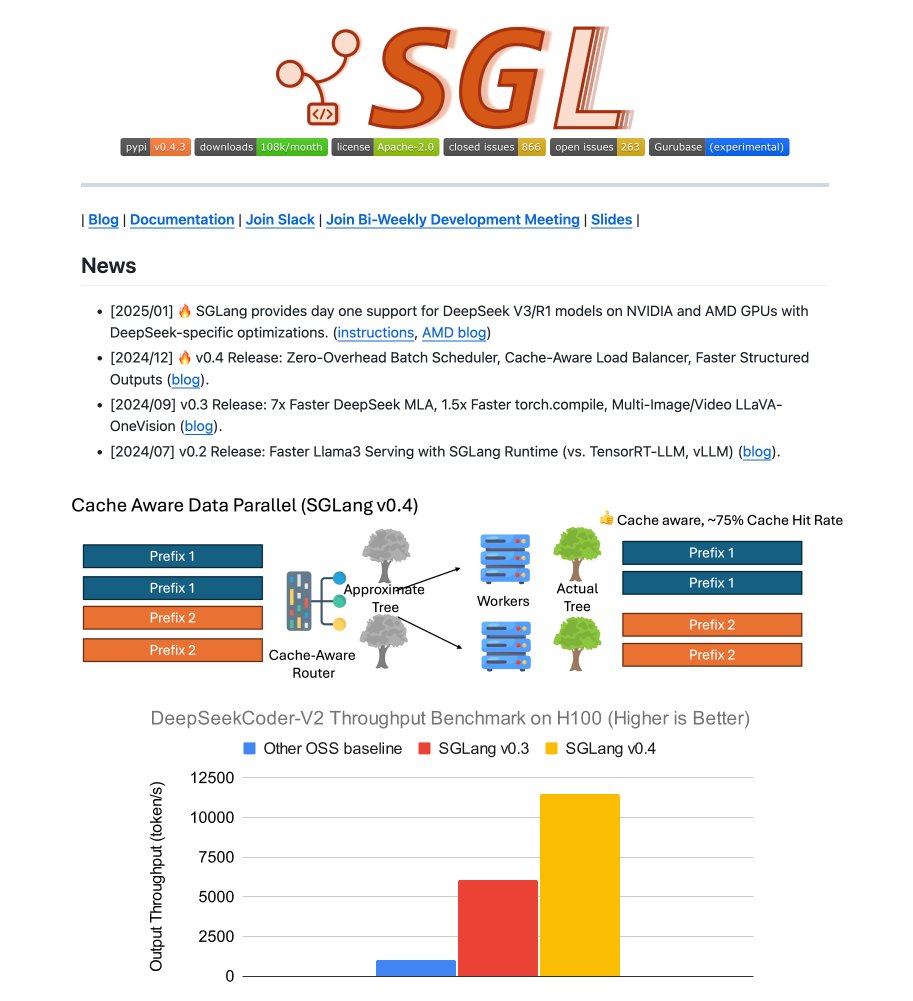
Otra característica crítica de SGLANG es su programador de lotes cero. Los sistemas de inferencia anteriores a menudo sufren una sobrecarga significativa de la CPU debido a tareas como la programación de lotes, la asignación de memoria y el preprocesamiento rápido. En muchos casos, estas operaciones dan como resultado períodos de inactividad para la GPU, que a su vez obstaculiza el rendimiento general. Sglang aborda este cuello de botella superponiendo la programación de la CPU con cálculos de GPU en curso. El planificador mantiene el GPU continuamente activado al ejecutar un lote adelante y preparando todos los metadatos necesarios para el próximo lote. El perfil ha demostrado que este diseño reduce el tiempo de inactividad y logra mejoras de velocidad medibles, especialmente en configuraciones que involucran modelos más pequeños y un paralelismo tensor extenso.
Sglang también incorpora un equilibrador de carga consciente de caché que se aparta de los métodos de equilibrio de carga convencionales, como la programación de redes redondas. Las técnicas tradicionales a menudo ignoran el estado del caché de valor clave (KV), lo que lleva a un uso ineficiente de recursos. En contraste, el equilibrador de carga de Sglang predice las tasas de golpe de caché de diferentes trabajadores y dirige las solicitudes entrantes a aquellos con la mayor probabilidad de un golpe de caché. Este enrutamiento dirigido aumenta el rendimiento y mejora la utilización de caché. El mecanismo se basa en un árbol Radix aproximado que refleja el estado de caché actual en cada trabajador, y actualiza perezosamente este árbol para imponer una sobrecarga mínima. El equilibrador de carga, implementado en óxido para alta concurrencia, es especialmente adecuada para entornos distribuidos de múltiples nodos.
Además de estas características, SGLANG admite atención del paralelismo de datos, una estrategia particularmente adaptada para los modelos Deepseek. Si bien muchos modelos modernos utilizan el paralelismo tensor, lo que puede conducir a un almacenamiento duplicado de caché de KV al escalar en múltiples GPU, SGLANG emplea un método diferente para modelos que utilizan atención latente de múltiples cabezas. En este enfoque, los trabajadores paralelos de datos individuales manejan de forma independiente varios lotes, como la pregramar, el decodificación o la inactividad. Los datos procesados por la atención se agregan luego entre los trabajadores antes de pasar por capas posteriores, como una capa de mezcla de expertos, y luego redistribuido.
Sglang también se destaca en la generación eficiente de salidas estructuradas. Muchos sistemas de inferencia luchan con la decodificación en tiempo real de formatos como JSON, lo que puede ser un requisito crítico en muchas aplicaciones. Sglang aborda esto integrando un backend de gramática especializado conocido como Xgrammar. Esta integración optimiza el proceso de decodificación, lo que permite que el sistema genere salidas estructuradas hasta diez veces más rápido que otras alternativas de código abierto. Esta capacidad es especialmente valiosa cuando producen datos legibles por la máquina rápidamente, esenciales para el procesamiento posterior o las aplicaciones interactivas.
Varias compañías de alto perfil han reconocido los beneficios prácticos de SGLANG. Por ejemplo, el bytedance canaliza una gran parte de sus tuberías internos de PNL a través de este motor, procesando petabytes de datos diariamente. Del mismo modo, XAI ha informado de ahorros de costos sustanciales al aprovechar la programación optimizada y la gestión efectiva de caché, lo que resulta en una reducción notable en los gastos de servicio. Estas aplicaciones del mundo real destacan la capacidad de Sglang para operar de manera eficiente a escala, entregando mejoras de rendimiento y beneficios de costos.
Sglang se publica bajo la licencia de código abierto Apache 2.0 y es accesible para la investigación académica y las aplicaciones comerciales. Su compatibilidad con los estándares de OpenAI y la provisión de una API de Python permite a los desarrolladores integrarlo sin problemas en los flujos de trabajo existentes. El motor admite muchos modelos, incluidos los populares como Llama, Mistral, Gemma, Qwen, Deepseek, Phi y Granite. Está diseñado para funcionar en varias plataformas de hardware, incluidas las GPU NVIDIA y AMD, e integra técnicas de cuantificación avanzadas como FP8 e INT4. Las mejoras futuras incluirán peso FP6 y cuantificación de activación de FP8, tiempos de inicio más rápidos y equilibrio de carga de nube cruzada.
Varias conclusiones clave de la investigación sobre Sglang incluyen:
- Sglang aborda desafíos críticos en la implementación de modelos de idiomas grandes al optimizar el equilibrio entre las tareas de CPU y GPU.
- Radixatent Minimiza los cálculos redundantes, mejorando el rendimiento en escenarios de conversación y recuperación.
- Un planificador de lotes de cero superposición se superpone a la programación de la CPU con operaciones de GPU para garantizar el procesamiento continuo y reducir el tiempo de inactividad.
- Un equilibrador de carga consciente de caché predice eficientemente las tasas de accesorios de caché y las solicitudes de rutas, aumentando el rendimiento general y la utilización de caché.
- La atención del paralelismo de datos reduce la sobrecarga de la memoria y mejora el rendimiento de decodificación para modelos de atención latente de múltiples cabezas.
- La integración de Xgrammar permite la generación rápida de salidas estructuradas, mejorando significativamente la velocidad de procesamiento para formatos como JSON.
- Los beneficios prácticos de SGLANG se demuestran por su adopción en entornos de producción a gran escala, que contribuyen a ahorros de costos sustanciales y mejoras en el rendimiento.
Verificar el Repositorio de Github, Documentación y Detalle técnico. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, siéntete libre de seguirnos Gorjeo Y no olvides unirte a nuestro 75k+ ml de subreddit.
Asif Razzaq es el CEO de MarktechPost Media Inc .. Como empresario e ingeniero visionario, ASIF se compromete a aprovechar el potencial de la inteligencia artificial para el bien social. Su esfuerzo más reciente es el lanzamiento de una plataforma de medios de inteligencia artificial, MarktechPost, que se destaca por su cobertura profunda de noticias de aprendizaje automático y de aprendizaje profundo que es técnicamente sólido y fácilmente comprensible por una audiencia amplia. La plataforma cuenta con más de 2 millones de vistas mensuales, ilustrando su popularidad entre el público.
