
El problema con “pensar más”
Los modelos de idiomas grandes han hecho avances impresionantes en el razonamiento matemático al extender sus procesos de cadena de pensamiento (cot), esencialmente “pensando más tiempo” a través de pasos de razonamiento más detallados. Sin embargo, este enfoque tiene limitaciones fundamentales. Cuando los modelos encuentran errores sutiles en sus cadenas de razonamiento, a menudo agravan estos errores en lugar de detectarlos y corregirlos. La autorreflexión interna frecuentemente falla, especialmente cuando el enfoque de razonamiento inicial es fundamentalmente defectuoso.
El nuevo informe de investigación de Microsoft presenta RSTAR2-agent, que adopta un enfoque diferente: en lugar de solo pensar más, enseña a los modelos a pensar más inteligente mediante el uso activo de herramientas de codificación para verificar, explorar y refinar su proceso de razonamiento.

El enfoque de agente
RSTAR2-AGENT representa un cambio hacia el aprendizaje de refuerzo de agente, donde un modelo de parámetros de 14b interactúa con un entorno de ejecución de Python a lo largo de su proceso de razonamiento. En lugar de confiar únicamente en la reflexión interna, el modelo puede escribir código, ejecutarlo, analizar los resultados y ajustar su enfoque en función de la retroalimentación concreta.
Esto crea un proceso dinámico de resolución de problemas. Cuando el modelo encuentra un problema matemático complejo, podría generar un razonamiento inicial, escribir el código de Python para probar hipótesis, analizar los resultados de la ejecución e iterar hacia una solución. El enfoque refleja cómo funcionan a menudo los matemáticos humanos, utilizando herramientas computacionales para verificar las intuiciones y explorar diferentes rutas de soluciones.
Desafíos y soluciones de infraestructura
Scaling Agentic RL presenta obstáculos técnicos significativos. Durante el entrenamiento, un solo lote puede generar decenas de miles de solicitudes de ejecución de código concurrentes, creando cuellos de botella que pueden detener la utilización de GPU. Los investigadores abordaron esto con dos innovaciones clave de infraestructura.
Primero, crearon un servicio de ejecución de código distribuido capaz de manejar 45,000 llamadas de herramientas concurrentes con latencia sub-segundo. El sistema aísla la ejecución del código del principal proceso de capacitación mientras mantiene un alto rendimiento a través del equilibrio de carga cuidadoso entre los trabajadores de la CPU.
En segundo lugar, desarrollaron un planificador de despliegue dinámico que asigna el trabajo computacional basado en la disponibilidad de caché de GPU en tiempo real en lugar de la asignación estática. Esto evita el tiempo de inactividad de GPU causado por una distribución desigual de la carga de trabajo, un problema común cuando algunos rastros de razonamiento requieren significativamente más cálculo que otros.
Estas mejoras de infraestructura permitieron que todo el proceso de capacitación se completara en solo una semana utilizando 64 GPU de AMD MI300X, lo que demuestra que las capacidades de razonamiento de nivel fronterizo no requieren recursos computacionales masivos cuando se orquestan eficientemente.
GRPO-ROC: aprendiendo de ejemplos de alta calidad
La innovación algorítmica central es la optimización de políticas relativas del grupo con el remuestreo en correcto (GRPO-ROC). El aprendizaje de refuerzo tradicional en este contexto enfrenta un problema de calidad: los modelos reciben recompensas positivas para las respuestas finales correctas incluso cuando su proceso de razonamiento incluye múltiples errores de código o uso ineficiente de herramientas.
GRPO-ROC aborda esto mediante la implementación de una estrategia de muestreo asimétrico. Durante el entrenamiento, el algoritmo:
- De exhibición despliegues iniciales para crear un grupo más grande de rastros de razonamiento
- Conserva la diversidad En intentos fallidos de mantener el aprendizaje de varios modos de error
- Filtra ejemplos positivos Para enfatizar trazas con errores de herramienta mínimos y formateo más limpio
Este enfoque garantiza que el modelo aprenda del razonamiento exitoso de alta calidad y aún se expone a diversos patrones de falla. El resultado es un uso de herramientas más eficiente y trazas de razonamiento más cortas y más enfocadas.

Estrategia de entrenamiento: de simple a complejo
El proceso de capacitación se desarrolla en tres etapas cuidadosamente diseñadas, comenzando con el ajuste fino supervisado que no se concentra que se centra exclusivamente en la instrucción seguida y el formateo de la herramienta, evitando deliberadamente ejemplos de razonamiento complejos que podrían crear sesgos tempranos.
Etapa 1 restringe las respuestas a 8,000 tokens, lo que obliga al modelo a desarrollar estrategias de razonamiento concisas. A pesar de esta limitación, el rendimiento salta dramáticamente, desde cerca de Zero hasta más del 70% en puntos de referencia desafiantes.
Etapa 2 extiende el límite de token a 12,000, lo que permite un razonamiento más complejo mientras mantiene las ganancias de eficiencia desde la primera etapa.
Etapa 3 Los cambios se centran en los problemas más difíciles al filtrar los que el modelo ya ha dominado, asegurando el aprendizaje continuo de casos desafiantes.
Esta progresión de razonamiento conciso a extendido, combinado con la creciente dificultad del problema, maximiza la eficiencia del aprendizaje al tiempo que minimiza la sobrecarga computacional.
Resultados innovadores
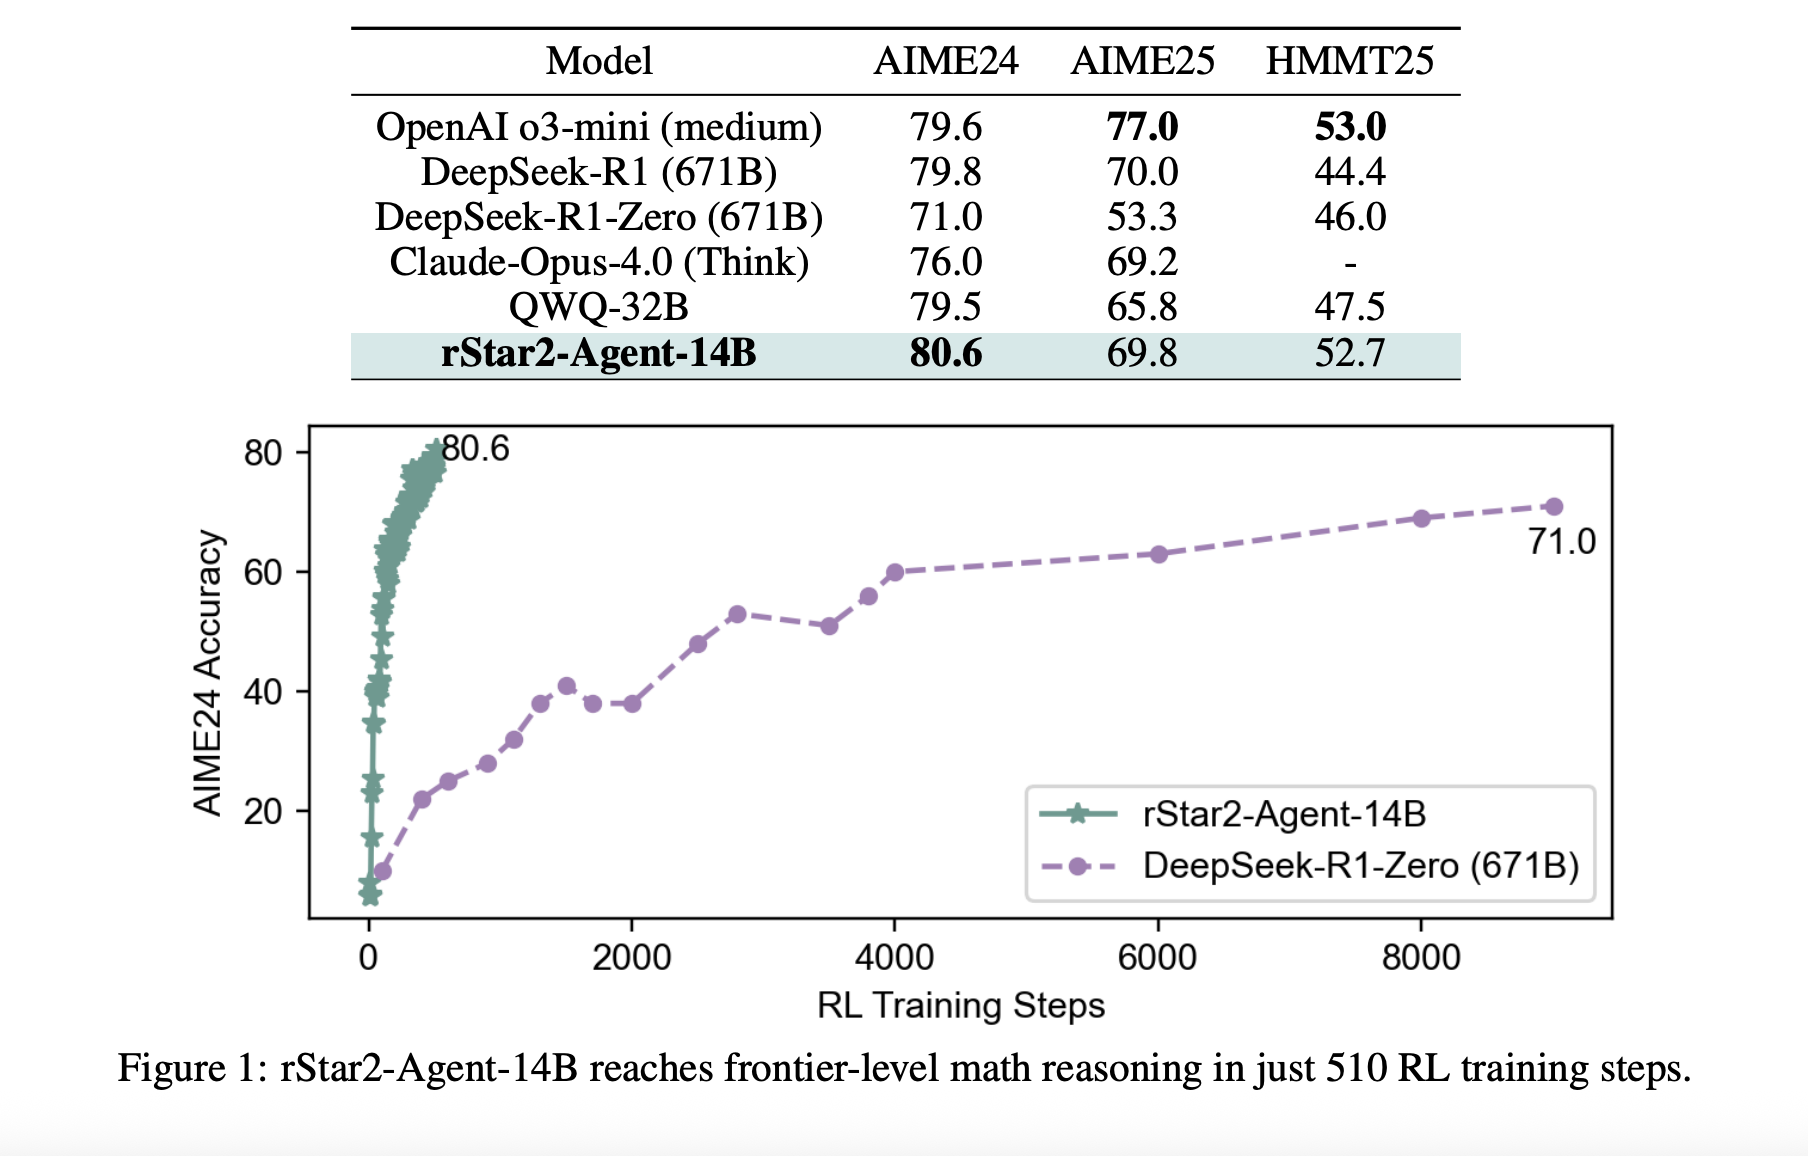
Los resultados son sorprendentes. RSTAR2-AGENT-14B alcanza el 80.6% de precisión en AIME24 y 69.8% en AIME25, superando modelos mucho más grandes, incluido el parámetro 671B, Deepseek-R1. Quizás lo más importante es que logra esto con rastros de razonamiento significativamente más cortos, lo que promueve alrededor de 10,000 tokens en comparación con más de 17,000 para modelos comparables.
Las ganancias de eficiencia se extienden más allá de las matemáticas. A pesar de la capacitación exclusiva sobre problemas matemáticos, el modelo demuestra un fuerte aprendizaje de transferencia, superando los modelos especializados en los puntos de referencia de razonamiento científico y el mantenimiento del rendimiento competitivo en las tareas de alineación general.

Comprender los mecanismos
El análisis del modelo entrenado revela patrones de comportamiento fascinantes. Los tokens de alta entropía en trazas de razonamiento se dividen en dos categorías: “tokens bifurcantes” tradicionales que desencadenan la autorreflexión y la exploración, y una nueva categoría de “tokens de reflexión” que emergen específicamente en respuesta a la retroalimentación de las herramientas.
Estos tokens de reflexión representan una forma de razonamiento basado en el entorno donde el modelo analiza cuidadosamente los resultados de la ejecución del código, diagnostica errores y ajusta su enfoque en consecuencia. Esto crea un comportamiento de resolución de problemas más sofisticado que el razonamiento puro de COT puede lograr.
Resumen
RSTAR2-AGENT demuestra que los modelos de tamaño moderado pueden lograr un razonamiento de nivel fronterizo a través de un entrenamiento sofisticado en lugar de la escala de fuerza bruta. El enfoque sugiere un camino más sostenible hacia las capacidades de IA avanzadas, una que enfatiza la eficiencia, la integración de herramientas y las estrategias de capacitación inteligente sobre el poder computacional sin procesar.
El éxito de este enfoque agente también apunta hacia futuros sistemas de IA que pueden integrar a la perfección múltiples herramientas y entornos, yendo más allá de la generación de texto estático hacia las capacidades dinámicas e interactivas de resolución de problemas.
Mira el Papel y Página de Github. No dude en ver nuestro Página de Github para tutoriales, códigos y cuadernos. Además, siéntete libre de seguirnos Gorjeo Y no olvides unirte a nuestro Subreddit de 100k+ ml y suscribirse a Nuestro boletín.
Asif Razzaq es el CEO de MarktechPost Media Inc .. Como empresario e ingeniero visionario, ASIF se compromete a aprovechar el potencial de la inteligencia artificial para el bien social. Su esfuerzo más reciente es el lanzamiento de una plataforma de medios de inteligencia artificial, MarktechPost, que se destaca por su cobertura profunda de noticias de aprendizaje automático y de aprendizaje profundo que es técnicamente sólido y fácilmente comprensible por una audiencia amplia. La plataforma cuenta con más de 2 millones de vistas mensuales, ilustrando su popularidad entre el público.