
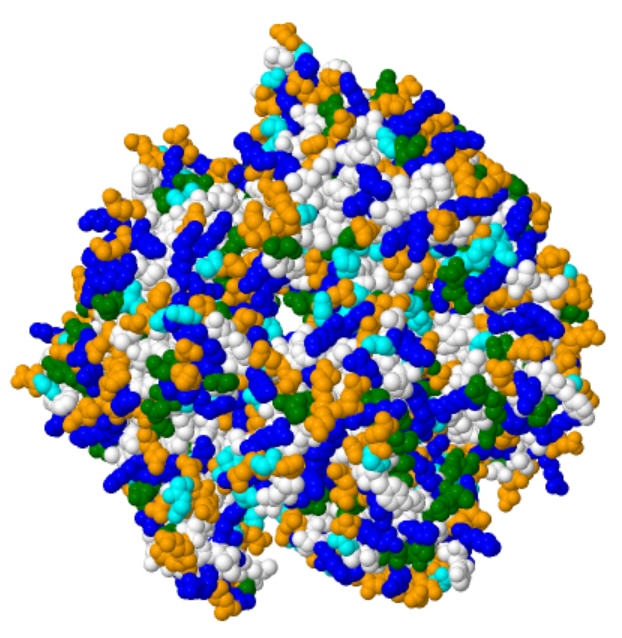
TL;DR: el desarrollo de aplicaciones de predicción/previsión para un número cada vez mayor de propósitos diferentes. Sin embargo, el ML también participa en la minería de datos, es decir, en la identificación de patrones ocultos en los propios datos. En este sentido, la base de datos RCSB PDB constituye un valioso recurso de datos biológicos, que contiene miles de estructuras 3D de proteínas obtenidas mediante diferentes técnicas experimentales. Entre ellos, la difracción de rayos X es el método que ofrece una descripción más precisa de la posición de cada átomo en la estructura de las proteínas. Al analizar el conjunto de datos de estructuras de proteínas determinadas por rayos X (más de 160.000 estructuras), se puede encontrar un patrón si tomamos en consideración tanto la posición de los aminoácidos como su tipo químico. El papel biológico de este patrón aún no se comprende completamente, pero parece bien conservado en las estructuras de organismos muy diferentes, desde animales y plantas hasta hongos y bacterias.
Empezando desde el principio
El viaje comenzó hace algunos años. En ese momento, estaba investigando adhesinas bacterianas, que son proteínas en la superficie de las bacterias que son responsables de interactuar, es decir, fijar las bacterias a superficies, como nuestros dientes, u otras bacterias para formar biopelículas (comunidades bacterianas). Recuerdo que en aquel entonces todavía estaba impresionado con una de las materias que había estudiado años antes en la universidad: la elegante y hermosa química orgánica. Entonces, cuando me encontré con una clasificación de aminoácidos (los componentes básicos de las proteínas) según su tipo químico, fue algo natural intentar y, de alguna manera, relacionar las propiedades de las adhesinas (su pegajosidad a las superficies) con el tipo químico de los aminoácidos en su estructura.
Siguiendo el consejo de otro colega estudiante de doctorado, decidí intentar idear un método para cuantificar la organización de los aminoácidos según su tipo químico en la estructura tridimensional de las adhesinas. Al tener experiencia en biología/biotecnología, no la habría cuantificado directamente, sino que la habría evaluado cualitativamente. Pero este otro estudiante de doctorado era físico, por lo que me convenció durante el almuerzo de que un enfoque más serio implicaría la cuantificación.
Ahora, mi intuición fue que si los aminoácidos del mismo tipo están juntos en la estructura 3D (formando grupos), eso facilitaría la interacción química específica con las superficies. En consecuencia, el objetivo era generar un descriptor numérico de agrupamiento de aminoácidos según su tipo químico (hidrófobo, polar, ácido, básico, especial). Aunque este fue un proyecto paralelo durante mi programa de doctorado, los directores de mi tesis me ayudaron y sugirieron medir distancias entre aminoácidos para generar ese descriptor. Y así lo hice, y ahora tenía un parámetro numérico que describía el grado en que los aminoácidos del mismo tipo se agrupaban en la estructura 3D de una proteína.
La hipótesis era simple: el parámetro/descriptor debería representar valores distintivos para las adhesinas (en comparación con otras proteínas), y eso explicaría por qué las adhesinas realmente se adhieren a las superficies. Para ello, tenía disponible una base de datos completa con miles de entradas de datos estructurales 3D de proteínas, la base de datos RCSB PDB. Además, potentes bibliotecas como Biopython facilitaron enormemente la extracción y tratamiento de datos, por lo que la fase de desarrollo, aunque en aquel entonces no existía IA generativa, fue relativamente rápida.
Lo que encontré no era lo que estaba buscando. No hubo un valor descriptivo distintivo para las adhesinas. En cambio, el descriptor parecía depender únicamente del número de aminoácidos que seguían una curva relativamente recta. Eso fue aburrido; Sabía que el descriptor tendería a aumentar con el tamaño de la proteína (número de aminoácidos), pero la esperanza era encontrar algunas irregularidades, por ejemplo, que para las adhesinas el valor del descriptor fuera notablemente mayor que en otras familias de proteínas. Entonces eso fue un “fracaso”, no había surgido nada interesante. Durante unos tres días estuve revisando el proceso, intentando encontrar algún fallo en el código, o en la metodología. Después de todo, solo obtuve esa curva recta simple al trazar el descriptor frente al tamaño de la proteína (número de aminoácidos).
Bien, pero ¿por qué esa curva relativamente recta? De hecho, al montar un modelo sencillo el R2 fue muy alto (0,979). Esto puede significar algo. Y además, ¿por qué esa pendiente particular de la curva, por qué no otra? Esto puede significar algo, no sobre las adhesinas, sino quizás sobre las proteínas en general. El hecho es que la curva nos dice que dos proteínas cualesquiera, siempre que tengan la misma cantidad de aminoácidos, tendrán un valor de descriptor muy similar. Puede que esto no parezca tan relevante al principio, pero pensemos en ello. ¿Dos proteínas? Es decir, por ejemplo, una proteína globular, casi esférica, y otra muy alargada. O, por ejemplo, una proteína en los mamíferos y otra en las plantas. Dos pares cualesquiera, o en realidad cualquier conjunto de proteínas con el mismo número de aminoácidos, tendrían el mismo valor del descriptor. Había algo ahí.
El modelo Mosaic Q
Pasaron los meses y los años. Sólo tenía una ecuación y eso no era evidencia suficiente. Al completar mi doctorado, decidí buscar ayuda para comprender mejor esta propiedad aparentemente conservada. Después de hablar con diferentes investigadores me encontré con José Antonio, catedrático de matemáticas en la Universidad de Sevilla. Estábamos hablando de caracterizar la forma y el tamaño de grupos de aminoácidos del mismo tipo en la estructura tridimensional de las proteínas, y de alguna manera relacionarlo con la ecuación empírica. Sin embargo, la tarea no fue fácil, porque no es sencillo determinar cuándo comienza y termina un grupo en la estructura tridimensional de las proteínas. Por ejemplo, un grupo de aminoácidos en la estructura 3D podría interpretarse como un grupo grande con forma irregular, o más bien dos o más grupos más pequeños, de forma esférica, que casualmente estaban cerca en la estructura. Entonces se le ocurrió una idea. En lugar de intentar derivar un modelo de tamaño y forma de conglomerados a partir de los datos experimentales, ¿por qué no generar diferentes modelos de conglomerados y ver cuál se ajusta mejor a los resultados?
Esto implicó la generación y ejecución de múltiples simulaciones estocásticas, donde se probaron diferentes combinaciones de tamaño y forma de los conglomerados. Para simplificar, supusimos que junto con el núcleo hidrofóbico (donde se agrupan todos los aminoácidos hidrofóbicos), el resto de aminoácidos (polares, ácidos, básicos, especiales) siempre se agrupaban según su tipo en grupos del mismo tamaño y forma, aunque estos grupos estaban colocados aleatoriamente a lo largo de la estructura proteica. Otras variables, como el tamaño y la forma total de las proteínas, también se determinaron de forma estocástica, para garantizar una diversidad suficiente de estructuras en las muestras. Al mismo tiempo, se implementaron diferentes controles de calidad para generar estructuras suficientemente realistas, asegurando, por ejemplo, distancias normales entre aminoácidos o frecuencias de aminoácidos. Para cada combinación de tamaño/forma de conglomerados analizados, se generaron 10.000 estructuras artificiales y se calculó el descriptor (ahora denominado Q).
Lo que encontramos fue alentador. Cada combinación de tamaño/forma de grupos produjo una curva distinta al representar Q frente al número de aminoácidos (n). Una combinación (Forma I / 8 aminoácidos por grupo) pareció encajar muy bien en el experimento. No es que ese modelo describa la agrupación de aminoácidos de las proteínas en la naturaleza, pero al menos es una buena aproximación. Además, visualizamos múltiples proteínas coloreando aminoácidos según su tipo, y la combinación de aminoácidos Forma I / 8 parecía bastante razonable. Pero lo más importante es que la gran conclusión de las simulaciones es que proporcionan un marco para comprender que la curva experimental real de Q vs n encontrada en la naturaleza no es trivial, sino que depende del tamaño y la forma de los grupos. En otras palabras, existe una forma específica en la que los aminoácidos tienden a agruparse en la estructura 3D de las proteínas, que se puede cuantificar usando Q. A esto lo llamamos modelo Mosaic Q. En teoría, podrían existir diferentes modelos de mosaico, pero los resultados muestran que en realidad sólo existe uno.
En las siguientes imágenes vemos una visión general del análisis. Así es como se relacionan el mosaico, su cuantificación mediante Q y la curva conservada (R2 = 0,979) encontrada en >160.000 estructuras experimentales.
Cabe señalar que el descriptor Q original solo cuantificaba grupos del tipo residuos hidrófobos, polares, ácidos y básicos (no residuos especiales). Otra definición alternativa del descriptor (llamada Q_alt) también incluye en su cálculo los grupos de residuos especiales.
Por otro lado, aquí se muestra un gráfico de las curvas obtenidas por las simulaciones estocásticas, mostrando cómo una configuración se ajusta mejor a los resultados experimentales, pero más importante aún, cómo varía su pendiente según la configuración (tamaño y forma) de los clusters en cada una.

Compartiendo el análisis con la comunidad.
Algunos análisis en biología y en ciencias experimentales en general ganan en profundidad cuando varios colaboradores trabajan en ellos. Por esta razón, comenzamos a construir herramientas y material visual para que cualquiera pudiera comprobar por sí mismo la presencia del patrón Mosaic Q. En este esfuerzo, un tercer miembro del equipo (la bióloga María Ángeles) fue fundamental.
Comenzamos compartiendo visualización directa de múltiples estructuras de proteínas para que se pueda apreciar el mosaico. Cuando las proteínas se procesan con cada aminoácido coloreado según su tipo químico, el patrón se vuelve visible al ojo. Por ejemplo, aquí hay algunos ejemplos de proteínas famosas, a saber, la hemoglobina, la máquina molecular CRISPR-Cas9, el supresor de tumores p53 y la pequeña enzima lisozima. El patrón de mosaico aparentemente está presente en la mayoría de las proteínas, también en estos famosos casos:
Además de nuestras propias imágenes renderizadas, el análisis ha adoptado un enfoque colaborativo. En particular, cualquier persona interesada puede generar proteínas de su elección y agregarlas como evidencia adicional del patrón Mosaic Q, creando un depósito compartido de imágenes. El objetivo es comprobar si el patrón de mosaico está presente, es decir, si, además del núcleo hidrofóbico (blanco), los aminoácidos restantes se agrupan en grupos de tamaño y forma similares en toda la estructura 3D. Hasta junio de 2026, más de 50 voluntarios han participado como observadores independientes, visualizando estructuras de su propia elección a partir de la base de datos RCSB con el software de código abierto Jmol. Esta colaboración añade una capa de independencia al estudio, ya que cada observador elige su proteína para representar entre las miles y miles de estructuras actualmente presentes en la base de datos RCSB.
Para aquellos que prefieren calcularlo en lugar de visualizarlo, hay disponible una serie de herramientas para calcular Q y Q_alt (PyPI, bio.tools), a través del paquete protein-mosaic-q. El uso básico implica estas líneas:
desde mosaicoq importar calcular_q, calcular_q_alt q = calcular_q("protein.pdb") q_alt = calcular_q_alt("protein.cif")
Como se indicó anteriormente, Q cubre las cuatro familias químicas principales (hidrófobas, polares, ácidas y básicas). Q_alt amplía el cálculo para incluir los aminoácidos especiales. La biblioteca está construida sobre Biopython y requiere Python ≥ 3.9. Este portátil Colab hace esto posible sin ninguna configuración local.
El estudio también ha sido aceptado y fusionado en la plataforma bioinformática Galaxy Europe, dentro de su sección Proteomics. Allí, los usuarios pueden cargar cualquier archivo pdb o mmCIF, ejecutar el cálculo en el navegador y descargar los resultados Q, Q_alt y de imagen. El repositorio de imágenes también está registrado en FAIRsharing, lo que le otorga un registro persistente y citable (ver referencias).
Vale la pena hacer algunas advertencias. El análisis cubre únicamente estructuras de rayos X, que proporcionan la mayor calidad de resolución en comparación con otros métodos. Pero aún así, es necesario realizar más estudios para abordar las estructuras obtenidas mediante otras técnicas experimentales como la crio-EM o la RMN, o incluso estructuras 3D predichas computacionalmente. Por otro lado, aunque la señal matemática del patrón mosaico es clara, especialmente en el contexto de la biología, todavía existe una variación limitada del descriptor Q entre proteínas. Sigue siendo una cuestión abierta si esa pequeña variación es simplemente ruido estadístico o si realmente ha sido seleccionada en la evolución.
En última instancia, las herramientas desarrolladas están abiertas para que cualquiera pueda utilizarlas y ampliarlas. Quedan muchas preguntas, especialmente en relación con el papel biológico del patrón y cómo afecta las interacciones proteína-proteína y con otras biomoléculas. Esto es interesante porque la investigación en este campo podría eventualmente ayudar en el diseño de fármacos basados en proteínas o fármacos dirigidos a proteínas. Si el patrón le parece interesante o cree que se le pueden ocurrir excepciones, las herramientas anteriores son un buen lugar para comenzar.
Referencias
[1]FAIRsharing.org, Repositorio del proyecto Proteins Mosaic Q (2026), DOI: 10.25504/FAIRsharing.9f9f9c
[2]HM Berman et al., The Protein Data Bank (2000), Nucleic Acids Research 28(1):235–242
[3]PJA Cock et al., Biopython: herramientas Python disponibles gratuitamente para biología molecular computacional y bioinformática (2009), Bioinformatics 25(11):1422–1423
[4]Galaxy Europe, herramienta Protein Mosaic Q (2026), usegalaxy.eu
[5]Equipo de desarrollo de Jmol, Jmol: un visor Java de código abierto para estructuras químicas en 3D (2024), jmol.org
La biblioteca y el código fuente se publican bajo la licencia MIT.