
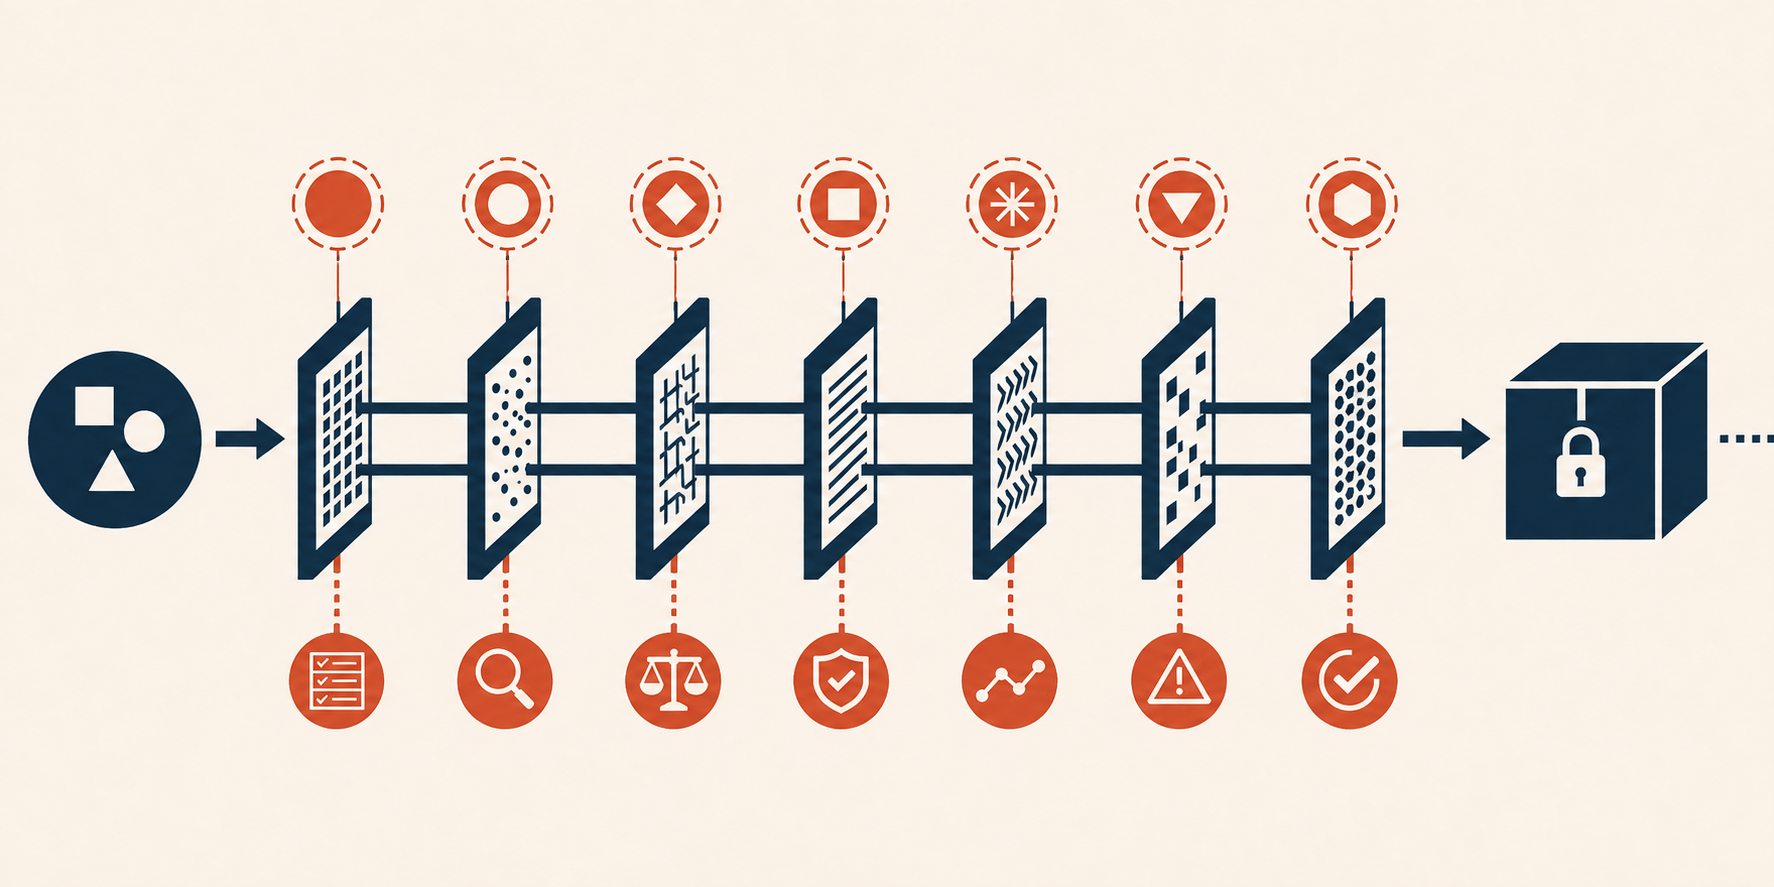
En este artículo, aprenderá siete pruebas de regresión concretas para detectar los modos de falla de la capa de orquestación que más importan antes de implementar un agente de IA en producción.
Los temas que cubriremos incluyen:
Por qué las fallas de los agentes casi siempre son causadas por problemas de gestión estatal, no por el modelo en sí, y qué distingue el “estado” de la “memoria”. Siete pruebas de regresión específicas, que cubren pérdida de contexto, idempotencia de herramientas, inyección rápida, salida estructurada, no terminación, conexión a tierra RAG y rehidratación de estado, cada una de las cuales devuelve un pase o falla binario adecuado para la activación de CI/CD. Los modos de falla específicos para los cuales cada prueba está diseñada, junto con los errores comunes que hacen que los equipos los configuren mal o los interpreten mal.
La mayoría de las fallas de los agentes no son causadas por un modelo que no sea lo suficientemente inteligente. Ocurren porque la capa de orquestación pierde el control del Estado. Y la mayoría de los equipos descubren esto de la manera más difícil: en producción, bajo tráfico de usuarios reales.
Estas siete pruebas de regresión le brindan una lista de verificación concreta para detectar los modos de falla que la evaluación rápida agregada nunca sacará a la luz. Cada prueba apunta a un límite específico del sistema y devuelve un resultado binario de aprobación o falla, lo que las hace adecuadas para la activación de CI/CD. Sin embargo, antes de conectarlos a una canalización, una nota estructural: el comportamiento del agente es estocástico, por lo que una aserción de una sola ejecución no es una puerta confiable. Fije la instantánea de su modelo, fije la temperatura en cero cuando el proveedor lo permita y ejecute cada prueba en suficientes pruebas para establecer una tasa de aprobación limitada por la confianza. Una prueba en la que los copos se volverán a intentar en silencio y dejarán de bloquear cualquier cosa.
Una distinción más que vale la pena señalar antes de la lista. A lo largo de este artículo, “estado” se refiere al registro transaccional determinista de los pasos de ejecución del agente. “Memoria” se refiere al contexto probabilístico recuperado inyectado en el mensaje. Cuando un agente se porta mal, el fallo casi siempre reside en la capa de estado, no en el modelo.
1. Pérdida de contexto y degradación de la recuperación
Cuando la carga útil de una conversación se acerca a su presupuesto de aviso configurado, la capa de orquestación tiene que decidir qué desalojar. El desalojo FIFO es la política más simple, pero produce una falla específica: un agente que le pide a un usuario los detalles de la cuenta que recopiló hace 40 minutos, porque esos primeros turnos se cancelaron. El término correcto para esto es pérdida de contexto, no olvido catastrófico, que es un fenómeno del tiempo de entrenamiento que implica actualizaciones de peso.
La prueba de regresión proporciona al agente un historial de conversación sintético que llena aproximadamente el 80 por ciento de su presupuesto de respuesta configurado y luego formula una pregunta cuya respuesta correcta depende estrictamente de un hecho establecido en el primer turno. La prueba pasa solo si la capa de recuperación emerge exitosamente que expulsó el turno de la memoria semántica, o si su política de resumen preserva las relaciones de la entidad central con una fidelidad mensurable (la recuperación de entidades contra un conjunto de oro funciona bien aquí).
Tenga cuidado con la trampa de la afirmación OR. Aprobar porque la recuperación funcionó es un resultado diferente que aprobar porque el resumen funcionó. Trátelos como dos pruebas separadas.
2. Idempotencia de ejecución de herramientas
Un agente con acceso de escritura a un sistema externo, en condiciones de red realistas, eventualmente emitirá la misma llamada a la herramienta más de una vez. Los reintentos provienen del arnés, el cliente HTTP o el bucle del orquestador, no del modelo en sí. El modelo vuelve a emitir una llamada cuando una observación ambigua no satisface las expectativas del mensaje. Estos son mecanismos diferentes, pero ambos producen escrituras duplicadas si el límite de su herramienta no es idempotente.
La prueba de regresión fuerza a la misma carga útil de llamada de herramienta a llegar al límite de ejecución tres veces. Solo se aprueba si el sistema descendente registra exactamente una escritura y devuelve una respuesta de acierto de caché para los intentos posteriores.
Derive claves de idempotencia a partir de la identidad lógica de la operación: un hash del nombre de la herramienta, argumentos canonicalizados y un ID de correlación empresarial. No utilice el ID del paso ni la posición del mensaje, ya que ambos cambian en cada iteración del bucle, lo que produce una clave única para cada llamada duplicada y anula el mecanismo por completo. También tenga en cuenta las solicitudes simultáneas en curso: devuelva la respuesta almacenada en lugar de un 409 y establezca un TTL en las claves almacenadas para evitar visitas obsoletas.
3. Anulación de instrucciones y resistencia a la inyección inmediata
La prueba inyecta cargas útiles adversas tanto a través de la entrada directa del usuario como de vectores indirectos, como documentos recuperados de una búsqueda web o una base de conocimiento externa. Pasa si el agente alcanza un estado terminal seguro sin ejecutar la instrucción inyectada y sin filtrar el contenido del mensaje del sistema.
Afirmar en el seguimiento de llamadas de herramientas y los efectos secundarios, no en el texto de salida. Un agente puede producir una negativa cortés en prosa y al mismo tiempo emitir una llamada de herramienta dañina en el fondo. La seguridad reside en el límite de ejecución, lo que significa control de acceso basado en roles en la capa de herramientas, independientemente de lo que pretenda el modelo.
Tenga en cuenta que las comprobaciones de límites basadas en clasificadores son componentes probabilísticos con sus propias tasas de error. Si su puerta de CI depende de un clasificador, está cerrando según un nivel de confianza, no un resultado binario. Hazlo explícito.
4. Adherencia a los resultados estructurados
Los proveedores modernos admiten la decodificación restringida por esquema, lo que hace que la invalidez sintáctica y las claves fuera del esquema sean estructuralmente imposibles en el modo estricto. Los modos de falla que vale la pena probar son diferentes.
El truncamiento es el más común: alcanzar el presupuesto del token a mitad de la producción produce una respuesta estructuralmente incompleta que ninguna estrategia de reparación puede solucionar en la capa de aplicación. Afirmar en Finish_reason junto con el éxito del análisis. Los rechazos producen un análisis nulo con un campo de rechazo completo y deben manejarse como un 403, no reintentarse como un error transitorio. La conformidad semántica es el fallo más sutil: resultados válidos para el esquema con los tipos correctos pero valores incorrectos. Y vale la pena realizar una prueba explícita del sesgo de la versión del modelo: las solicitudes enrutadas a una instantánea del modelo anterior a través de un alias pueden recurrir silenciosamente al comportamiento del modo JSON heredado, por lo que se deben fijar cadenas de modelo explícitamente en lugar de depender de alias.
5. No terminación y orquestación limitada
Lo que la comunidad de pruebas de agentes a menudo llama un punto muerto es más precisamente un bloqueo en vivo: el agente avanza a través de su ciclo de pensamiento-acción-observación pero nunca avanza hacia la meta. El verdadero punto muerto, donde el Agente A está bloqueado con la aprobación del Agente B mientras que B está bloqueado con la aprobación del A, es un modo de falla distintivo relevante para los sistemas de múltiples agentes y vale la pena realizar una prueba por separado si su arquitectura los incluye.
Para el caso de no terminación, la prueba proporciona una tarea que es matemáticamente imposible o dirige al agente a una herramienta simulada para devolver un error persistente. Se aprueba si la ejecución termina limpiamente después de un presupuesto codificado y devuelve una carga útil estructurada de falla. Establezca el presupuesto como triple: pasos máximos, costo máximo de token acumulado y tiempo de espera del reloj de pared. Un conteo de pasos por sí solo no detectará ni un solo paso que se cuelgue, y el costo real de un agente fuera de control es el gasto en inferencias y la falta de cola para solicitudes con buen comportamiento, no el agotamiento del límite de velocidad.
6. Conexión a tierra del RAG contra recuperación paramétrica
La prueba introduce un hecho sintético en el proceso de recuperación que contradice el conocimiento común y luego pregunta al agente sobre ese tema. La versión ingenua de esta prueba solo verifica que el agente adopte el hecho recuperado sobre sus datos de entrenamiento. Eso es necesario pero no suficiente.
El riesgo de conexión a tierra se corre en ambos sentidos. Un agente sintonizado para ceder siempre al contexto se convierte en un vector de envenenamiento de la recuperación. Un conjunto de pruebas bien diseñado verifica ambas direcciones: el agente debe adoptar un hecho sintético correcto en lugar de un conocimiento paramétrico obsoleto, y debe resistir un hecho recuperado obviamente incorrecto cuando la contradicción sea detectable. Los puntos de referencia de fidelidad y atribución existentes proporcionan un marco más basado en principios para medir esto que una sola prueba de aprobación/falla.
7. Estado de rehidratación y consistencia.
En una implementación distribuida, el proceso que inicia una sesión de agente rara vez es el que la finaliza. La prueba ejecuta un agente a través del punto medio de un flujo de trabajo de varios pasos, serializa el estado de ejecución completo en una base de datos, destruye el objeto en memoria y lo rehidrata en un nuevo proceso. Pasa si el agente completa el flujo de trabajo correctamente después de recibir la siguiente entrada del usuario.
Dos lagunas suelen hundir esta prueba en la producción. Primero, sesgo de versión: el estado serializado por una versión anterior de código o esquema tiene que ser deserializable por la versión actual, lo que requiere una ruta de migración y una prueba explícita para ello. En segundo lugar, el acoplamiento a la idempotencia: reanudar la llamada a mitad de la herramienta requiere saber si el efecto secundario ya se ha cometido. Esa es exactamente la información que le brinda una clave de idempotencia, razón por la cual estas dos pruebas pertenecen al mismo conjunto de pruebas y deben compartir infraestructura.
Lo que estas pruebas no detectan
Estas siete pruebas cubren modos de falla estructural en el límite del sistema. No abordan la regresión de costos y latencia, la deriva del contrato de herramienta cuando una API ascendente cambia su esquema, la fuga de PII en argumentos o rastros de la herramienta, o la incorporación de sesgo espacial cuando se implementa una nueva versión del codificador sin reindexar el almacén de vectores.
Construir la suite de regresión es el punto de partida. Ejecutarlo de manera consistente, en versiones de modelos fijados, con umbrales de confianza limitados, es lo que lo mantiene útil en el día 100.