
Vision Language Model (VLM) es un sistema avanzado de inteligencia artificial que combina la comprensión del lenguaje natural con capacidades de reconocimiento de imágenes. Al igual que CLIP de OpenAI y BigGAN de Google, los VLM pueden comprender descripciones textuales e interpretar imágenes, lo que permite diversas aplicaciones en campos como la visión por computadora, la generación de contenido y la interacción persona-computadora. Han demostrado capacidades impresionantes para comprender y generar texto en contexto con contenido visual, lo que los convierte en una tecnología fundamental en el panorama de la IA.
Investigadores de Google Research, Google DeepMind y Google Cloud contrastan los modelos Vision Transformer (ViT) previamente entrenados con clasificación versus objetivos contrastivos, con modelos contrastantes preentrenados, particularmente PaLI basado en SigLIP, que superan en tareas multimodales, en particular localización y comprensión de texto. Los investigadores ampliaron el codificador de imágenes SigLIP a 2 mil millones de parámetros, logrando una nueva recuperación multimodal multilingüe de última generación. Su estudio aboga por el entrenamiento previo de codificadores visuales con datos de texto de imagen a escala web en lugar de datos de estilo de clasificación. Su enfoque revela los beneficios de ampliar los codificadores de imágenes previamente entrenados para la clasificación, como lo demuestra PaLI-X en grandes modelos de lenguaje de visión.
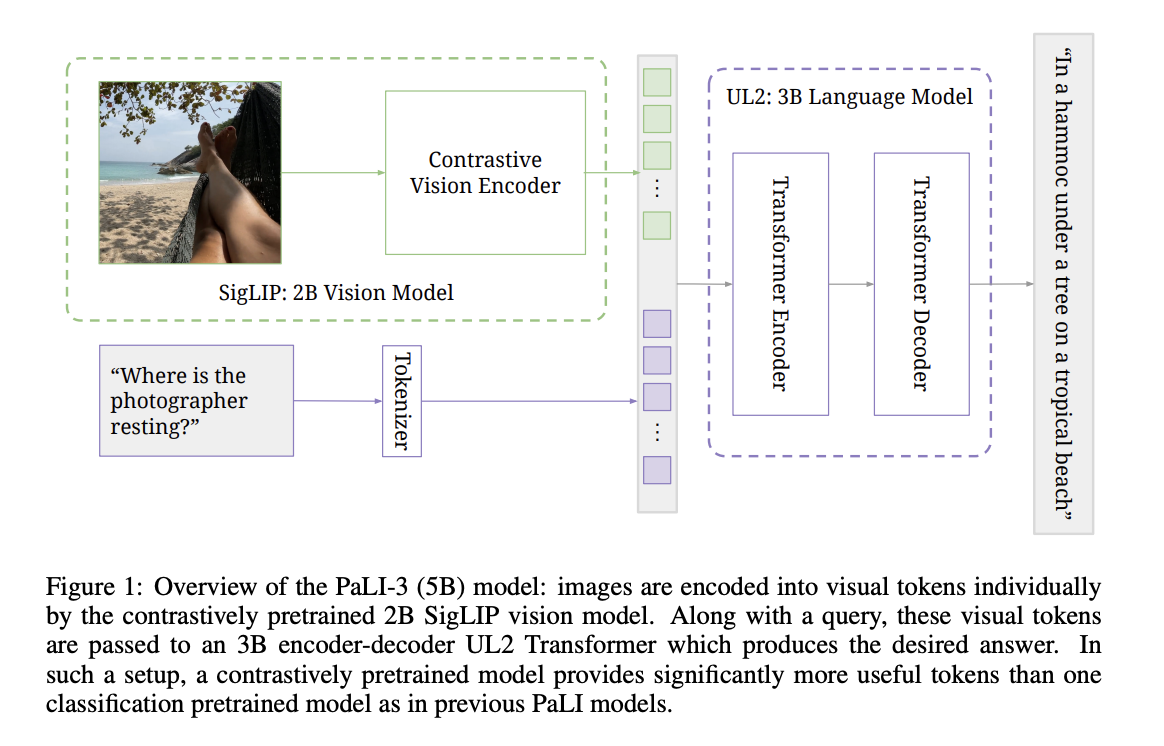
Su estudio profundiza en la ampliación de VLM y al mismo tiempo subraya la importancia de los modelos de menor escala para la practicidad y la investigación eficiente. Presenta PaLI-3, un VLM de 5 mil millones de parámetros con resultados competitivos. El proceso de entrenamiento de PaLI-3 implica un entrenamiento previo contrastivo del codificador de imágenes en datos a escala web, una mezcla mejorada de conjuntos de datos y un entrenamiento de mayor resolución. Se presenta un modelo de visión contrastiva multilingüe de 2 mil millones de parámetros. Los estudios de ablación confirman la superioridad de los modelos contrastivos previamente entrenados, especialmente en tareas relacionadas con la localización y la comprensión de textos situados visualmente.
Su enfoque emplea un modelo ViT previamente entrenado como codificador de imágenes, específicamente ViT-G14, utilizando la receta de entrenamiento SigLIP. ViT-G14 tiene alrededor de 2 mil millones de parámetros y sirve como columna vertebral de visión para PaLI-3. El preentrenamiento contrastivo implica incrustar imágenes y textos por separado y clasificar su correspondencia. Los tokens visuales de la salida de ViT se proyectan y combinan con tokens de texto. Luego, estas entradas se procesan mediante un modelo de lenguaje codificador-decodificador UL2 de 3 mil millones de parámetros para la generación de texto, generalmente impulsado por indicaciones específicas de tareas, como preguntas VQA.
PaLI-3 sobresale en comparación con sus homólogos más grandes, particularmente en localización y comprensión de textos situados visualmente. El modelo PaLI basado en SigLIP, con preentrenamiento del codificador de imágenes contrastantes, establece una nueva recuperación multimodal multilingüe de última generación. El modelo PaLI-3 completo supera al estado del arte en la segmentación de expresiones de referencia y mantiene bajas tasas de error en todos los subgrupos en las tareas de detección. El preentrenamiento contrastivo resulta más eficaz para las tareas de localización. El codificador de imágenes ViT-G de PaLI-3 sobresale en múltiples tareas de clasificación y recuperación intermodal.
En conclusión, su investigación enfatiza los beneficios del preentrenamiento contrastivo, ejemplificado por el enfoque SigLIP, para VLM mejorados y eficientes. El modelo PaLI-3 más pequeño, basado en SigLIP, de 5 mil millones de parámetros, sobresale en localización y comprensión de texto, superando a sus contrapartes más grandes en diversos puntos de referencia multimodales. El preentrenamiento contrastivo del codificador de imágenes en PaLI-3 también logra una nueva recuperación multimodal multilingüe de última generación. Su estudio subraya la necesidad de realizar investigaciones exhaustivas sobre diversos aspectos del entrenamiento de VLM más allá del entrenamiento previo del codificador de imágenes para mejorar aún más el rendimiento del modelo.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 31k+ ML, Comunidad de Facebook de más de 40.000 personas, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
También estamos en WhatsApp. Únase a nuestro canal de IA en Whatsapp.
A Sana Hassan, pasante de consultoría en Marktechpost y estudiante de doble titulación en IIT Madras, le apasiona aplicar la tecnología y la inteligencia artificial para abordar los desafíos del mundo real. Con un gran interés en resolver problemas prácticos, aporta una nueva perspectiva a la intersección de la IA y las soluciones de la vida real.