
En visión, Segment Anything Model (SAM) ha logrado un éxito notable, logrando resultados de vanguardia en numerosas tareas de segmentación de imágenes, incluida la generación de propuestas de objetos de disparo cero, la segmentación de instancias de disparo cero y la detección de bordes, entre otros usos prácticos.
El conjunto de datos visuales SA-1B, que contiene más de mil millones de máscaras de once millones de fotografías, es la base del modelo Vision Transformer (ViT) de SAM. Esto permite la segmentación de cualquier elemento en una imagen determinada. Debido a su capacidad Segment Anything, SAM no es sólo un modelo básico en visión, sino que sus usos también se extienden fuera de la visión.
A pesar de estos beneficios, el costo prohibitivo de la arquitectura SAM (particularmente el codificador de imágenes, como ViT-H) hace que el modelo SAM sea un impedimento para la adopción práctica en términos de eficiencia.
En respuesta a esta dificultad, varias publicaciones recientes han ofrecido soluciones que reducen la carga financiera del uso de SAM para la segmentación de instancias basada en indicaciones.
Según investigaciones anteriores, un pequeño codificador de imágenes ViT podría, por ejemplo, beneficiarse de la experiencia del codificador de imágenes ViT-H predeterminado. Un diseño basado en CNN en tiempo real puede reducir los costos informáticos para la actividad de Segment Anything. Aquí se sugiere un codificador de imágenes ViT liviano y bien capacitado, como ViT-Tiny/-Small, para simplificar SAM sin sacrificar el rendimiento.
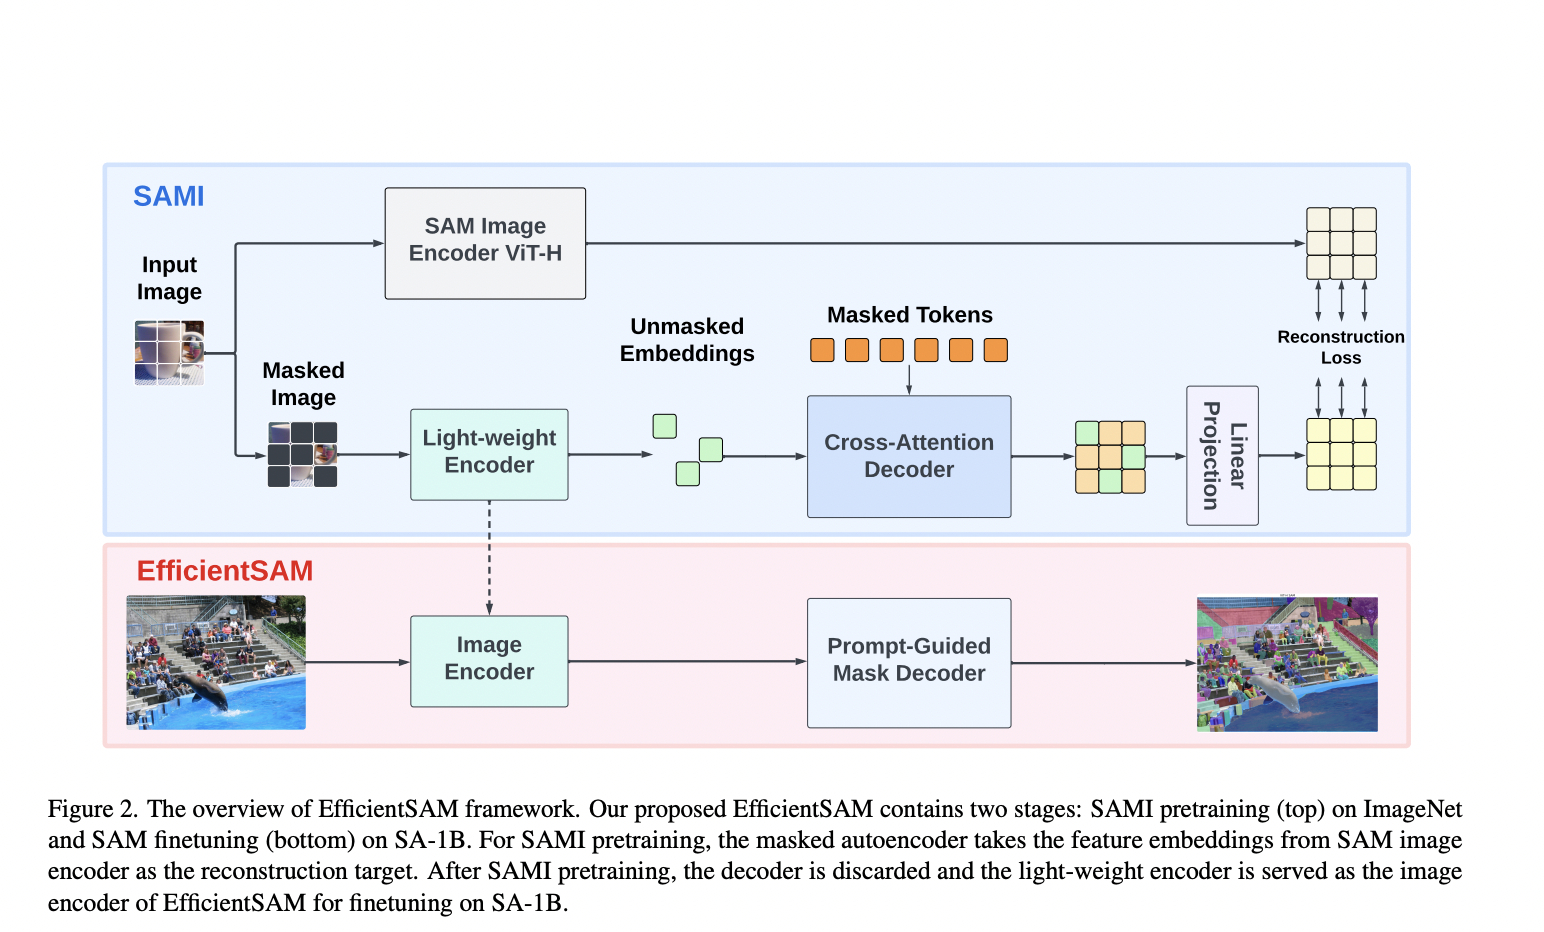
Una nueva investigación de Meta AI crea columnas vertebrales de ViT livianas y previamente entrenadas para cada tarea utilizando nuestra tecnología, SAM (SAMI). Para hacer esto, los investigadores establecen codificadores ViT previamente entrenados de alta calidad utilizando el reconocido método de preentrenamiento MAE con el modelo SAM.
Para ser más precisos, el SAMI propuesto entrena un modelo de imagen enmascarado utilizando codificadores livianos para reconstruir características de ViT-H de SAM en lugar de parches de imágenes, y utiliza el codificador SAM, ViT-H, para proporcionar incrustación de características. Esto produce redes troncales ViT genéricas que se pueden utilizar para operaciones posteriores como categorización de imágenes, identificación de objetos y segmentación. Luego, los codificadores livianos previamente entrenados se ajustaron para el segmento y cualquier tarea utilizando decodificadores SAM.
Los equipos también proporcionan EfficientSAM, modelos SAM livianos con compensaciones de calidad y eficiencia de vanguardia para su implementación en el mundo real.
El equipo preentrenó los modelos en ImageNet con una pérdida reconstructiva utilizando una resolución de imagen de 224 × 224 y luego los ajustó en tareas específicas utilizando datos supervisados para evaluar su estrategia en un contexto de aprendizaje por transferencia para el preentrenamiento de imágenes enmascaradas. SAMI puede aprender codificadores ligeros y generalizables. Los modelos entrenados en ImageNet-1K utilizando el preentrenamiento SAMI obtienen mejores resultados en cuanto a generalización, como ViT-Tiny/-Small/-Base. Cuando se ajusta en ImageNet-1K con 100 épocas, logra una precisión superior del 82,7% para un modelo ViT-Small, que es mejor que otras líneas base de preentrenamiento de imágenes de última generación. La detección de objetos, la segmentación de instancias y la segmentación semántica son áreas en las que el equipo perfecciona aún más sus modelos previamente entrenados.
En comparación con las líneas de base de preentrenamiento existentes, su estrategia los supera en estas tareas. Es más, incluso en los modelos pequeños se ven mejoras sustanciales. Además, el desafío Segment Anything se utiliza para evaluar nuestros modelos. El modelo supera a FastSAM y a los algoritmos SAM livianos actuales en la segmentación de instancias de disparo cero por 4.1AP/5.2 AP en COCO/LVIS.
Revisar la Papel y Proyecto. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 33k+ ML, 41k+ comunidad de Facebook, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
Dhanshree Shenwai es ingeniero en informática y tiene una buena experiencia en empresas de tecnología financiera que cubren el ámbito financiero, tarjetas y pagos y banca con un gran interés en las aplicaciones de IA. Le entusiasma explorar nuevas tecnologías y avances en el mundo en evolución de hoy que facilita la vida de todos.