
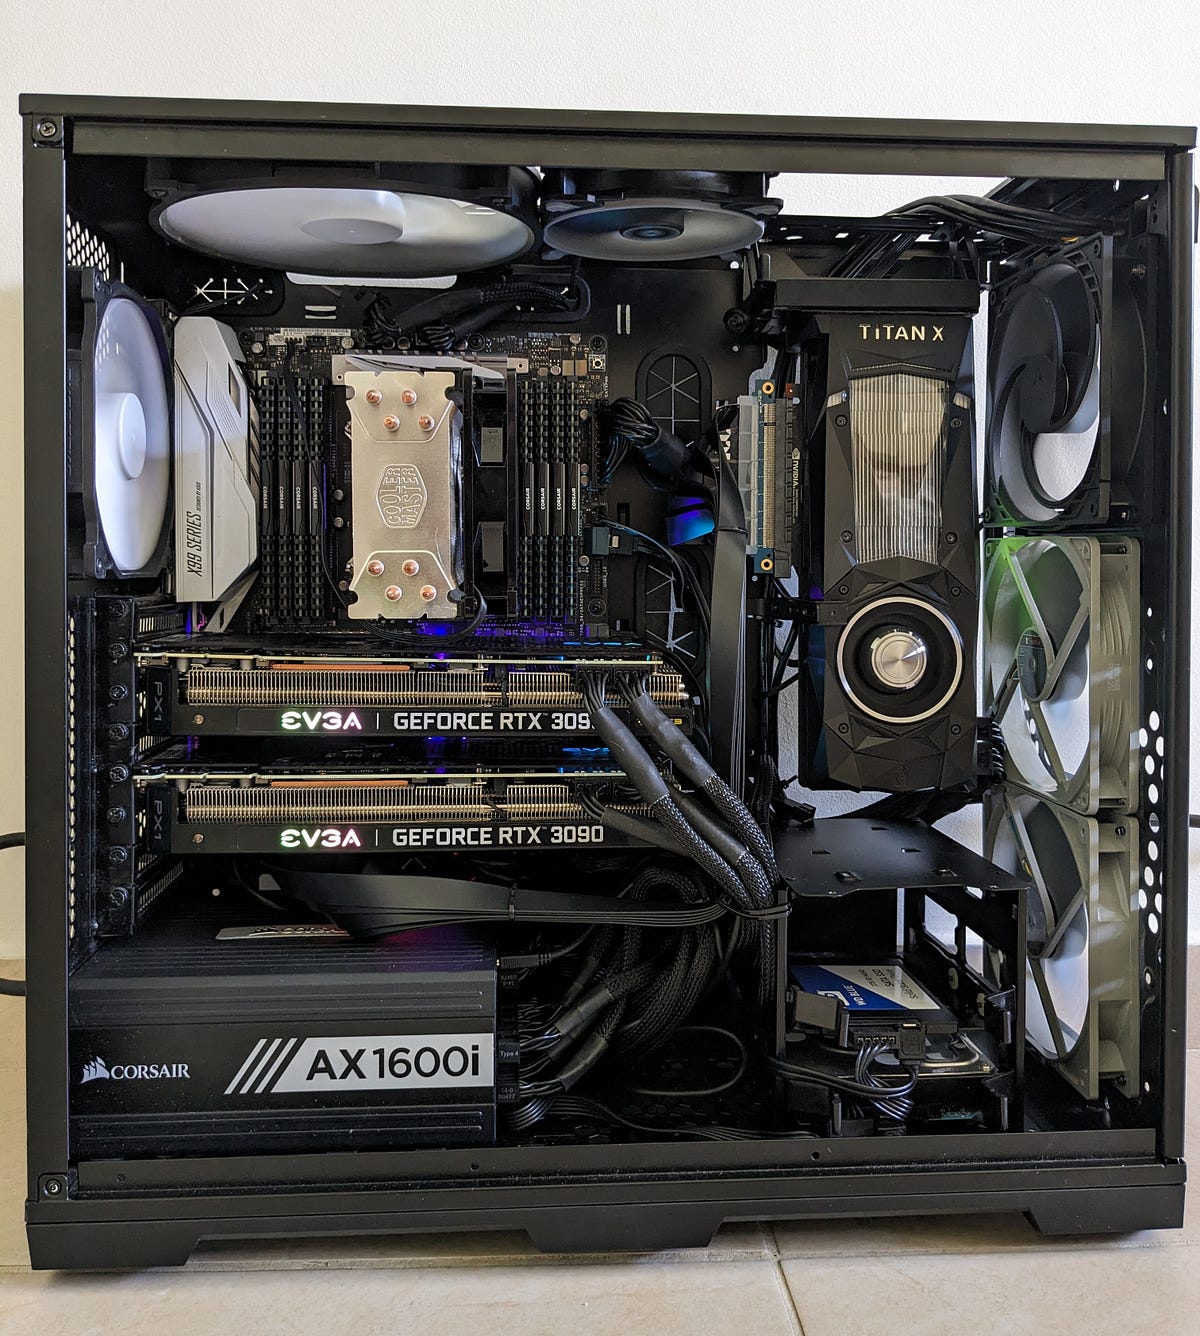

Esta historia proporciona una guía sobre cómo construir un sistema multi-GPU para el aprendizaje profundo y, con suerte, le ahorrará algo de tiempo de investigación y experimentación.
¡Construya un sistema multi-GPU para la capacitación de visión por computadora y modelos LLM sin tener que gastar mucho dinero! 🏦
¡Empecemos con la parte divertida (y cara 💸💸💸)!
Las principales consideraciones a la hora de comprar una GPU son:
- memoria (VRAM)
- rendimiento (núcleos tensoriales, velocidad de reloj)
- ancho de ranura
- potencia (TDP)
Memoria
Para las tareas de aprendizaje profundo hoy en día necesitamos mucha memoria. Los LLM son enormes incluso para realizar ajustes finos y las tareas de visión por computadora pueden consumir mucha memoria, especialmente con redes 3D. Naturalmente el aspecto más importante a buscar es la GPU. VRAM. Para LLM recomiendo al menos 24 GB de memoria y para tareas de visión por computadora no bajaría de 12 GB.
Actuación
El segundo criterio es el rendimiento que se puede estimar con FLOPS (Operaciones de punto flotante por segundo):
El número crucial en el pasado era el número de núcleos CUDA en el circuito. Sin embargo, con la aparición del aprendizaje profundo, NVIDIA ha introducido herramientas especializadas. núcleos tensores que puede realizar muchas más operaciones FMA (Fused Multiply-Add) por reloj. Estos ya están respaldados por los principales marcos de aprendizaje profundo y son lo que debes buscar en 2023.
A continuación puede encontrar una tabla de rendimiento bruto de las GPU agrupadas por memoria que compilé después de bastante trabajo manual:
Ten en cuenta que tienes que ser mucho cuidado al comparar el rendimiento de diferentes GPU. Los núcleos tensoriales de diferentes generaciones/arquitecturas no son comparables. Por ejemplo, el A100 realiza 256 operaciones/reloj de FP16 FMA, mientras que el V100 “sólo” 64. Además, las arquitecturas más antiguas (Turing, Volta) no admiten operaciones de tensor de 32 bits. Lo que hace que la comparación sea más difícil es que NVIDIA no siempre informa el FMA, ni siquiera en los documentos técnicos, y las GPU de la misma arquitectura pueden tener diferentes FMA. Seguía golpeándome la cabeza con este 😵💫. También tenga en cuenta que NVIDIA a menudo anuncia el tensor FLOPS con escasez, que es una característica que solo se puede utilizar en el momento de la inferencia.
Para identificar la mejor GPU con respecto al precio, recopilé los precios de eBay utilizando la API de eBay y calculé el rendimiento relativo por dólar (USD) para tarjetas nuevas:
Hice lo mismo con las tarjetas usadas, pero como las clasificaciones no cambian demasiado, omito la trama.
Para seleccionar la mejor GPU para su presupuesto, puede elegir una de las mejores GPU con la mayor memoria que pueda permitirse. Mi recomendación sería:
Si desea profundizar en aspectos más técnicos, le recomiendo leer la excelente guía de Tim Dettmers sobre Qué GPU(s) adquirir para el aprendizaje profundo.
Ancho de ranura
Al construir un sistema multi-GPU, debemos planificar cómo encajar físicamente las GPU en la carcasa de una PC. Dado que las GPU crecen cada vez más, especialmente las series de juegos, esto se convierte en un problema mayor. Las placas base de consumo tienen hasta 7 ranuras PCIe y las carcasas de PC se construyen en torno a esta configuración. Un 4090 puede ocupar fácilmente 4 ranuras según el fabricante, por lo que puede ver por qué esto se convierte en un problema. Además debemos dejar al menos 1 slot entre las GPU que no sean tipo soplador o refrigeradas por agua para evitar el sobrecalentamiento. Tenemos las siguientes opciones:
Refrigeración por agua
Las variantes refrigeradas por agua ocuparán hasta 2 ranuras, pero son más caras. Alternativamente, puedes convertir una GPU enfriada por aire, pero esto anulará la garantía. Si no obtiene soluciones todo en uno (AIO), deberá crear un circuito de refrigeración por agua personalizado. Esto también es cierto si desea instalar varias GPU refrigeradas por agua, ya que es posible que los radiadores AIO no quepan en la carcasa. Construir tu propio circuito es arriesgado y yo personalmente no lo haría con tarjetas caras. Solo compraría soluciones AIO directamente de los fabricantes (aversión al riesgo 🙈).
Tarjetas de 2 a 3 ranuras y tarjetas verticales PCIe refrigeradas por aire
En este escenario, se intercalan tarjetas en ranuras PCIe y tarjetas conectadas con cables verticales PCIe. Las tarjetas verticales PCIe se pueden colocar en algún lugar dentro de la carcasa de la PC o al aire libre. En cualquier caso, debes asegurarte de que las GPU estén aseguradas (consulta también la sección sobre carcasas de PC).
Potencia (TDP)
Las GPU modernas consumen cada vez más energía. Por ejemplo, un A 4090 requiere 450 W, mientras que un H100 puede obtener hasta 700 W. Aparte de la factura de energía, instalar tres o más GPU se convierte en un problema. Esto es especialmente cierto en los EE. UU., donde los enchufes pueden entregar hasta alrededor de 1800w.
Una solución a este problema si se está acercando a la potencia máxima que puede extraer de su fuente de alimentación/toma de corriente es limitar la potencia. Todo lo que necesitas para reducir la potencia máxima que puede consumir una GPU es:
sudo nvidia-smi -i <GPU_index> -pl <power_limit>where:
GPU_index: the index (number) of the card as it shown with nvidia-smi
power_limit: the power in W you want to use
Se ha demostrado que limitar la potencia entre un 10 % y un 20 % reduce el rendimiento en menos de un 5 % y mantiene las tarjetas más frías (experimento de Puget Systems). Limitar la energía de cuatro 3090, por ejemplo, en un 20%, reducirá su consumo a 1120w y puede caber fácilmente en una fuente de alimentación de 1600w / zócalo de 1800w (suponiendo 400w para el resto de los componentes).