
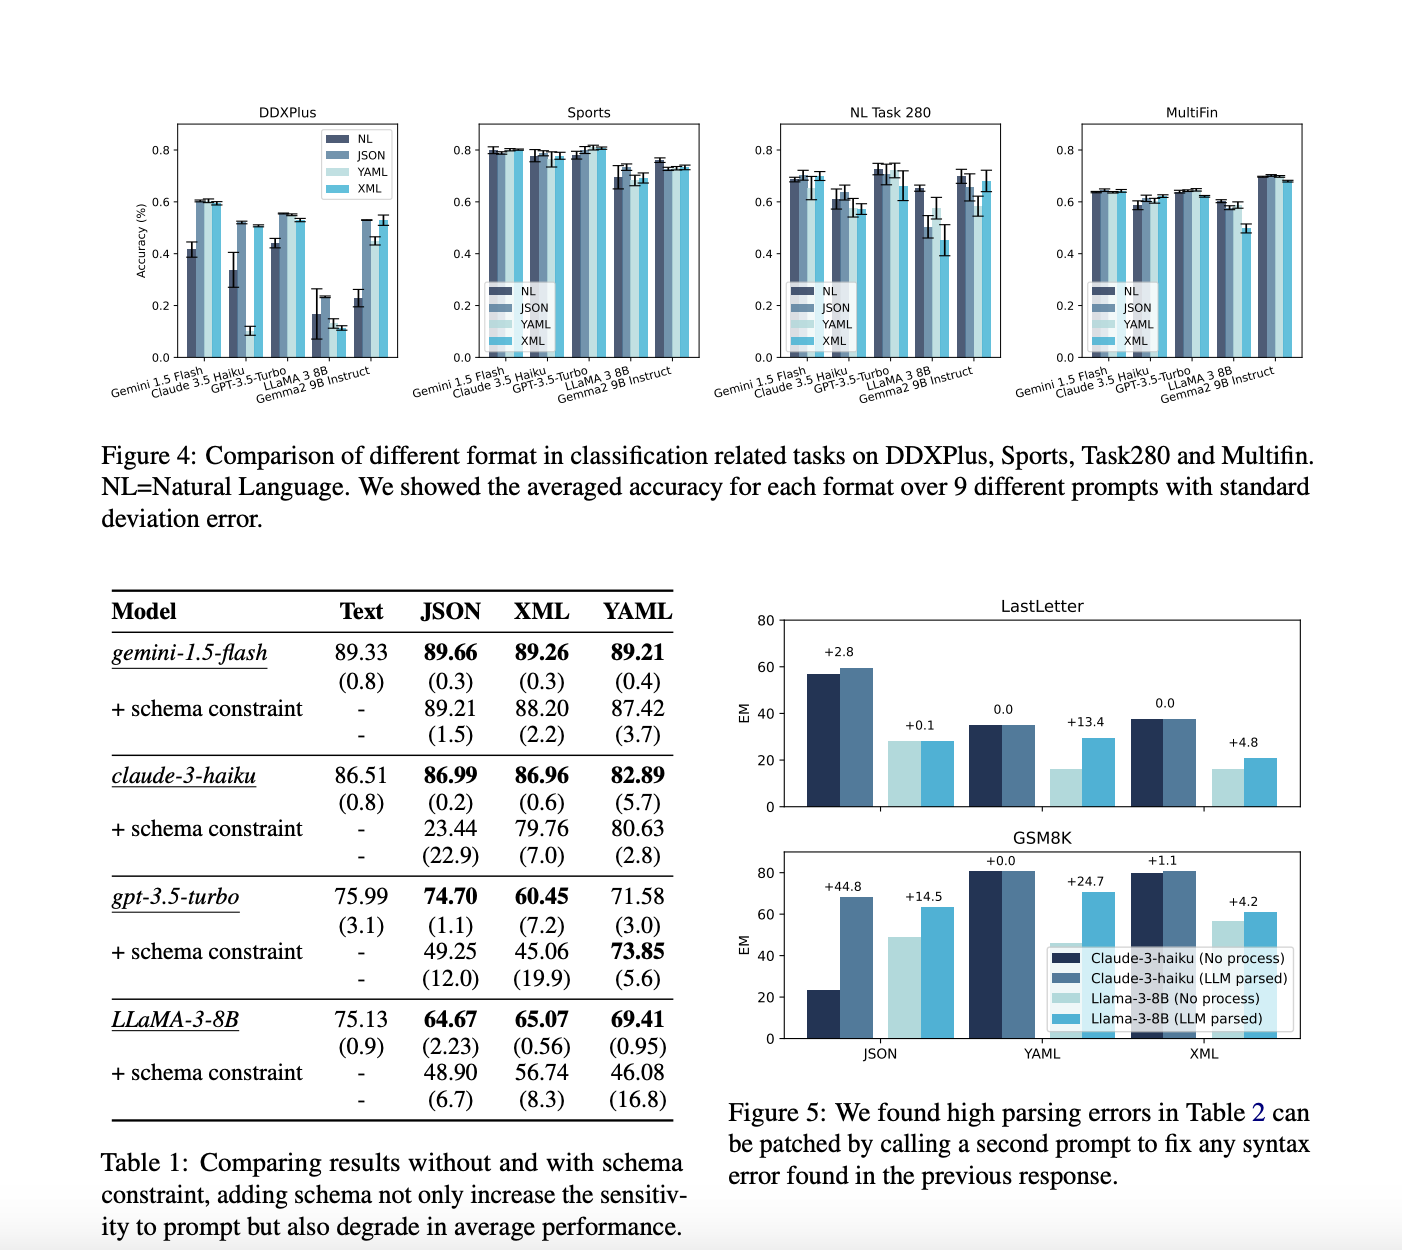
A medida que los LLM se han vuelto cada vez más capaces de realizar diversas tareas mediante el aprendizaje en pocos intentos y el seguimiento de instrucciones, sus formatos de salida inconsistentes han obstaculizado su confiabilidad y usabilidad en contextos industriales. Esta inconsistencia complica la extracción y evaluación del contenido generado, en particular cuando se emplean métodos de generación estructurados, como JSON y XML. Los autores investigan si imponer restricciones de formato a los LLM afecta negativamente sus habilidades de razonamiento y su desempeño general, en particular en tareas que requieren conocimiento y comprensión del dominio.
Los métodos actuales para la generación estructurada incluyen decodificación restringida, instrucciones de restricción de formato (FRI) y enfoques de lenguaje natural a formato (NL-to-Format). La decodificación restringida, a menudo implementada en modo JSON, limita el espacio de salida de los LLM para garantizar datos estructurados válidos, lo cual es esencial para muchas aplicaciones industriales. Las instrucciones de restricción de formato indican a los LLM que generen respuestas en formatos específicos, como requerir que una respuesta esté en un orden específico o que siga una estructura particular. El método NL-to-Format primero permite a los LLM responder en lenguaje natural antes de convertir la salida al formato deseado. Los autores proponen una investigación sistemática sobre estas metodologías, evaluando su impacto en el desempeño de los LLM en varias tareas, incluido el razonamiento y la clasificación.
La metodología propuesta por Appier AI Research y la Universidad Nacional de Taiwán implica experimentos empíricos extensos para evaluar los efectos de las restricciones de formato en el rendimiento de los LLM. Los investigadores comparan tres enfoques de incitación: modo JSON, FRI y NL-to-Format. Sus hallazgos revelan que las restricciones de formato más estrictas, como las impuestas por el modo JSON, conducen a disminuciones significativas en las capacidades de razonamiento. Por ejemplo, en tareas de razonamiento como GSM8K y Concatenación de la última letra, el rendimiento de los LLM es notablemente peor bajo restricciones de formato estrictas en comparación con enfoques más relajados. Los autores también destacan que el orden de las claves en los resultados estructurados y la separación del razonamiento de la adherencia al formato juegan un papel crucial en el mantenimiento de las capacidades de los LLM al tiempo que brindan respuestas estructuradas.
En términos de rendimiento, el estudio presenta evidencia convincente de que las restricciones de formato pueden afectar significativamente los resultados de LLM. Para las tareas de razonamiento, el enfoque en modo JSON a menudo da como resultado una precisión menor debido a su estructura rígida, que puede interrumpir el proceso de razonamiento del modelo. En contraste, el método NL-to-Format tiene un rendimiento comparable al de las respuestas en lenguaje natural sin restricciones, lo que sugiere que permitir que los LLM generen contenido libremente antes de formatear puede preservar sus capacidades de razonamiento. Curiosamente, los resultados difieren para las tareas de clasificación, donde el modo JSON a veces mejora el rendimiento al restringir el espacio de respuesta, lo que reduce los errores en la selección de respuestas. Esta variabilidad dependiente de la tarea subraya la necesidad de una consideración cuidadosa al implementar restricciones de formato en aplicaciones LLM, instando a la audiencia a ser cautelosa y consciente en su enfoque.
Una de las características más destacadas del método propuesto es su capacidad de escalar de manera efectiva. A diferencia de los modelos tradicionales que pueden fallar cuando se aplican a conjuntos de datos extensos, este enfoque mantiene su eficiencia y precisión independientemente del tamaño del conjunto de datos. Los investigadores realizaron una serie de pruebas rigurosas para evaluar el rendimiento de su método, comparándolo con las herramientas existentes. Los resultados demostraron una mejora significativa tanto en la velocidad como en la precisión, y el método propuesto superó a las técnicas tradicionales en varias métricas. Este rendimiento mejorado se atribuye al diseño innovador de la red neuronal y a la optimización meticulosa de los procesos analíticos, lo que proporciona una solución confiable para el análisis de datos. La optimización meticulosa de los procesos analíticos debería infundir confianza en la confiabilidad del método propuesto entre los investigadores y los profesionales.
En resumen, el artículo de investigación ofrece una descripción general completa de los desafíos asociados con el análisis de textos y datos y presenta una solución innovadora que aborda estos problemas. El método propuesto, con su arquitectura avanzada de aprendizaje profundo y procesos analíticos optimizados, no solo ofrece una alternativa prometedora a las herramientas tradicionales, sino que también tiene el potencial de revolucionar la forma en que abordamos el análisis de datos en diversos campos. Este artículo no solo contribuye al discurso académico sobre el análisis de datos, sino que también allana el camino para aplicaciones prácticas que pueden aprovechar estos avances para lograr resultados más precisos y eficientes.
La integración de modelos de aprendizaje profundo y marcos analíticos innovadores marca un avance significativo en el campo del análisis de textos y datos. A medida que los datos crecen en volumen y complejidad, métodos como el propuesto en esta investigación serán cruciales para garantizar que podamos seguir el ritmo de las demandas de procesamiento y extracción de información.
Echa un vistazo a la Papel. Todo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de Telegram y LinkedIn Gr¡Arriba!. Si te gusta nuestro trabajo, te encantará nuestro hoja informativa..
No olvides unirte a nuestro Subreddit de más de 48 000 millones de usuarios
Encuentra lo próximo Seminarios web sobre IA aquí

Shreya Maji es pasante de consultoría en MarktechPost. Estudió su licenciatura en el Instituto Indio de Tecnología (IIT) en Bhubaneswar. Es una entusiasta de la inteligencia artificial y le gusta mantenerse al día de los últimos avances. Shreya está particularmente interesada en las aplicaciones reales de la tecnología de vanguardia, especialmente en el campo de la ciencia de datos.
