
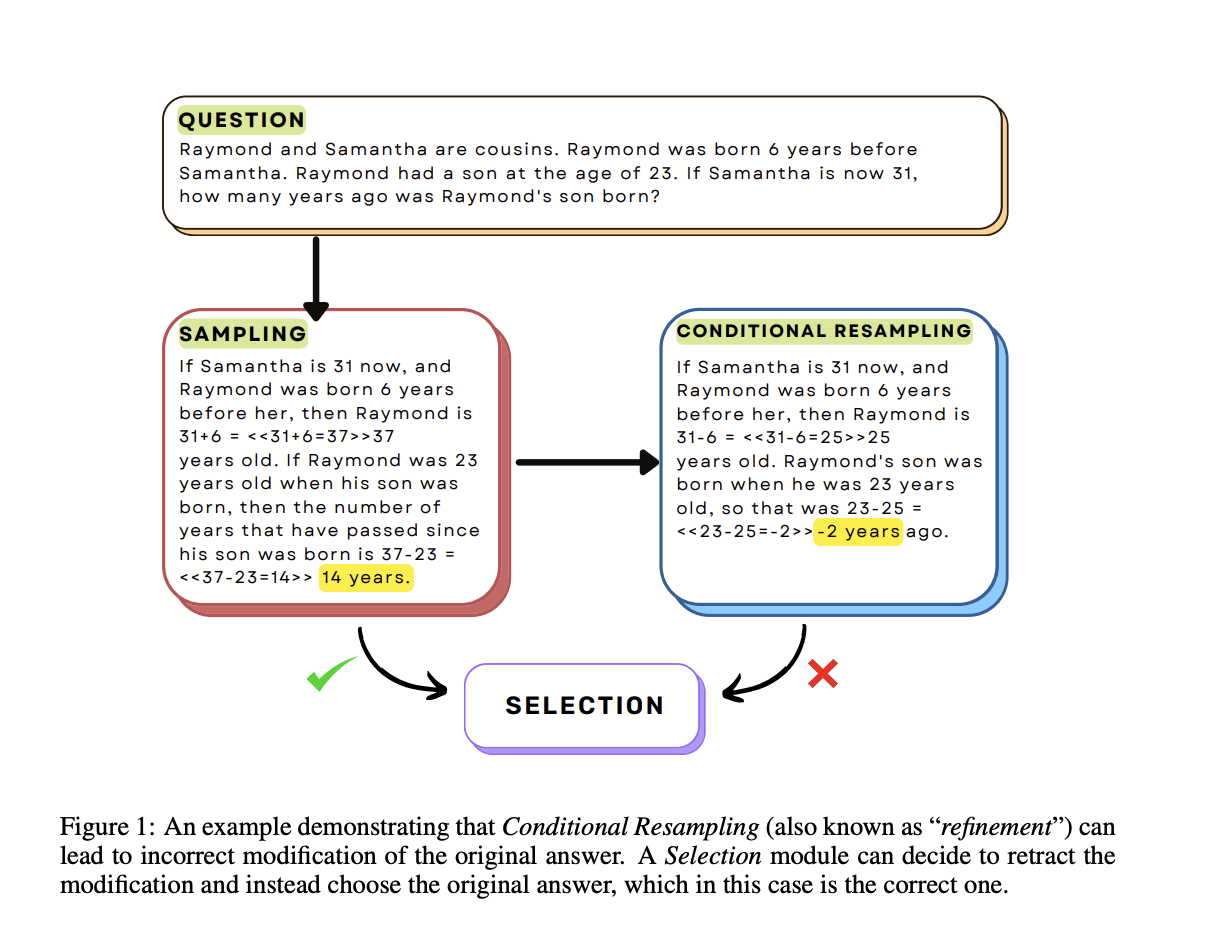
Los modelos de lenguajes grandes (LLM) han tenido éxito en varias tareas de razonamiento diferentes. Para garantizar que se cumpla el objetivo previsto, a veces es necesario ajustar iterativamente los resultados del LLM porque el resultado sólo ocasionalmente es preciso en el primer intento. Estas técnicas de refinamiento suponen que los resultados consecutivos (del mismo modelo, un modelo externo o alguna herramienta) dan como resultado un mejor rendimiento. Sin embargo, no hay garantía de que las versiones posteriores siempre sean mejores, como muestra la Figura 1; el refinamiento podría dar como resultado un falso positivo. Esto anima al modelo a elegir un resultado anterior utilizando la técnica de selección. Además, investigaciones anteriores sobre el refinamiento iterativo utilizan con frecuencia una técnica de razonamiento única y fija. Pero los humanos son más adaptables.
Figura 1: Un estudio de caso que ilustra cómo el remuestreo condicional (también conocido como “refinamiento”) puede resultar en una modificación inadecuada de la respuesta inicial. La respuesta original, que en este caso es la correcta, podrá ser elegida mediante un módulo de selección en lugar de la alteración.
Un gerente de producto puede utilizar una técnica de lluvia de ideas para generar varias ideas antes de cambiar a una técnica de priorización para clasificarlas según su viabilidad o efecto. De manera similar, un estudiante que se prepara para un examen podría utilizar el razonamiento deductivo para responder cuestiones y el razonamiento inductivo para confirmar los resultados. Por lo tanto, sugieren una estrategia modular para responder a mejoras, lo que nos permite probar varias tácticas. En este artículo, investigadores de ETH Zurich y Microsoft Semantic Machines presentan SCREWS, un marco modular para razonar sobre cambios. El muestreo, el remuestreo condicional y la selección son los tres componentes principales de la arquitectura que se presentan en detalle en la Figura 2. Crean instancias de SCREWS fijando los submódulos para cada módulo (por ejemplo, pueden elegir “Cadena de pensamiento” para el muestreo). Esto se hace para un trabajo específico y una secuencia de entrada.

Figura 2 presenta una imagen de alto nivel del sistema modular TORNILLOS para razonar sobre revisiones. Cada uno de los tres cuadros sustanciales (o “módulos”) contiene una serie de opciones (o “submódulos”). Muchos esfuerzos anteriores, incluidos Self-Refine, De menos a más, LLMs Know (Mayormente), Self-Consistency, Self-Improve, PHP CoT, Self-Correction, Socratic CoT, Program of Thoughts y muchos más, pueden verse como ejemplos. del marco. (…) denota subcomponentes adicionales que se pueden agregar a cada módulo, incluidos, entre otros, memoria caché o búsqueda en línea para el módulo de muestreo, un modelo ajustado o un verificador externo para remuestreo condicional y selección basada en humanos o un oráculo para el módulo de Selección.
Los primeros resultados del muestreo se pasan al remuestreo condicional, que determina si se crea una revisión basada en la muestra original y lo hace si es necesario. Luego, el módulo de Selección elige lo mejor de todas las muestras y revisiones. Dado el diseño modular de su marco, se pueden utilizar elementos de marco adicionales para mejorar varios enfoques de autorrefinamiento recientemente sugeridos. Un ejemplo es la combinación de su técnica de selección basada en modelos y su método de autorrefinamiento, que puede mejorar el rendimiento general. Utilizan ChatGPT o GPT-4 para evaluar SCREWS en diversas tareas de razonamiento, incluida la respuesta a preguntas de múltiples saltos, el razonamiento aritmético y la depuración de código.
En comparación con los procedimientos estándar de muestreo y remuestreo, las soluciones sugeridas producen mejoras significativas (10-15%). Muestran el valor del remuestreo heterogéneo, mostrando cómo puede influir en la lógica del modelo y mejorar sustancialmente las líneas de base a un costo total muy bajo. También explican la importancia de un enfoque de selección basado en modelos, un elemento crucial de los LLM contemporáneos que permite que el modelo vuelva a resultados anteriores y más seguros.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 31k+ ML, Comunidad de Facebook de más de 40.000 personas, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.

Aneesh Tickoo es pasante de consultoría en MarktechPost. Actualmente está cursando su licenciatura en Ciencia de Datos e Inteligencia Artificial en el Instituto Indio de Tecnología (IIT), Bhilai. Pasa la mayor parte de su tiempo trabajando en proyectos destinados a aprovechar el poder del aprendizaje automático. Su interés de investigación es el procesamiento de imágenes y le apasiona crear soluciones en torno a él. Le encanta conectarse con personas y colaborar en proyectos interesantes.