
Explorando posibles casos de uso de Phi-3-Vision, un MLLM pequeño pero potente que se puede ejecutar localmente (con ejemplos de código)

Microsoft lanzó recientemente Phi-3, un potente modelo de lenguaje, con una nueva variante Vision-Language llamada Phi-3-vision-128k-instruct. Este modelo de parámetros 4B logró resultados impresionantes en puntos de referencia públicos, incluso superando al GPT-4V en algunos casos y superando al Gemini 1.0 Pro V en todos menos en MMMU.
Esta publicación de blog explorará cómo puede utilizar Phi-3-vision-128k-instruct como un modelo de texto y visión sólido en su conjunto de herramientas de ciencia de datos. Demostraremos sus capacidades a través de varios casos de uso, que incluyen:
- Reconocimiento óptico de caracteres (OCR)
- Subtítulos de imágenes
- Análisis de tablas
- Comprensión de la figura
- Comprensión lectora en documentos escaneados
- Solicitud de conjunto de marcas
Comenzaremos proporcionando un fragmento de código simple para ejecutar este modelo localmente usando transformadores y bitsandbytes. Luego, mostraremos un ejemplo para cada uno de los casos de uso enumerados anteriormente.
Ejecutando el modelo localmente:
Cree un entorno Conda Python e instale torch y otras dependencias de Python:
conda install pytorch torchvision torchaudio pytorch-cuda=12.1 -c pytorch -c nvidia
pip install git+https://github.com/huggingface/transformers.git@60bb571e993b7d73257fb64044726b569fef9403 pillow==10.3.0 chardet==5.2.0 flash_attn==2.5.8 accelerate==0.30.1 bitsandbytes==0.43.1
Luego, podemos ejecutar este script:
# Example inspired from https://huggingface.co/microsoft/Phi-3-vision-128k-instruct# Import necessary libraries
from PIL import Image
import requests
from transformers import AutoModelForCausalLM
from transformers import AutoProcessor
from transformers import BitsAndBytesConfig
import torch
# Define model ID
model_id = "microsoft/Phi-3-vision-128k-instruct"
# Load processor
processor = AutoProcessor.from_pretrained(model_id, trust_remote_code=True)
# Define BitsAndBytes configuration for 4-bit quantization
nf4_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_quant_type="nf4",
bnb_4bit_use_double_quant=True,
bnb_4bit_compute_dtype=torch.bfloat16,
)
# Load model with 4-bit quantization and map to CUDA
model = AutoModelForCausalLM.from_pretrained(
model_id,
device_map="cuda",
trust_remote_code=True,
torch_dtype="auto",
quantization_config=nf4_config,
)
# Define initial chat message with image placeholder
messages = [{"role": "user", "content": "<|image_1|>\nWhat is shown in this image?"}]
# Download image from URL
url = "https://images.unsplash.com/photo-1528834342297-fdefb9a5a92b?ixlib=rb-4.0.3&q=85&fm=jpg&crop=entropy&cs=srgb&dl=roonz-nl-vjDbHCjHlEY-unsplash.jpg&w=640"
image = Image.open(requests.get(url, stream=True).raw)
# Prepare prompt with image token
prompt = processor.tokenizer.apply_chat_template(
messages, tokenize=False, add_generation_prompt=True
)
# Process prompt and image for model input
inputs = processor(prompt, [image], return_tensors="pt").to("cuda:0")
# Generate text response using model
generate_ids = model.generate(
**inputs,
eos_token_id=processor.tokenizer.eos_token_id,
max_new_tokens=500,
do_sample=False,
)
# Remove input tokens from generated response
generate_ids = generate_ids[:, inputs["input_ids"].shape[1] :]
# Decode generated IDs to text
response = processor.batch_decode(
generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False
)[0]
# Print the generated response
print(response)
Este código cargará el modelo Phi-3 como lo haríamos con cualquier transfomersmodelo. Añadimos bitsandbytes para que quepa en una memoria GPU de consumo.
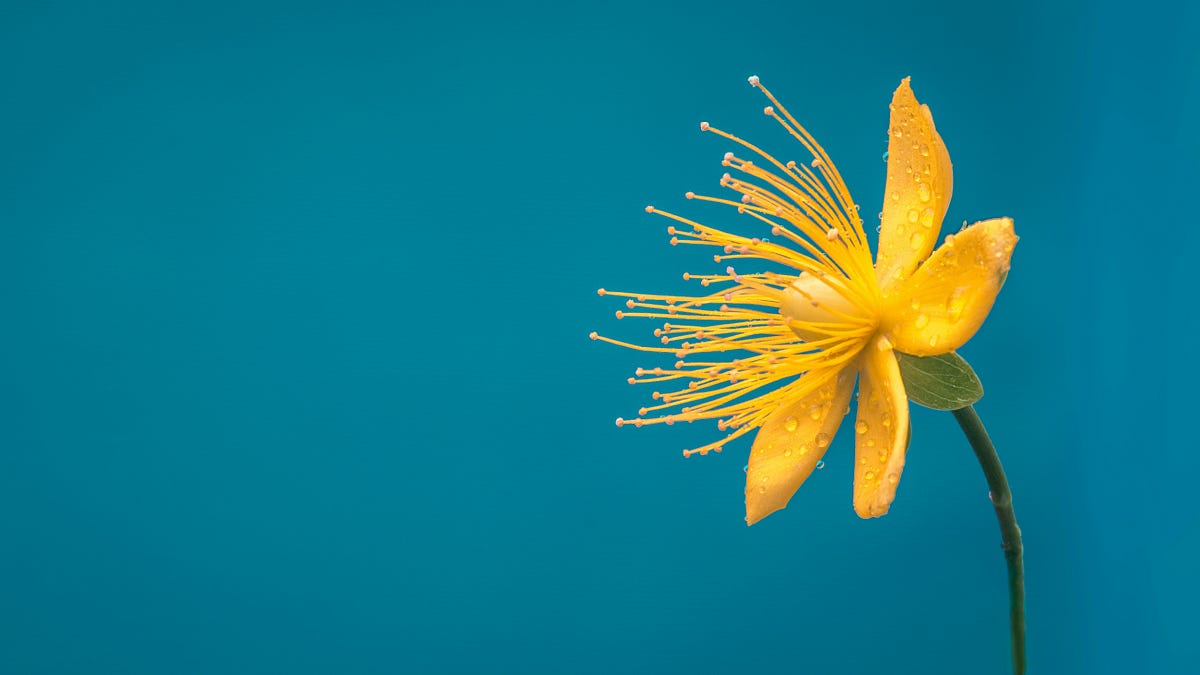
Usamos un mensaje simple `<|image_1|>\n¿Qué se muestra en esta imagen?` donde hacemos referencia a la imagen y solicitamos una descripción de lo que contiene. Este mensaje se procesa con la imagen (la misma imagen que la miniatura de este blog) y se pasa por el modelo. Esto da como resultado el siguiente resultado:
La imagen muestra una sola flor amarilla con un tallo verde sobre un fondo azul.
Una vez cargado el modelo, el procesamiento y la predicción tardaron 2 segundos en un RTX3080.
Ahora que estamos todos configurados, exploremos algunos casos de uso:
Reconocimiento óptico de caracteres (OCR)
Queremos transcribir el texto de una imagen. Para hacerlo, cambie el mensaje y las líneas de la URL de la imagen en el fragmento de código anterior con:
messages = [{"role": "user", "content": "<|image_1|>\nOCR the text of the image as is. OCR:"}]
url = "https://i.postimg.cc/fRFvFVyv/Screenshot-from-2024-05-22-20-55-43.png"
Aporte:
Producción:
3 EXPERIMENTOS
Mostramos que la interpolación de posición puede extender efectivamente la ventana de contexto hasta 32 veces el tamaño original, y dicha extensión se puede realizar con solo varios cientos de pasos de entrenamiento. Mostramos que los modelos resultantes son LLM sólidos con ventanas de contexto largas totalmente efectivas. Demostramos su desempeño en una serie de tareas que incluyen modelado de lenguaje, recuperación de claves de acceso y documentos extensos.
resumen del documento. También presentamos resultados comparativos de los modelos extendidos en los puntos de referencia de evaluación originales de LLaMA.
¡El resultado es el esperado! La transcripción del texto completo tomó 6 segundos, lo cual es un poco lento en comparación con el OCR normal.
Subtítulos de imágenes
El objetivo aquí es subtitular una imagen natural:
messages = [{"role": "user", "content": "<|image_1|>\nWhat is this image of?"}]
url = "https://i.postimg.cc/q7Wjtj3n/Screenshot-from-2024-05-22-20-56-56.png"
Aporte:
Producción:
Esta imagen muestra un juguete de peluche que se parece a un personaje de una popular serie de televisión animada. El juguete tiene un cuerpo redondo con capucha y lleva un par de gafas. El rostro del personaje no es visible en la imagen.
Mayormente correcto (sin gafas 😞). Aún así, llama la atención que reconociera a Kenny de una serie animada.
Análisis de tablas
Queremos ver si el modelo puede analizar la tabla en un formato que sea legible por máquina:
messages = [{"role": "user", "content": "<|image_1|>\nExtract the table content of the table in JSON format: "}]
url = "https://i.postimg.cc/W1YwqXk8/Screenshot-from-2024-05-22-21-41-03.png"
Aporte:
Producción:
```json
[
{
"Benchmark": "Phi-3 Vision-128K-In1",
"MMMU": 40.2,
"MMBench": 80.5,
"ScienceQA": 90.8
},
{
"Benchmark": "LlaVA-1.6 Vicuna-7B",
"MMMU": 34.2,
"MMBench": 76.3,
"ScienceQA": 70.6
},
{
"Benchmark": "QWEN-VI Chat",
"MMMU": 39.0,
"MMBench": 75.8,
"ScienceQA": 67.2
}
]
```
De hecho, es capaz de extraer el contenido de la tabla, en formato estructurado, directamente desde la captura de pantalla.
Comprensión de la figura
Solicitamos al modelo que describa una figura:
messages = [{"role": "user", "content": "<|image_1|>\nWhat is this figure about? "}]
url = "https://i.postimg.cc/Y0sRQR4Q/Screenshot-from-2024-05-22-21-47-39.png"
Aporte:
Producción:
La figura es un gráfico de barras que compara el rendimiento de varios modelos de aprendizaje automático, con cada modelo representado por un par de barras apiladas que indican el rendimiento del modelo base y el modelo ajustado.
Breve pero correcto!
Comprensión lectora en documentos escaneados
El objetivo es hacer preguntas sobre texto escaneado o fotografiado. Esto se diferencia del Reconocimiento Óptico de Caracteres (OCR) en que no nos interesa simplemente transcribir el texto. En cambio, queremos evaluar si el modelo puede comprender el contenido escrito y responder preguntas al respecto directamente.
messages = [{"role": "user", "content": "<|image_1|>\nWhat is this book about? "}]
url = "https://i.postimg.cc/rmHxPbQY/Screenshot-from-2024-05-22-20-56-21.png"
Aporte:
Producción:
La imagen muestra la portada de un libro titulado ‘SAM TALLENT RUNNING THE LIGHT’ con una sinopsis que describe la historia de un comediante llamado Billy Ray Schafer que se enfrenta a desafíos personales y profesionales. El libro parece ser una obra de ficción, posiblemente una novela, ya que incluye una cita de DOUG STANHOPE, ICONOCLAST, que elogia el libro como brillante y la mejor representación ficticia de la comedia.
El título del libro es incorrecto, pero MLLM pudo comprender de qué trata el texto de la imagen y resumirlo de una sola vez.
Solicitud de conjunto de marcas
La indicación de conjunto de marcas (SoM) utiliza modelos de segmentación interactivos para dividir una imagen en regiones y marcarlas con símbolos, lo que permite que los modelos multimodales grandes comprendan y respondan mejor preguntas basadas visualmente.
Para simplificar las cosas en este ejemplo, marqué los objetos manualmente en lugar de usar un modelo y luego hice referencia a la marca. (4) en mi mensaje:
messages = [{"role": "user", "content": "<|image_1|>\nWhat is object number 4? "}]
url = "https://i.postimg.cc/fy0Lz798/scott-webb-p-0l-WFknspg-unsplash-2.jpg"
Aporte:
El objeto número 4 es un cactus con flores de color naranja en una maceta.
El MLLM pudo entender mi referencia y responder a mi pregunta en consecuencia.
¡Ahí lo tienes! Phi-3-Vision es un poderoso modelo para trabajar con imágenes y texto, capaz de comprender el contenido de la imagen, extraer texto de las imágenes e incluso responder preguntas sobre lo que ve. Si bien su pequeño tamaño, con sólo 4 mil millones de parámetros, puede limitar su idoneidad para tareas que exigen fuertes habilidades lingüísticas, la mayoría de los modelos de su clase tienen al menos el doble de su tamaño con 8B de parámetros o más, lo que lo destaca por su eficiencia. Brilla en aplicaciones como análisis de documentos, comprensión de la estructura de tablas y OCR en la naturaleza. Su naturaleza compacta lo hace ideal para su implementación en dispositivos periféricos o GPU locales de consumo, especialmente después de la cuantificación. Será mi modelo de referencia en todos los procesos de análisis y comprensión de documentos, ya que sus capacidades de disparo cero lo convierten en una herramienta capaz, especialmente por su modesto tamaño. A continuación, también trabajaré en algunos scripts de ajuste de LoRA para este modelo para ver hasta dónde puedo llevarlo en tareas más especializadas.
Referencias: