
La generación aumentada por recuperación (RAG, por sus siglas en inglés) ha surgido como una técnica crucial para mejorar los modelos de lenguaje grandes (LLM, por sus siglas en inglés) para manejar conocimiento especializado, proporcionar información actual y adaptarse a dominios específicos sin alterar los pesos del modelo. Sin embargo, el actual flujo de trabajo de RAG enfrenta desafíos significativos. Los LLM tienen dificultades para procesar numerosos contextos fragmentados de manera eficiente, y a menudo funcionan mejor con un conjunto más pequeño de contextos altamente relevantes. Además, garantizar una alta recuperación de contenido relevante dentro de un número limitado de contextos recuperados plantea dificultades. Si bien los modelos de clasificación separados pueden mejorar la selección de contexto, sus capacidades de generalización de disparo cero a menudo son limitadas en comparación con los LLM versátiles. Estos desafíos resaltan la necesidad de un enfoque de RAG más efectivo para equilibrar la extracción de contexto de alta recuperación con la generación de contenido de alta calidad.
En estudios anteriores, los investigadores han hecho numerosos intentos de abordar los desafíos de los sistemas RAG. Algunos enfoques se centran en alinear los recuperadores con las necesidades de LLM, mientras que otros exploran procesos de recuperación de varios pasos o métodos de filtrado de contexto. Se han desarrollado técnicas de ajuste de instrucciones para mejorar tanto las capacidades de búsqueda como el rendimiento RAG de los LLM. La optimización de extremo a extremo de los recuperadores junto con los LLM ha demostrado ser prometedora, pero introduce complejidades en el entrenamiento y el mantenimiento de la base de datos.
Los métodos de clasificación se han empleado como un paso intermedio para mejorar la calidad de la recuperación de información en los procesos RAG. Sin embargo, estos métodos a menudo dependen de modelos adicionales como BERT o T5, que pueden carecer de la capacidad necesaria para capturar por completo la relevancia del contexto de la consulta y tener dificultades para la generalización de cero intentos. Si bien estudios recientes han demostrado las sólidas capacidades de clasificación de los LLM, su integración en los sistemas RAG sigue sin explorarse.
A pesar de estos avances, los métodos existentes necesitan mejorar para equilibrar de manera eficiente la extracción de contexto de alta recuperación con la generación de contenido de alta calidad, especialmente cuando se trata de consultas complejas o dominios de conocimiento diversos.
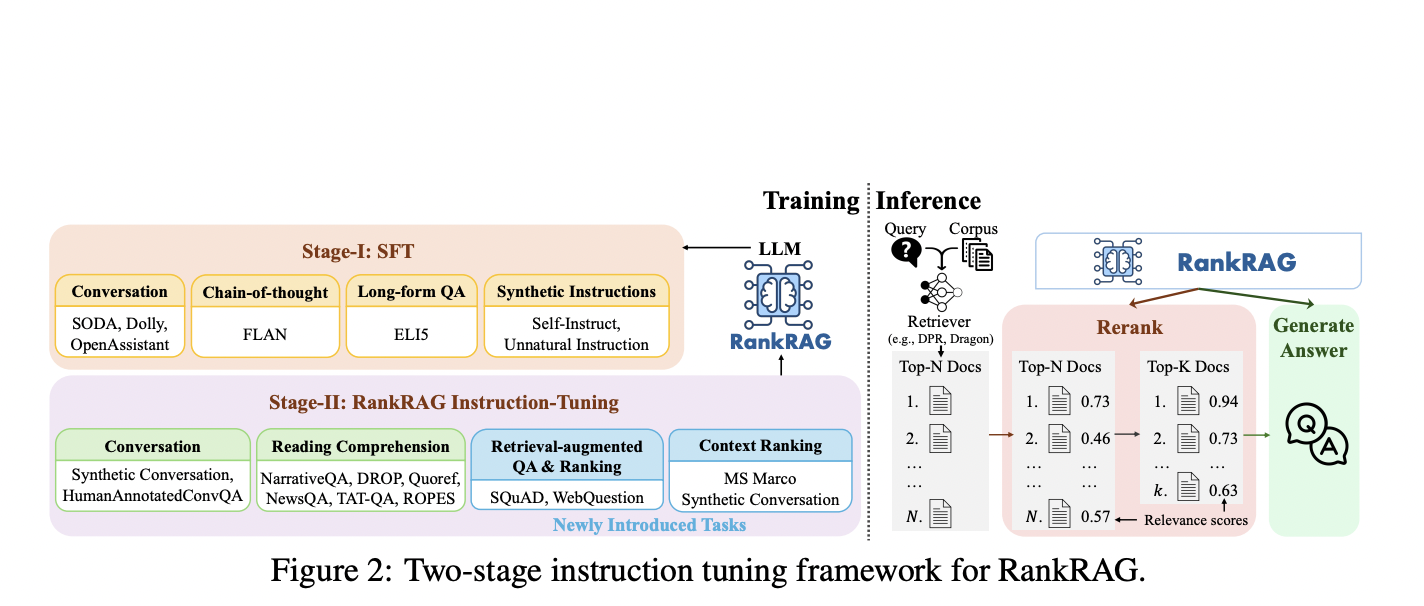
Investigadores de NVIDIA y Georgia Tech presentaron un marco innovador Rango RAGdiseñado para mejorar las capacidades de los LLM en tareas RAG. Este enfoque ajusta de manera única las instrucciones de un solo LLM para realizar tanto la clasificación de contexto como la generación de respuestas dentro del marco RAG. RankRAG amplía los conjuntos de datos de ajuste de instrucciones existentes al incorporar conjuntos de datos de clasificación, control de calidad mejorado con recuperación y respuesta a preguntas enriquecidas con contexto. Este enfoque de entrenamiento integral tiene como objetivo mejorar la capacidad del LLM para filtrar contextos irrelevantes durante las fases de recuperación y generación.
El marco introduce una tarea especializada que se centra en la identificación de contextos o pasajes relevantes para las preguntas dadas. Esta tarea está estructurada para la clasificación, pero enmarcada como una tarea de respuesta a preguntas normal con instrucciones, lo que se alinea de manera más efectiva con las tareas RAG. Durante la inferencia, el LLM primero vuelve a clasificar los contextos recuperados antes de generar respuestas basadas en los contextos top-k refinados. Este enfoque versátil se puede aplicar a una amplia gama de tareas de procesamiento del lenguaje natural que requieren un uso intensivo del conocimiento, lo que ofrece una solución unificada para mejorar el rendimiento de RAG en diversos dominios.
RankRAG mejora los LLM para la generación aumentada por recuperación a través de un proceso de ajuste de instrucciones de dos etapas. La primera etapa implica un ajuste fino supervisado en diversos conjuntos de datos de seguimiento de instrucciones. La segunda etapa unifica las tareas de clasificación y generación, incorporando control de calidad rico en contexto, control de calidad aumentado por recuperación, clasificación de contexto y datos de clasificación aumentados por recuperación. Todas las tareas están estandarizadas en un formato (pregunta, contexto, respuesta), lo que facilita la transferencia de conocimiento. Durante la inferencia, RankRAG emplea un proceso de recuperación-reclasificación-generación: recupera los N contextos principales, los reclasifica para seleccionar los k más relevantes y genera respuestas basadas en estos contextos refinados. Este enfoque mejora tanto la evaluación de la relevancia del contexto como las capacidades de generación de respuestas dentro de un solo LLM.
RankRAG demuestra un rendimiento superior en tareas de generación aumentada por recuperación en varios puntos de referencia. La versión de 8B de parámetros supera constantemente a ChatQA-1.5 8B y compite favorablemente con modelos más grandes, incluidos aquellos con 5 a 8 veces más parámetros. RankRAG 70B supera al sólido modelo ChatQA-1.5 70B y supera significativamente las líneas base de RAG anteriores utilizando InstructGPT.
RankRAG muestra mejoras más sustanciales en conjuntos de datos complejos, como el control de calidad de cola larga (PopQA) y el control de calidad de múltiples saltos (2WikimQA), con una mejora de más del 10 % en comparación con ChatQA-1.5. Estos resultados sugieren que la capacidad de clasificación de contexto de RankRAG es particularmente eficaz en situaciones en las que los documentos más recuperados son menos relevantes para la respuesta, lo que mejora el rendimiento en tareas complejas de OpenQA.

Esta investigación presenta Rango RAG, representa un avance significativo en los sistemas RAG. Este marco innovador ajusta la instrucción de un único LLM para realizar tareas de clasificación de contexto y generación de respuestas simultáneamente. Al incorporar una pequeña cantidad de datos de clasificación en la combinación de entrenamiento, RankRAG permite a los LLM superar el rendimiento de los modelos de clasificación de expertos existentes. La eficacia del marco ha sido ampliamente validada a través de evaluaciones integrales en puntos de referencia de conocimiento intensivo. RankRAG demuestra un rendimiento superior en nueve puntos de referencia RAG de dominio general y cinco biomédicos, superando significativamente a los modelos RAG de última generación. Este enfoque unificado para la clasificación y la generación dentro de un único LLM representa una dirección prometedora para mejorar las capacidades de los sistemas RAG en varios dominios.
Revisar la Papel. Todo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Más de 46 000 suscriptores de ML en Reddit, Boletín informativo de más de 26.000 inteligencia artificial, Canal de Telegram, y LinkedIn Gr¡Arriba!.
Si está interesado en una asociación promocional (contenido/anuncio/boletín informativo), complete el siguiente formulario: esta forma.

Asjad es consultor en prácticas en Marktechpost. Está cursando la licenciatura en ingeniería mecánica en el Instituto Indio de Tecnología de Kharagpur. Asjad es un entusiasta del aprendizaje automático y del aprendizaje profundo que siempre está investigando las aplicaciones del aprendizaje automático en el ámbito de la atención médica.