
El aprendizaje automático ha logrado avances significativos, en particular a través de técnicas de aprendizaje profundo. Estos avances dependen en gran medida de algoritmos de optimización para entrenar modelos a gran escala para diversas tareas, incluido el procesamiento del lenguaje y la clasificación de imágenes. En el centro de este proceso se encuentra el desafío de minimizar las funciones de pérdida complejas y no convexas. Los algoritmos de optimización como el Descenso de gradiente estocástico (SGD) y sus variantes adaptativas se han vuelto fundamentales para este esfuerzo. Estos métodos apuntan a ajustar iterativamente los parámetros del modelo para minimizar los errores durante el entrenamiento, lo que garantiza que los modelos puedan generalizar bien en datos no vistos. Sin embargo, si bien estas técnicas de optimización han demostrado ser útiles, aún queda un margen significativo para mejorar la forma en que manejan la información de gradiente a largo plazo.
Un desafío fundamental en el entrenamiento de redes neuronales grandes es el uso efectivo de gradientes, que proporcionan las actualizaciones necesarias para optimizar los parámetros del modelo. Los optimizadores tradicionales como Adam y AdamW dependen en gran medida de una media móvil exponencial (EMA) de gradientes recientes, enfatizando la información de gradiente más actual y descartando gradientes más antiguos. Este enfoque funciona bien para modelos donde los cambios recientes tienen más importancia. Sin embargo, esto puede ser problemático para modelos más grandes y ciclos de entrenamiento largos, ya que los gradientes más antiguos a menudo aún contienen información valiosa. Como resultado, el proceso de optimización puede ser menos eficiente, requiriendo períodos de entrenamiento más largos o no logrando alcanzar las mejores soluciones posibles.
En los métodos de optimización actuales, en particular Adam y AdamW, el uso de una única EMA para gradientes pasados puede limitar la capacidad del optimizador para capturar un espectro completo del historial de gradientes. Estos métodos pueden adaptarse rápidamente a los cambios recientes, pero a menudo necesitan información más valiosa de gradientes más antiguos. Los investigadores han explorado varios enfoques para abordar esta limitación, pero muchos optimizadores aún tienen dificultades para encontrar el equilibrio óptimo entre la incorporación eficaz de gradientes recientes y pasados. Esta deficiencia puede dar como resultado tasas de convergencia subóptimas y un rendimiento del modelo más deficiente, especialmente en escenarios de entrenamiento a gran escala como modelos de lenguaje o transformadores de visión.
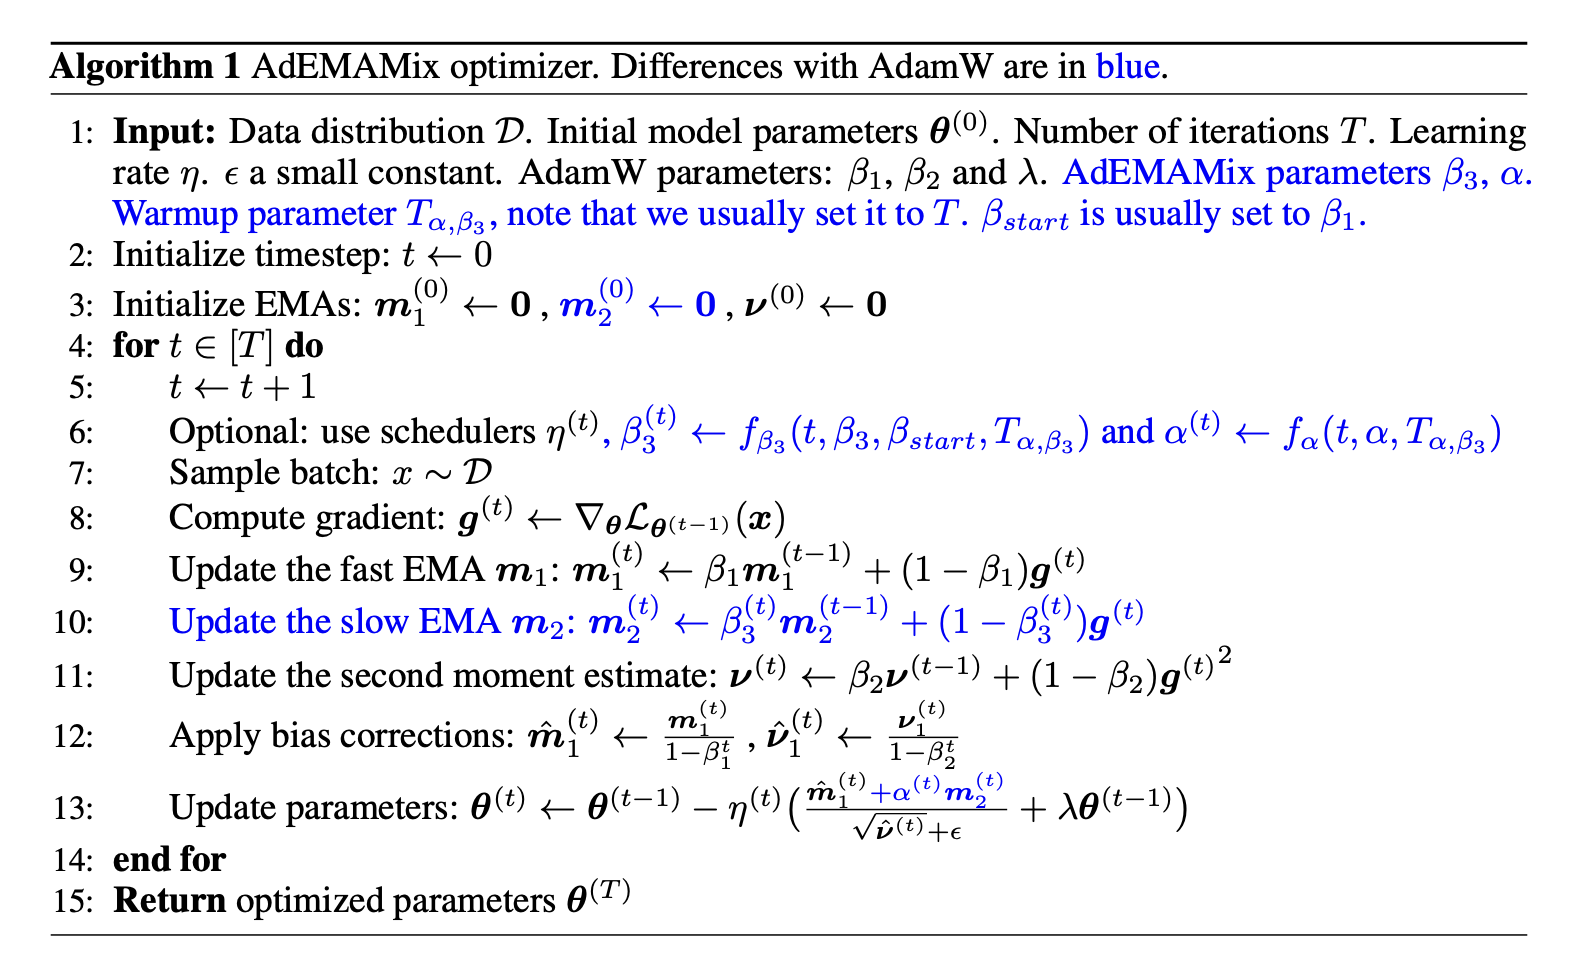
Los investigadores de Apple y EPFL introdujeron un nuevo enfoque para este problema con el Mezcla AdEMA Optimizador. Su método amplía el optimizador tradicional de Adam al incorporar una mezcla de dos EMA, una que cambia rápidamente y otra que cambia lentamente. Este enfoque permite al optimizador equilibrar la necesidad de responder a actualizaciones recientes y, al mismo tiempo, conservar gradientes antiguos valiosos que los optimizadores existentes suelen descartar. Este sistema de EMA dual, exclusivo de AdEMAMix, permite un entrenamiento más eficiente de modelos a gran escala, lo que reduce la cantidad total de tokens necesarios para el entrenamiento y, al mismo tiempo, logra resultados comparables o mejores.
El optimizador AdEMAMix introduce una segunda EMA para capturar gradientes más antiguos sin perder la reactividad proporcionada por la EMA original. Específicamente, AdEMAMix mantiene una EMA de rápido movimiento que prioriza los gradientes recientes mientras rastrea una EMA de movimiento más lento que retiene la información mucho antes en el proceso de entrenamiento. Por ejemplo, al entrenar un modelo de lenguaje de 1.3 mil millones de parámetros en el conjunto de datos RedPajama, los investigadores descubrieron que AdEMAMix podía igualar el rendimiento de un modelo AdamW entrenado en 197 mil millones de tokens con solo 101 mil millones de tokens, una reducción de aproximadamente el 95% en el uso de tokens. Esta ganancia de eficiencia se traduce en una convergencia más rápida y, a menudo, en mejores mínimos, lo que permite que los modelos alcancen un rendimiento superior con menos recursos computacionales.
Las evaluaciones de rendimiento de AdEMAMix han demostrado mejoras sustanciales en velocidad y precisión en comparación con los optimizadores existentes. En un experimento clave, un modelo de 110 millones de parámetros entrenado con AdEMAMix alcanzó valores de pérdida similares a los de un modelo AdamW que requirió casi el doble de iteraciones de entrenamiento. En concreto, el modelo AdEMAMix, entrenado para 256.000 iteraciones, logró los mismos resultados que un modelo AdamW entrenado para 500.000 iteraciones. En el caso de modelos aún más grandes, como el modelo de lenguaje de 1.300 millones de parámetros, AdEMAMix arrojó resultados comparables a los de un modelo AdamW entrenado para 1,5 millones de iteraciones, pero con un 51 % menos de tokens. El optimizador también demostró una tasa de olvido más lenta, lo que constituye una ventaja fundamental para mantener la precisión del modelo durante ciclos de entrenamiento largos.

Los investigadores también abordaron algunos desafíos comunes que enfrentan los optimizadores, como las inestabilidades en el entrenamiento inicial. Para superarlas, introdujeron pasos de calentamiento para la EMA más grande de las dos, aumentando progresivamente el valor de la EMA de cambio lento durante el entrenamiento. Este aumento gradual ayuda a estabilizar el modelo durante la fase de entrenamiento inicial, lo que evita que el optimizador dependa demasiado de forma prematura de gradientes obsoletos. Al programar cuidadosamente los ajustes para las dos EMA, AdEMAMix garantiza que el proceso de optimización se mantenga estable y eficiente durante el entrenamiento, incluso para modelos con decenas de miles de millones de parámetros.

En conclusión, el optimizador AdEMAMix presenta un avance notable en la optimización del aprendizaje automático. La incorporación de dos EMA para aprovechar los gradientes recientes y antiguos aborda mejor una limitación clave de los optimizadores tradicionales como Adam y AdamW. Este enfoque de EMA dual permite que los modelos logren una convergencia más rápida con menos tokens, lo que reduce la carga computacional del entrenamiento de modelos grandes; AdEMAMix superó constantemente a A en trialsdamW, lo que demuestra su potencial para mejorar el rendimiento en tareas de modelado de lenguaje y clasificación de imágenes. La capacidad del método para reducir el olvido del modelo durante el entrenamiento subraya aún más su valor para proyectos de ML a gran escala y a largo plazo, lo que lo convierte en una herramienta poderosa para investigadores y la industria.
Echa un vistazo a la Papel y GitHub. Todo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y LinkedInÚnete a nuestro Canal de Telegram.
Si te gusta nuestro trabajo, te encantará nuestro hoja informativa..
No olvides unirte a nuestro Subreddit con más de 50 000 millones de usuarios
Asif Razzaq es el director ejecutivo de Marktechpost Media Inc. Como ingeniero y emprendedor visionario, Asif está comprometido con aprovechar el potencial de la inteligencia artificial para el bien social. Su iniciativa más reciente es el lanzamiento de una plataforma de medios de inteligencia artificial, Marktechpost, que se destaca por su cobertura en profundidad de noticias sobre aprendizaje automático y aprendizaje profundo que es técnicamente sólida y fácilmente comprensible para una amplia audiencia. La plataforma cuenta con más de 2 millones de visitas mensuales, lo que ilustra su popularidad entre el público.