
En este tutorial, presentamos un enfoque optimizado para extraer, procesar y analizar las transcripciones de video de YouTube utilizando Lyzrun marco avanzado con AI diseñado para simplificar la interacción con datos textuales. Aprovechando la interfaz de chatbot intuitiva de Lyzr junto con YouTube-Transcript-API y FPDF, los usuarios pueden convertir sin esfuerzo el contenido de video en documentos PDF estructurados y realizar análisis perspicaces a través de interacciones dinámicas. Ideal para investigadores, educadores y creadores de contenido, Lyzr acelera el proceso de derivar ideas significativas, generar resúmenes y formular preguntas creativas directamente de los recursos multimedia.
!pip install lyzr youtube-transcript-api fpdf2 ipywidgets
!apt-get update -qq && apt-get install -y fonts-dejavu-core
Configuramos el entorno necesario para el tutorial. El primer comando instala bibliotecas esenciales de Python, incluidas las LYZR para el chat con AI, YouTube-Transcript-API para la extracción de transcripción, FPDF2 para la generación de PDF y ipywidgets para crear interfaces de chat interactivas. El segundo comando asegura que la fuente de sans deJavu esté instalada en el sistema para admitir la representación de texto unicode completo dentro de los archivos PDF generados.
import os
import openai


openai.api_key = os.getenv("OPENAI_API_KEY")
os.environ['OPENAI_API_KEY'] = "YOUR_OPENAI_API_KEY_HERE"
Configuramos el acceso a la tecla API de OpenAI para el tutorial. Importamos los módulos OS y OpenAI, luego recuperamos la clave API de las variables de entorno (o la establecemos directamente a través de OS.environ). Esta configuración es esencial para aprovechar las potentes modelos de OpenAI dentro del marco LYZR.
import json
from lyzr import ChatBot
from youtube_transcript_api import YouTubeTranscriptApi, TranscriptsDisabled, NoTranscriptFound, CouldNotRetrieveTranscript
from fpdf import FPDF
from ipywidgets import Textarea, Button, Output, Layout
from IPython.display import display, Markdown
import re
Mira el completo Cuaderno aquí
Importamos bibliotecas esenciales necesarias para el tutorial. Incluye JSON para el manejo de datos, el chatbot de Lyzr para capacidades de chat impulsadas por AI y YouTubETranscriptapi para extraer transcripciones de los videos de YouTube. Además, trae FPDF para la generación PDF, ipywidgets para componentes interactivos de la interfaz de usuario y ipython.display para representar el contenido de markdown en cuadernos. El módulo RE también se importa para operaciones de expresión regulares en tareas de procesamiento de texto.
def transcript_to_pdf(video_id: str, output_pdf_path: str) -> bool:
    """
    Download YouTube transcript (manual or auto) and write it into a PDF
    using the system-installed DejaVuSans.ttf for full Unicode support.
    Fixed to handle long words and text formatting issues.
    """
    try:
        entries = YouTubeTranscriptApi.get_transcript(video_id)
    except (TranscriptsDisabled, NoTranscriptFound, CouldNotRetrieveTranscript):
        try:
            entries = YouTubeTranscriptApi.get_transcript(video_id, languages=['en'])
        except Exception:
            print(f"[!] No transcript for {video_id}")
            return False
    except Exception as e:
        print(f"[!] Error fetching transcript for {video_id}: {e}")
        return False


    text = "\n".join(e['text'] for e in entries).strip()
    if not text:
        print(f"[!] Empty transcript for {video_id}")
        return False


    pdf = FPDF()
    pdf.add_page()


    font_path = "/usr/share/fonts/truetype/dejavu/DejaVuSans.ttf"
    try:
        if os.path.exists(font_path):
            pdf.add_font("DejaVu", "", font_path)
            pdf.set_font("DejaVu", size=10)
        else:
            pdf.set_font("Arial", size=10)
    except Exception:
        pdf.set_font("Arial", size=10)


    pdf.set_margins(20, 20, 20)
    pdf.set_auto_page_break(auto=True, margin=25)


    def process_text_for_pdf(text):
        text = re.sub(r'\s+', ' ', text)
        text = text.replace('\n\n', '\n')


        processed_lines = []
        for paragraph in text.split('\n'):
            if not paragraph.strip():
                continue


            words = paragraph.split()
            processed_words = []
            for word in words:
                if len(word) > 50:
                    chunks = [word[i:i+50] for i in range(0, len(word), 50)]
                    processed_words.extend(chunks)
                else:
                    processed_words.append(word)


            processed_lines.append(' '.join(processed_words))


        return processed_lines


    processed_lines = process_text_for_pdf(text)


    for line in processed_lines:
        if line.strip():
            try:
                pdf.multi_cell(0, 8, line.encode('utf-8', 'replace').decode('utf-8'), align='L')
                pdf.ln(2)
            except Exception as e:
                print(f"[!] Warning: Skipped problematic line: {str(e)[:100]}...")
                continue


    try:
        pdf.output(output_pdf_path)
        print(f"[+] PDF saved: {output_pdf_path}")
        return True
    except Exception as e:
        print(f"[!] Error saving PDF: {e}")
        return False
Mira el completo Cuaderno aquí
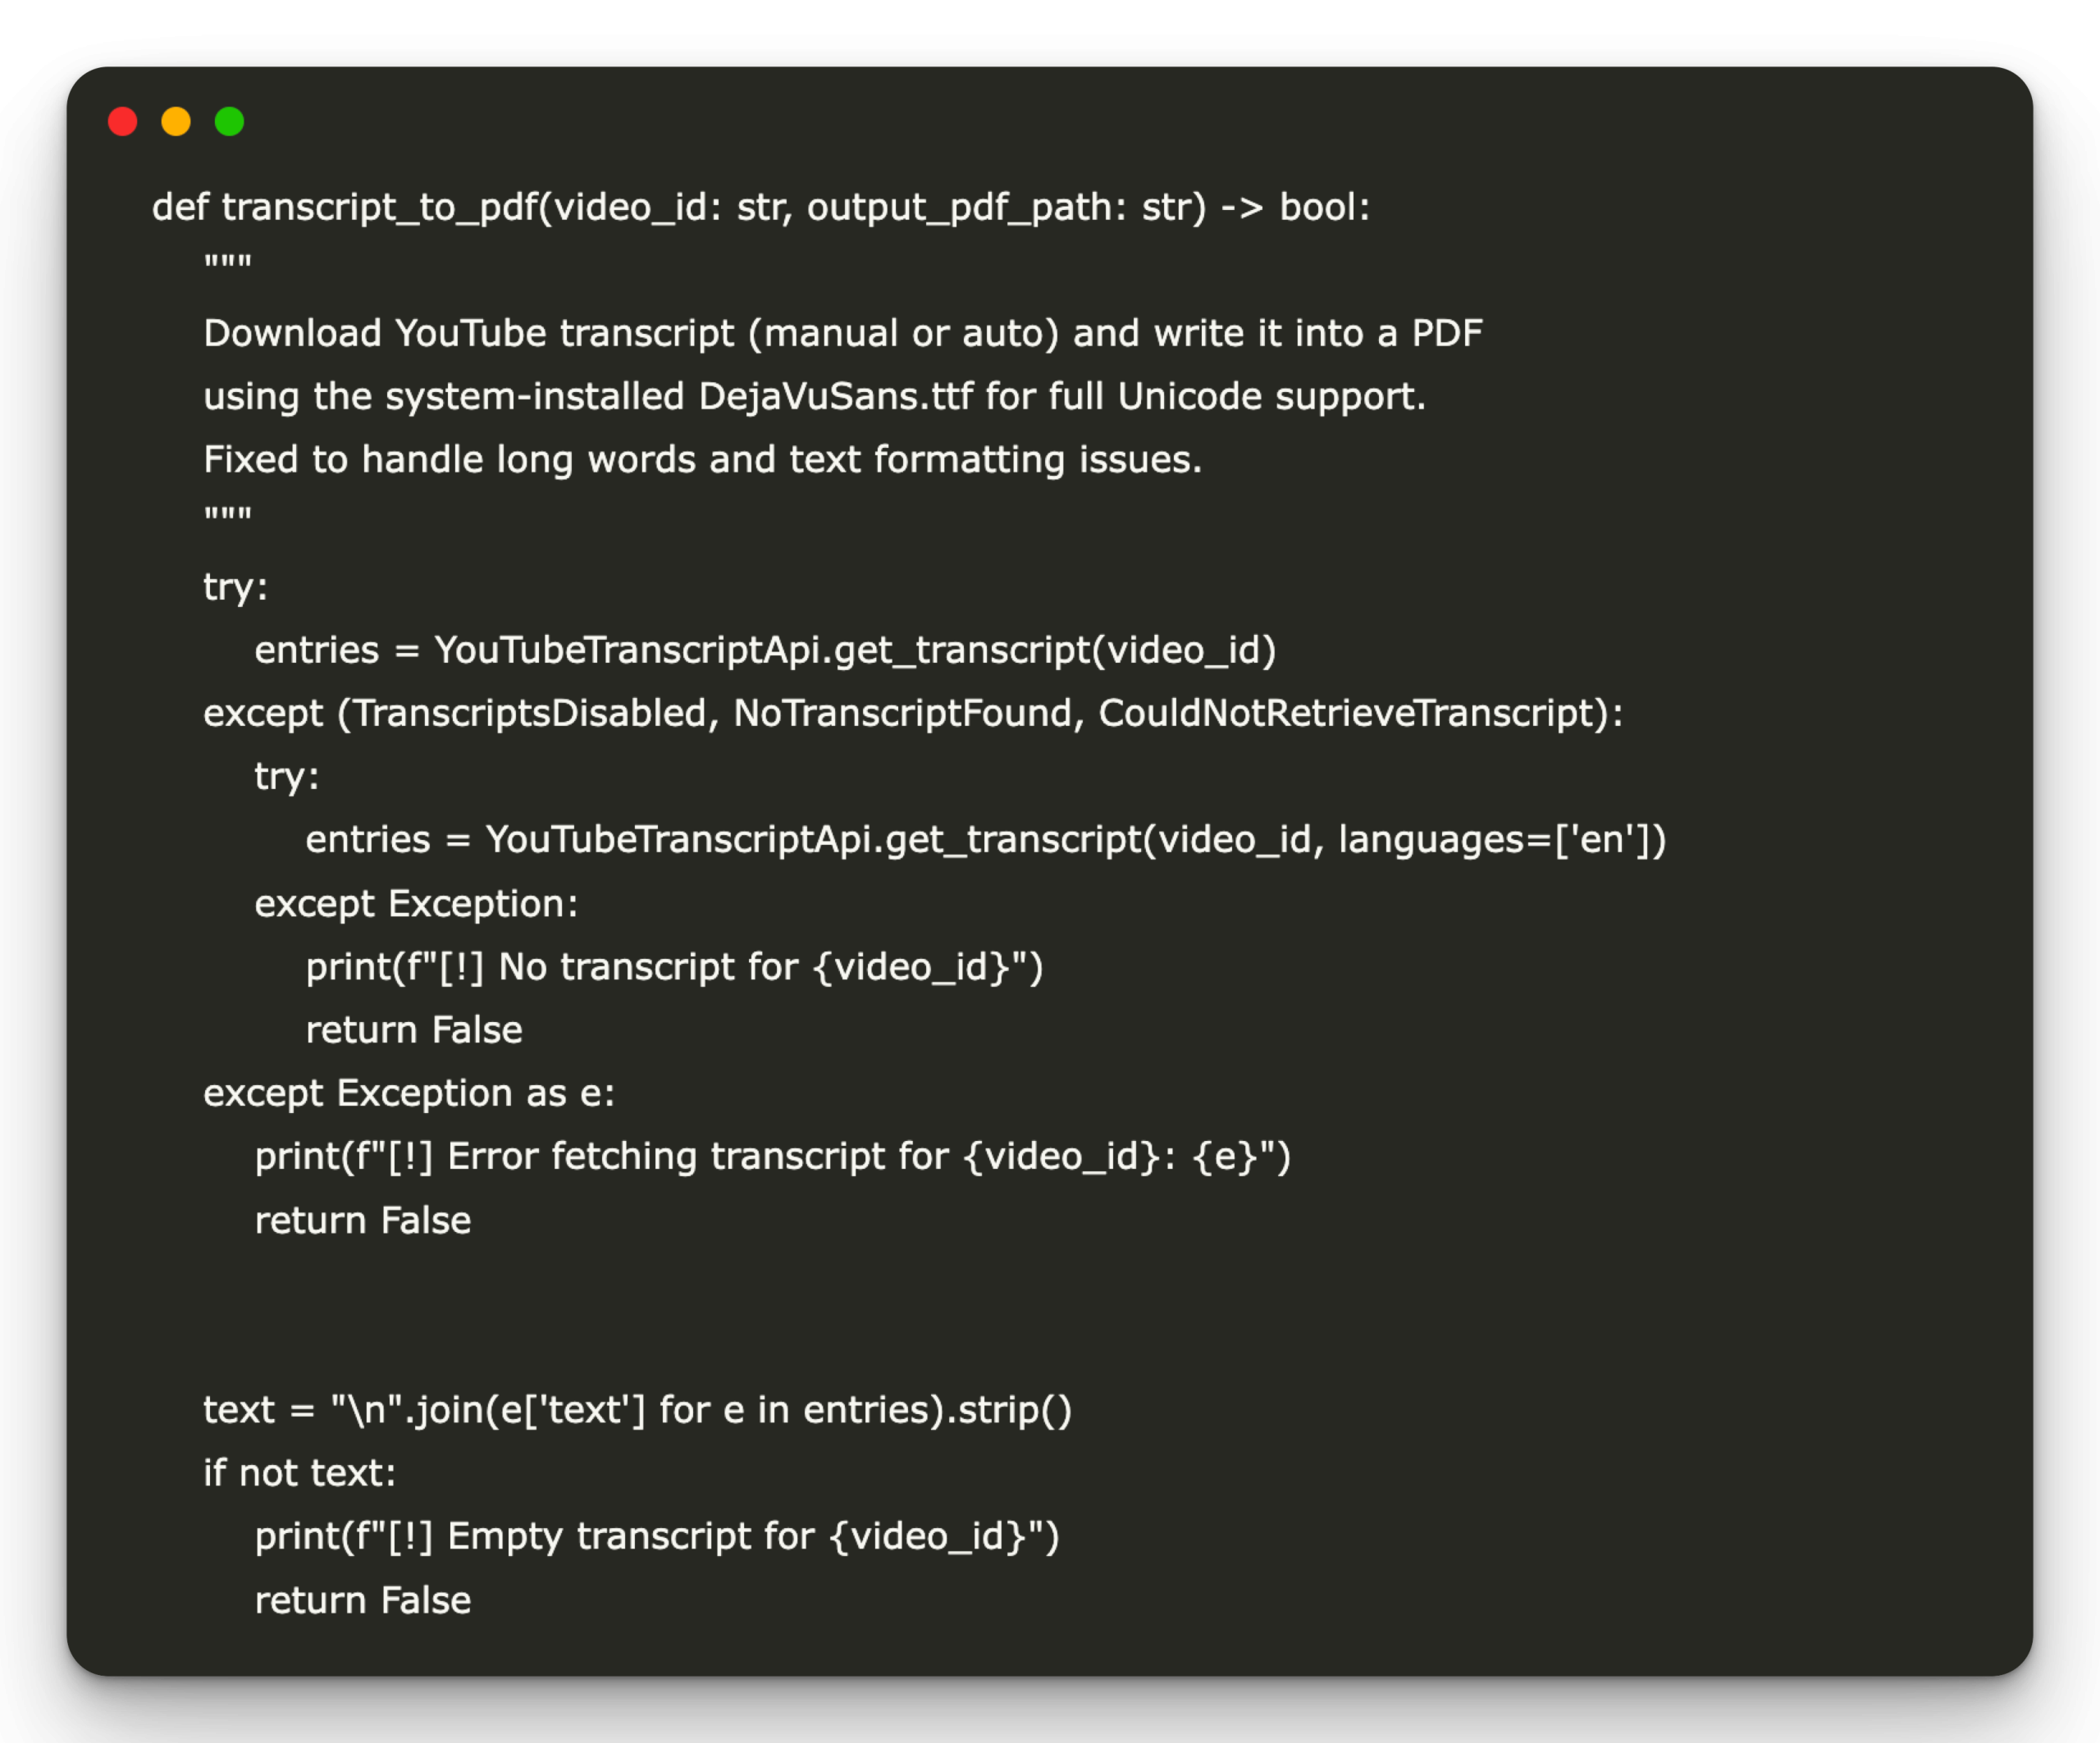
Esta función, transcript_to_pdf, automatiza la conversión de transcripciones de video de YouTube en documentos PDF limpios y legibles. Recupera la transcripción utilizando YouTubETranscriptapi, maneja con gracia excepciones como transcripciones no disponibles, y formatea el texto para evitar problemas como palabras largas que rompen el diseño PDF. La función también garantiza el soporte de Unicode adecuado mediante el uso de la fuente DeJavusans (si está disponible) y optimiza el texto para la representación PDF dividiendo palabras demasiado largas y manteniendo márgenes consistentes. Devuelve verdadero si el PDF se genera con éxito o falso si se producen errores.
def create_interactive_chat(agent):
    input_area = Textarea(
        placeholder="Type a question…", layout=Layout(width="80%", height="80px")
    )
    send_button = Button(description="Send", button_style="success")
    output_area = Output(layout=Layout(
        border="1px solid gray", width="80%", height="200px", overflow='auto'
    ))


    def on_send(btn):
        question = input_area.value.strip()
        if not question:
            return
        with output_area:
            print(f">> You: {question}")
            try:
                print("<< Bot:", agent.chat(question), "\n")
            except Exception as e:
                print(f"[!] Error: {e}\n")


    send_button.on_click(on_send)
    display(input_area, send_button, output_area)
Mira el completo Cuaderno aquí
Esta función, create_interactive_chat, crea una interfaz de chat simple e interactiva dentro de Colab. El uso de iPyWidgets proporciona un área de entrada de texto (TextAREA) para que los usuarios escriban preguntas, un botón de envío (botón) para activar el chat y un área de salida (salida) para mostrar la conversación. Cuando el usuario hace clic en Enviar, la pregunta ingresada se pasa al agente de chatbot Lyzr, que genera y muestra una respuesta. Esto permite a los usuarios participar en sesiones dinámicas de preguntas y respuestas basadas en el análisis de transcripción, lo que hace que la interacción como una conversación en vivo con el modelo AI.
def main():
    video_ids = ["dQw4w9WgXcQ", "jNQXAC9IVRw"]
    processed = []


    for vid in video_ids:
        pdf_path = f"{vid}.pdf"
        if transcript_to_pdf(vid, pdf_path):
            processed.append((vid, pdf_path))
        else:
            print(f"[!] Skipping {vid} — no transcript available.")


    if not processed:
        print("[!] No PDFs generated. Please try other video IDs.")
        return


    first_vid, first_pdf = processed[0]
    print(f"[+] Initializing PDF-chat agent for video {first_vid}…")
    bot = ChatBot.pdf_chat(
        input_files=[first_pdf]
    )


    questions = [
        "Summarize the transcript in 2–3 sentences.",
        "What are the top 5 insights and why?",
        "List any recommendations or action items mentioned.",
        "Write 3 quiz questions to test comprehension.",
        "Suggest 5 creative prompts to explore further."
    ]
    responses = {}
    for q in questions:
        print(f"[?] {q}")
        try:
            resp = bot.chat(q)
        except Exception as e:
            resp = f"[!] Agent error: {e}"
        responses[q] = resp
        print(f"[/] {resp}\n" + "-"*60 + "\n")


    with open('responses.json','w',encoding='utf-8') as f:
        json.dump(responses,f,indent=2)
    md = "# Transcript Analysis Report\n\n"
    for q,a in responses.items():
        md += f"## Q: {q}\n{a}\n\n"
    with open('report.md','w',encoding='utf-8') as f:
        f.write(md)


    display(Markdown(md))


    if len(processed) > 1:
        print("[+] Generating comparison…")
        _, pdf1 = processed[0]
        _, pdf2 = processed[1]
        compare_bot = ChatBot.pdf_chat(
            input_files=[pdf1, pdf2]
        )
        comparison = compare_bot.chat(
            "Compare the main themes of these two videos and highlight key differences."
        )
        print("[+] Comparison Result:\n", comparison)


    print("\n=== Interactive Chat (Video 1) ===")
    create_interactive_chat(bot)
Mira el completo Cuaderno aquí
Nuestra función principal () sirve como el controlador central para toda la tubería tutorial. Procesa una lista de ID de video de YouTube, convirtiendo las transcripciones disponibles en archivos PDF utilizando la función Transcript_TO_PDF. Una vez que se generan PDFS, se inicializa un agente LYZR PDF-CHAT en el primer PDF, lo que permite que el modelo responda preguntas predefinidas, como resumir el contenido, identificar ideas y generar preguntas de prueba. Las respuestas se almacenan en un archivo de respuestas.json y se formatean en un informe de Markdown (Report.MD). Si se crean múltiples PDF, la función los compara utilizando el agente LYZR para resaltar las diferencias clave entre los videos. Finalmente, inicia una interfaz de chat interactiva con el usuario, que permite conversaciones dinámicas basadas en el contenido de la transcripción, que muestra el poder de Lyzr para un análisis PDF sin interrupciones e interacciones impulsadas por IA.
if __name__ == "__main__":
    main()
Nos aseguramos de que la función Main () se ejecute solo cuando el script se ejecuta directamente, no cuando se importa como un módulo. Es una mejor práctica en los scripts de Python para controlar el flujo de ejecución.
En conclusión, al integrar Lyzr en nuestro flujo de trabajo como se demuestra en este tutorial, podemos transformar sin esfuerzo los videos de YouTube en un conocimiento perspicaz y procesable. La capacidad inteligente de PDF-CHAT de LYZR simplifica la extracción de temas centrales y la generación de resúmenes completos, y también permite una exploración interactiva e interactiva de contenido a través de una interfaz conversacional intuitiva. Adoptar Lyzr permite a los usuarios desbloquear ideas más profundas y mejorar significativamente la productividad al trabajar con transcripciones de video, ya sea para investigación académica, fines educativos o análisis de contenido creativo.
Mira el Cuaderno aquí. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, siéntete libre de seguirnos Gorjeo Y no olvides unirte a nuestro 95k+ ml de subreddit y suscribirse a Nuestro boletín.
Asif Razzaq es el CEO de MarktechPost Media Inc .. Como empresario e ingeniero visionario, ASIF se compromete a aprovechar el potencial de la inteligencia artificial para el bien social. Su esfuerzo más reciente es el lanzamiento de una plataforma de medios de inteligencia artificial, MarktechPost, que se destaca por su cobertura profunda de noticias de aprendizaje automático y de aprendizaje profundo que es técnicamente sólido y fácilmente comprensible por una audiencia amplia. La plataforma cuenta con más de 2 millones de vistas mensuales, ilustrando su popularidad entre el público.
