
Tiempo de lectura estimado: 6 minutos
AI acaba de desbloquear triple el poder de las GPU, sin intervención humana. Equipo de profundidad introdujo un nuevo marco llamado CUDA-L1 Eso ofrece un promedio 3.12 × Speedup y hasta Aceleración de 120 × pico En 250 tareas de GPU del mundo real. Esta no es una mera promesa académica: cada resultado puede reproducirse con un código de código abierto, en hardware NVIDIA ampliamente utilizado.
El avance: aprendizaje de refuerzo contrastante (contrastante-RL)
En el corazón de CUDA-L1 se encuentra un gran salto en la estrategia de aprendizaje de IA: Aprendizaje de refuerzo contrastante (contrastive-RL). A diferencia de la RL tradicional, donde una IA simplemente genera soluciones, recibe recompensas numéricas y actualiza los parámetros de su modelo a ciegas, contrastive-RL Alimenta los puntajes de rendimiento y las variantes anteriores directamente en el aviso de la próxima generación.
- Los puntajes de rendimiento y las variantes de código se dan a la IA en cada ronda de optimización.
- El modelo debe entonces Escriba un “análisis de rendimiento” en lenguaje natural—Eflectar en qué código era el más rápido, por quéy qué estrategias condujeron a esa aceleración.
- Cada paso fuerza el razonamiento complejoguiando al modelo para sintetizar no solo una nueva variante de código, sino también un modelo mental más generalizado y basado en datos de lo que hace que el código CUDA sea rápido.
El resultado? La ai descubre no solo optimizaciones bien conocidaspero también trucos no obvios que incluso los expertos humanos a menudo pasan por alto, incluidos atajos matemáticos que evitan completamente el cálculo o las estrategias de memoria sintonizadas con peculiaridades de hardware específicas.

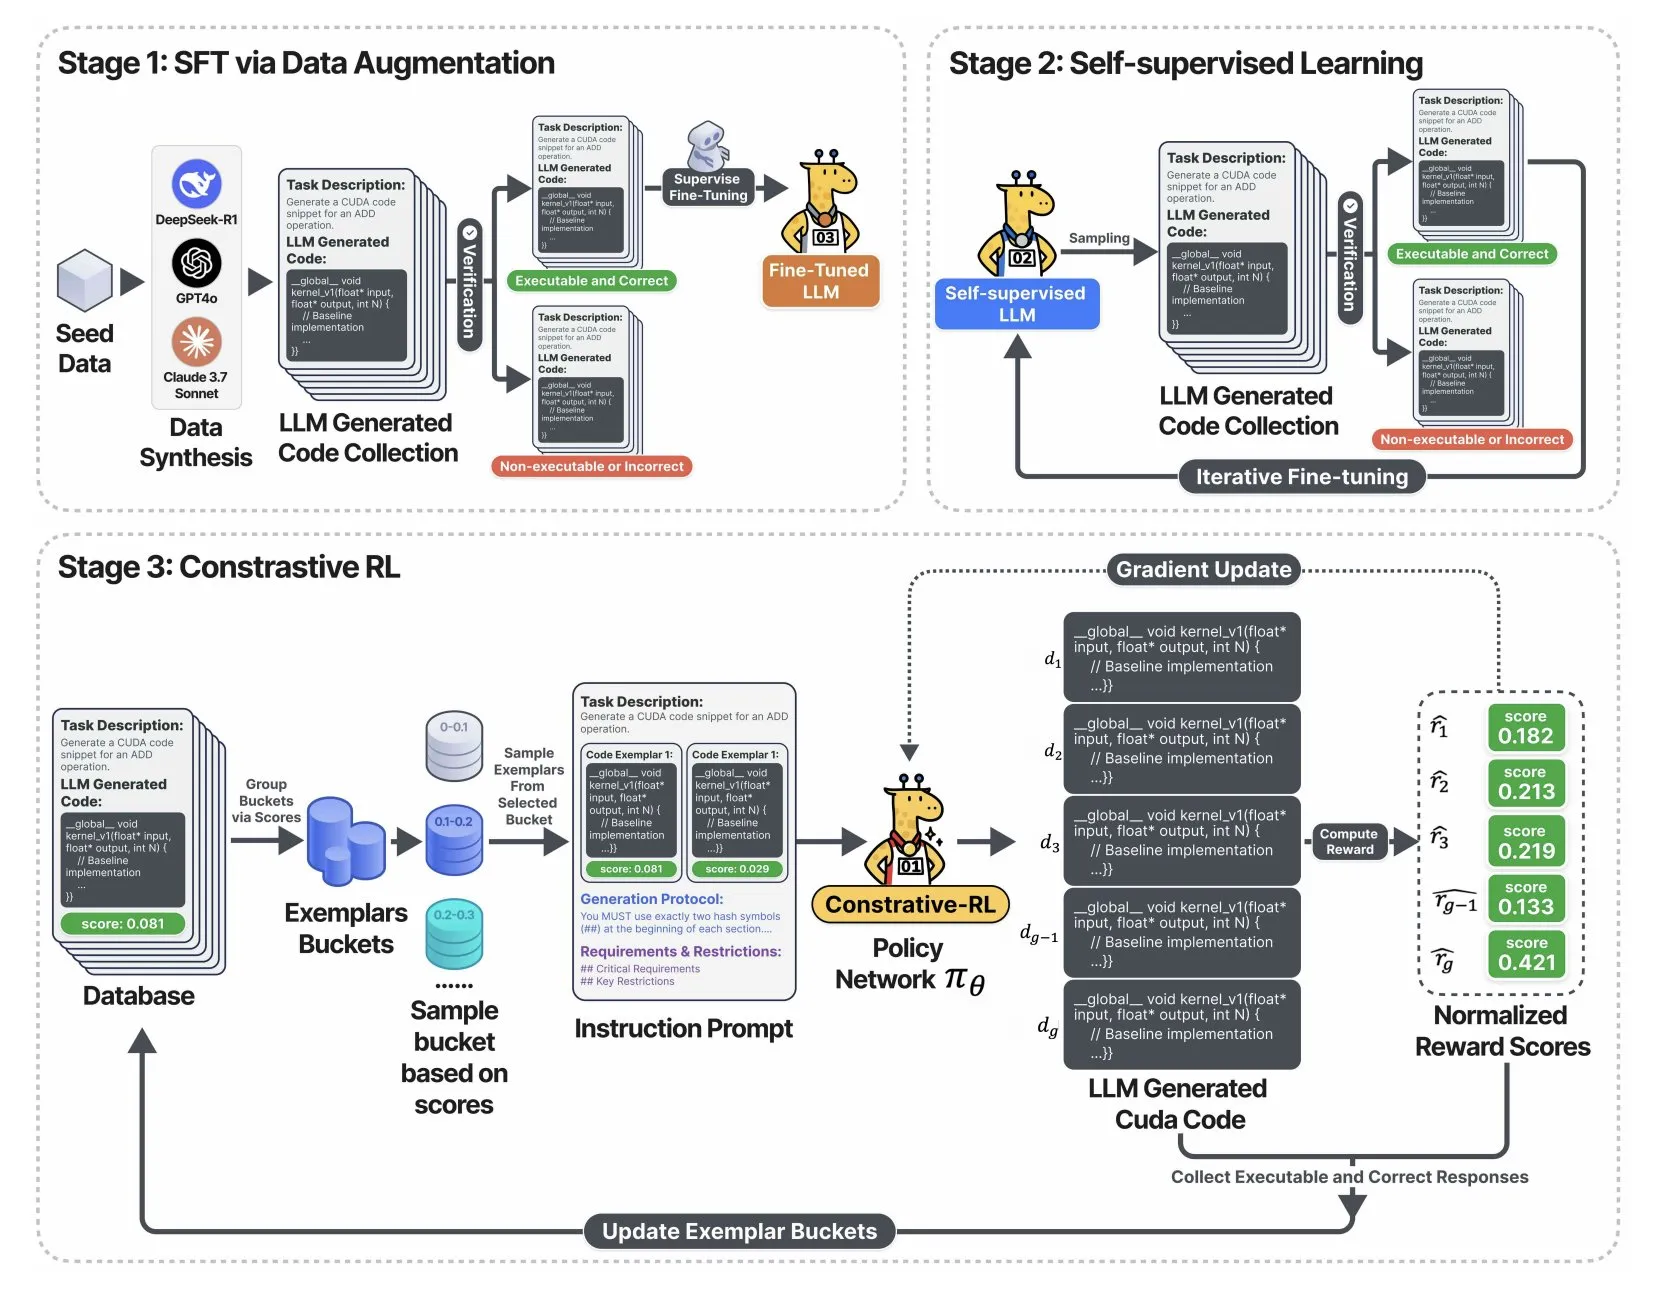
El diagrama anterior captura el tubería de entrenamiento de tres etapas:
- Etapa 1: El LLM está ajustado utilizando el código CUDA validado, recolectado por el muestreo de los modelos de base líder (Deepseek-R1, GPT-4O, Claude, etc.), pero conservando solo salidas correctas y ejecutables.
- Etapa 2: El modelo ingresa a un bucle de autodenomisión: genera mucho código CUDA, mantiene solo los funcionales y los usa para aprender más. Resultado: mejora rápida en la corrección y cobertura del código, todo sin etiquetado manual.
- Etapa 3: En el Fase contrastante-RLel sistema muestra múltiples variantes de código, muestra cada una con su velocidad medida y desafía a la IA a debatir, analizar y superar generaciones anteriores antes de producir la próxima ronda de optimizaciones. Este bucle de reflexión y mejoramiento es el volante clave que ofrece aceleraciones masivas.
¿Qué tan bueno es Cuda-L1? Datos duros
Aceleras en todos los ámbitos
Kernelbench—El punto de referencia estándar de oro para la generación de código GPU (250 cargas de trabajo de Pytorch del mundo real) se utilizó para medir CUDA-L1:
| Modelo/escenario | Avg. Aceleración | Aceleración máxima | Mediana | Tasa de éxito |
|---|---|---|---|---|
| Vanilla Llama-3.1-405B | 0.23 × | 3.14 × | 0 × | 68/250 |
| Deepseek-r1 (rl-ajustado) | 1.41 × | 44.2 × | 1.17 × | 248/250 |
| CUDA-L1 (todas las etapas) | 3.12 × | 120 × | 1.42 × | 249/250 |
- 3.12 × aceleración promedio: La IA encontró mejoras en prácticamente todas las tareas.
- 120 × aceleración máxima: Algunos cuellos de botella computacionales y código ineficiente (como las multiplicaciones de matriz diagonal) se transformaron con soluciones fundamentalmente superiores.
- Funciona en todo el hardware: Códigos optimizados en las GPU NVIDIA A100 retenidas ganancias sustanciales portado a otras arquitecturas (L40, H100, RTX 3090, H20), con aceleraciones medias de 2.37 × a 3.12 ×ganancias medias consistentemente superiores a 1.1 × en todos los dispositivos.
Estudio de caso: Descubrir aceleraciones ocultas de 64 × y 120 ×
diag (a) * b – multiplicación de la matriz con diagonal
- Referencia (ineficiente):
torch.diag(A) @ BConstruye una matriz diagonal completa, que requiere o (n²m) calculador/memoria. - CUDA-L1 optimizado:
A.unsqueeze(1) * BAprovecha la transmisión, logro solo de complejidad o (nm)resultando en una aceleración de 64 ×. - Por qué: La IA razonó que asignar una diagonal completa era innecesaria; Esta idea era inalcanzable a través de la mutación de fuerza bruta, pero surgió a través de la reflexión comparativa entre las soluciones generadas.
Convolución transpositada 3D: 150 × más rápido
- Código original: Realizó una convolución completa, agrupación y activación, incluso cuando la entrada o los hiperparametros garantizaron matemáticamente todos los ceros.
- Código optimizado: Usado “cortocircuito matemático”, detectado que dio
min_value=0la salida podría establecerse inmediatamente en cero, omitiendo toda la asignación de computación y memoria. Esta información entregada órdenes de magnitud Más aceleración que las micro-optimizaciones a nivel de hardware.
Impacto comercial: por qué esto importa
Para líderes empresariales
- Ahorro de costos directos: Cada aceleración del 1% en las cargas de trabajo de GPU se traduce en 1% menos de la nube Gpuseconds, menores costos de energía y más rendimiento del modelo. Aquí, la IA entregada, en promedio, más de 200% de cómputo adicional de la misma inversión de hardware.
- Ciclos de productos más rápidos: La optimización automatizada reduce la necesidad de expertos en CUDA. Los equipos pueden desbloquear las ganancias de rendimiento en horas, no meses, y centrarse en las características y la velocidad de investigación en lugar de la sintonización de bajo nivel.
Para practicantes de IA
- Verificable, código abierto: Todos los 250 núcleos CUDA optimizados son de código abierto. Puede probar las ganancias de velocidad en A100, H100, L40 o 3090 GPU, no se requiere confianza.
- No se requiere magia negra de Cuda: El proceso no se basa en salsa secreta, compiladores patentados o ajuste humano en el circuito.
Para los investigadores de IA
- Abra de razonamiento de dominio: Contrastive-RL ofrece un nuevo enfoque para capacitar a la IA en dominios donde la corrección y el rendimiento, no solo el lenguaje natural, más
- Piratería de recompensas: Los autores se sumergen profundamente en cómo la IA descubrió hazañas sutiles y “trucos” (como la manipulación de la corriente asíncrona para aceleraciones falsas) y describir procedimientos robustos para detectar y prevenir dicho comportamiento.
Ideas técnicas: por qué gana el contrastive-RL
- La retroalimentación de rendimiento ahora está en contexto: A diferencia de Vanilla RL, la IA puede aprender no solo por prueba y error, sino por Autocrítico razonado.
- Volante de superación personal: El bucle de reflexión hace que el modelo sea robusto para recompensar los juegos y superar los enfoques evolutivos (parámetro fijo, aprendizaje contrastante en contexto) y RL tradicional (gradiente de políticas ciegas).
- Generaliza y descubre principios fundamentales: La IA puede combinar, clasificar y aplicar estrategias de optimización clave como el fusión de la memoria, la configuración del bloque de subprocesos, la fusión de la operación, la reutilización de memoria compartida, las reducciones a nivel de urdimbre y las transformaciones de equivalencia matemática.
Tabla: Técnicas superiores descubiertas por CUDA-L1
| Técnica de optimización | Aceleración típica | Ejemplo de información |
|---|---|---|
| Optimización de diseño de memoria | Boosts consistentes | Memoria/almacenamiento contiguo para eficiencia de caché |
| Acceso a la memoria (coalescing, compartido) | Moderado a alto | Evita los conflictos bancarios, maximiza el ancho de banda |
| Operación Fusión | Alto con OPS canadinados | Los núcleos múltiples fusionados reducen las lecturas/escritos de memoria |
| Cortocircuito matemático | Extremadamente alto (10-100 ×) | Detecta cuándo se puede omitir el cálculo por completo |
| Bloque de hilo/configuración paralela | Moderado | Adapta los tamaños/formas de bloque al hardware/tarea |
| Reducciones a nivel de urdimbre/ramificación | Moderado | Reduce la divergencia y la sincronización por encima |
| Optimización de la memoria de registro/compartido | Moderado | Cachés Datos frecuentes cercanos al cálculo |
| Ejecución de asíncrono, sincronización mínima | Varía | Superposición de E/S, habilita el cálculo tuberbente |
Conclusión: AI es ahora su propio ingeniero de optimización
Con CUDA-L1, AI tiene convertirse en su propio ingeniero de rendimientoacelerando la productividad de la investigación y los retornos de hardware, sin depender de una experiencia humana rara. El resultado no es solo puntos de referencia más altos, sino un plan para los sistemas de IA que Enseñarse a sí mismos cómo aprovechar todo el potencial del hardware en el que se ejecutan.
AI ahora está construyendo su propio volante: más eficiente, más perspicaz y mejor para maximizar los recursos que le damos: para la ciencia, la industria y más allá.
Mira el Papel, Codos y Página del proyecto. No dude en ver nuestro Página de Github para tutoriales, códigos y cuadernos. Además, siéntete libre de seguirnos Gorjeo Y no olvides unirte a nuestro Subreddit de 100k+ ml y suscribirse a Nuestro boletín.
Asif Razzaq es el CEO de MarktechPost Media Inc .. Como empresario e ingeniero visionario, ASIF se compromete a aprovechar el potencial de la inteligencia artificial para el bien social. Su esfuerzo más reciente es el lanzamiento de una plataforma de medios de inteligencia artificial, MarktechPost, que se destaca por su cobertura profunda de noticias de aprendizaje automático y de aprendizaje profundo que es técnicamente sólido y fácilmente comprensible por una audiencia amplia. La plataforma cuenta con más de 2 millones de vistas mensuales, ilustrando su popularidad entre el público.
