
Comenzamos este tutorial para demostrar cómo aprovechar Tpot Para automatizar y optimizar las tuberías de aprendizaje automático prácticamente. Al trabajar directamente en Google Colab, nos aseguramos de que la configuración sea liviana, reproducible y accesible. Caminamos a través de datos de carga, definiendo un anotador personalizado, adaptamos el espacio de búsqueda con modelos avanzados como XGBOost y configurando una estrategia de validación cruzada. A medida que avanzamos, exploramos cómo los algoritmos evolutivos en TPOT buscan tuberías de alto rendimiento, proporcionando transparencia de los Estados Unidos a través de frentes y puntos de control. Mira el Códigos completos aquí.
!pip -q install tpot==0.12.2 xgboost==2.0.3 scikit-learn==1.4.2 graphviz==0.20.3


import os, json, math, time, random, numpy as np, pandas as pd
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, StratifiedKFold
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import make_scorer, f1_score, classification_report, confusion_matrix
from sklearn.pipeline import Pipeline
from tpot import TPOTClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.naive_bayes import GaussianNB
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier, ExtraTreesClassifier, GradientBoostingClassifier
from xgboost import XGBClassifier


SEED = 7
random.seed(SEED); np.random.seed(SEED); os.environ["PYTHONHASHSEED"]=str(SEED)
Comenzamos instalando las bibliotecas e importando todos los módulos esenciales que admiten el manejo de datos, la construcción de modelos y la optimización de la tubería. Establecimos una semilla aleatoria fija para garantizar que nuestros resultados se sigan reproducibles cada vez que ejecutamos el cuaderno. Mira el Códigos completos aquí.
X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, stratify=y, random_state=SEED)


scaler = StandardScaler().fit(X_tr)
X_tr_s, X_te_s = scaler.transform(X_tr), scaler.transform(X_te)


def f1_cost_sensitive(y_true, y_pred):
   return f1_score(y_true, y_pred, average="binary", pos_label=1)
cost_f1 = make_scorer(f1_cost_sensitive, greater_is_better=True)
Aquí, cargamos el conjunto de datos de cáncer de mama y lo dividimos en conjuntos de capacitación y prueba mientras preservamos el balance de clase. Estandarizamos las características de estabilidad y luego definimos un anotador basado en F1 personalizado, lo que nos permite evaluar las tuberías con un enfoque en capturar efectivamente casos positivos. Mira el Códigos completos aquí.
tpot_config = {
   'sklearn.linear_model.LogisticRegression': {
       'C': [0.01, 0.1, 1.0, 10.0],
       'penalty': ['l2'], 'solver': ['lbfgs'], 'max_iter': [200]
   },
   'sklearn.naive_bayes.GaussianNB': {},
   'sklearn.tree.DecisionTreeClassifier': {
       'criterion': ['gini','entropy'], 'max_depth': [3,5,8,None],
       'min_samples_split':[2,5,10], 'min_samples_leaf':[1,2,4]
   },
   'sklearn.ensemble.RandomForestClassifier': {
       'n_estimators':[100,300], 'criterion':['gini','entropy'],
       'max_depth':[None,8], 'min_samples_split':[2,5], 'min_samples_leaf':[1,2]
   },
   'sklearn.ensemble.ExtraTreesClassifier': {
       'n_estimators':[200], 'criterion':['gini','entropy'],
       'max_depth':[None,8], 'min_samples_split':[2,5], 'min_samples_leaf':[1,2]
   },
   'sklearn.ensemble.GradientBoostingClassifier': {
       'n_estimators':[100,200], 'learning_rate':[0.03,0.1],
       'max_depth':[2,3], 'subsample':[0.8,1.0]
   },
   'xgboost.XGBClassifier': {
       'n_estimators':[200,400], 'max_depth':[3,5], 'learning_rate':[0.05,0.1],
       'subsample':[0.8,1.0], 'colsample_bytree':[0.8,1.0],
       'reg_lambda':[1.0,2.0], 'min_child_weight':[1,3],
       'n_jobs':[0], 'tree_method':['hist'], 'eval_metric':['logloss'],
       'gamma':[0,1]
   }
}


cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEED)
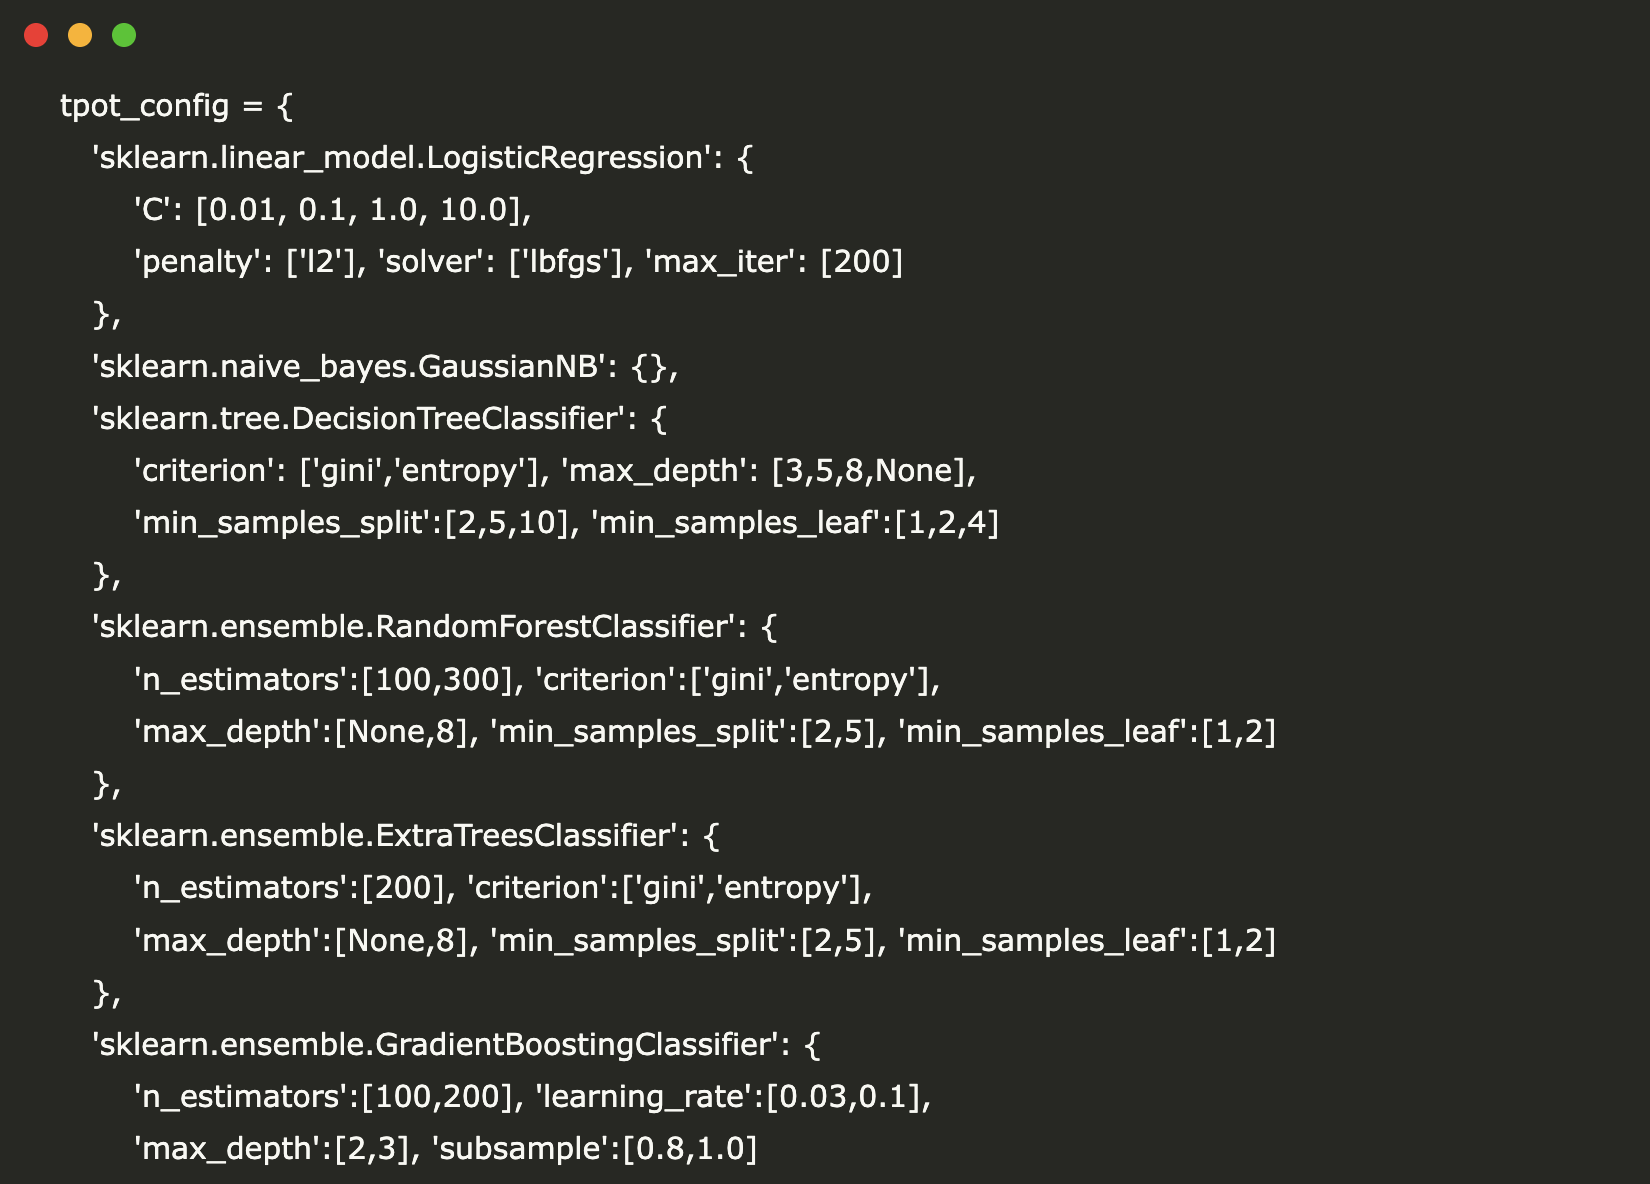
Definimos una configuración TPOT personalizada que combina modelos lineales, estudiantes basados en árboles, conjuntos y xgboost, utilizando hiperparámetros cuidadosamente elegidos. También establecimos una estrategia estratificada de validación cruzada de 5 veces, asegurando que cada tubería candidata se pruebe de manera justa a través de divisiones equilibradas del conjunto de datos. Mira el Códigos completos aquí.
t0 = time.time()
tpot = TPOTClassifier(
   generations=5,
   population_size=40,
   offspring_size=40,
   scoring=cost_f1,
   cv=cv,
   subsample=0.8,
   n_jobs=-1,
   config_dict=tpot_config,
   verbosity=2,
   random_state=SEED,
   max_time_mins=10,
   early_stop=3,
   periodic_checkpoint_folder="tpot_ckpt",
   warm_start=False
)
tpot.fit(X_tr_s, y_tr)
print(f"\n⏱️ First search took {time.time()-t0:.1f}s")


def pareto_table(tpot_obj, k=5):
   rows=[]
   for ind, meta in tpot_obj.pareto_front_fitted_pipelines_.items():
       rows.append({
           "pipeline": ind, "cv_score": meta['internal_cv_score'],
           "size": len(str(meta['pipeline'])),
       })
   df = pd.DataFrame(rows).sort_values("cv_score", ascending=False).head(k)
   return df.reset_index(drop=True)


pareto_df = pareto_table(tpot, k=5)
print("\nTop Pareto pipelines (cv):\n", pareto_df)


def eval_pipeline(pipeline, X_te, y_te, name):
   y_hat = pipeline.predict(X_te)
   f1 = f1_score(y_te, y_hat)
   print(f"\n[{name}] F1(test) = {f1:.4f}")
   print(classification_report(y_te, y_hat, digits=3))


print("\nEvaluating top pipelines on test:")
for i, (ind, meta) in enumerate(sorted(
       tpot.pareto_front_fitted_pipelines_.items(),
       key=lambda kv: kv[1]['internal_cv_score'], reverse=True)[:3], 1):
   eval_pipeline(meta['pipeline'], X_te_s, y_te, name=f"Pareto#{i}")
Lanzamos una búsqueda evolutiva con TPOT, el tiempo de ejecución de la practicidad y el progreso del punto de control, lo que nos permite buscar reproduciblemente tuberías fuertes. Luego inspeccionamos el frente de Pareto para identificar las principales compensaciones, convertirlo en una tabla compacta y seleccionar líderes basados en el puntaje de validación cruzada. Finalmente, evaluamos los mejores candidatos en la prueba de retención establecida para confirmar el rendimiento del mundo real con F1 y un informe de clasificación completa. Mira el Códigos completos aquí.
print("\n🔁 Warm-start for extra refinement...")
t1 = time.time()
tpot2 = TPOTClassifier(
   generations=3, population_size=40, offspring_size=40,
   scoring=cost_f1, cv=cv, subsample=0.8, n_jobs=-1,
   config_dict=tpot_config, verbosity=2, random_state=SEED,
   warm_start=True, periodic_checkpoint_folder="tpot_ckpt"
)
try:
   tpot2._population = tpot._population
   tpot2._pareto_front = tpot._pareto_front
except Exception:
   pass
tpot2.fit(X_tr_s, y_tr)
print(f"⏱️ Warm-start extra search took {time.time()-t1:.1f}s")


best_model = tpot2.fitted_pipeline_ if hasattr(tpot2, "fitted_pipeline_") else tpot.fitted_pipeline_
eval_pipeline(best_model, X_te_s, y_te, name="BestAfterWarmStart")


export_path = "tpot_best_pipeline.py"
(tpot2 if hasattr(tpot2, "fitted_pipeline_") else tpot).export(export_path)
print(f"\n📦 Exported best pipeline to: {export_path}")


from importlib import util as _util
spec = _util.spec_from_file_location("tpot_best", export_path)
tbest = _util.module_from_spec(spec); spec.loader.exec_module(tbest)
reloaded_clf = tbest.exported_pipeline_
pipe = Pipeline([("scaler", scaler), ("model", reloaded_clf)])
pipe.fit(X_tr, y_tr)
eval_pipeline(pipe, X_te, y_te, name="ReloadedExportedPipeline")


report = {
   "dataset": "sklearn breast_cancer",
   "train_size": int(X_tr.shape[0]), "test_size": int(X_te.shape[0]),
   "cv": "StratifiedKFold(5)",
   "scorer": "custom F1 (binary)",
   "search": {"gen_1": 5, "gen_2_warm": 3, "pop": 40, "subsample": 0.8},
   "exported_pipeline_first_120_chars": str(reloaded_clf)[:120]+"...",
}
print("\n🧾 Model Card:\n", json.dumps(report, indent=2))
Continuamos la búsqueda con un comienzo cálido, reutilizando el comienzo cálido aprendido para refinar a los candidatos y seleccionamos el mejor desempeño en nuestro conjunto de pruebas. Exportamos la tubería ganadora, la recargamos junto con nuestro escalador para imitar la implementación y verificamos sus resultados. Finalmente, generamos una tarjeta modelo compacta para documentar el conjunto de datos, la configuración de búsqueda y el resumen de la tubería exportada para la reproducibilidad.
En conclusión, vemos cómo TPOT nos permite ir más allá de la selección del modelo de prueba y error y, en su lugar, confiar en la optimización automatizada, reproducible y explicable. Exportamos la mejor tubería, la validamos en datos invisibles e incluso la recargamos para su uso de estilo de implementación, lo que confirma que el flujo de trabajo no solo es experimental sino listo para la producción. Al combinar la reproducibilidad, la flexibilidad e interpretabilidad, terminamos con un marco robusto que podemos aplicar con confianza a conjuntos de datos más complejos y problemas del mundo real.
Mira el Códigos completos aquí. No dude en ver nuestro Página de Github para tutoriales, códigos y cuadernos. Además, siéntete libre de seguirnos Gorjeo Y no olvides unirte a nuestro Subreddit de 100k+ ml y suscribirse a Nuestro boletín.
Asif Razzaq es el CEO de MarktechPost Media Inc .. Como empresario e ingeniero visionario, ASIF se compromete a aprovechar el potencial de la inteligencia artificial para el bien social. Su esfuerzo más reciente es el lanzamiento de una plataforma de medios de inteligencia artificial, MarktechPost, que se destaca por su cobertura profunda de noticias de aprendizaje automático y de aprendizaje profundo que es técnicamente sólido y fácilmente comprensible por una audiencia amplia. La plataforma cuenta con más de 2 millones de vistas mensuales, ilustrando su popularidad entre el público.