
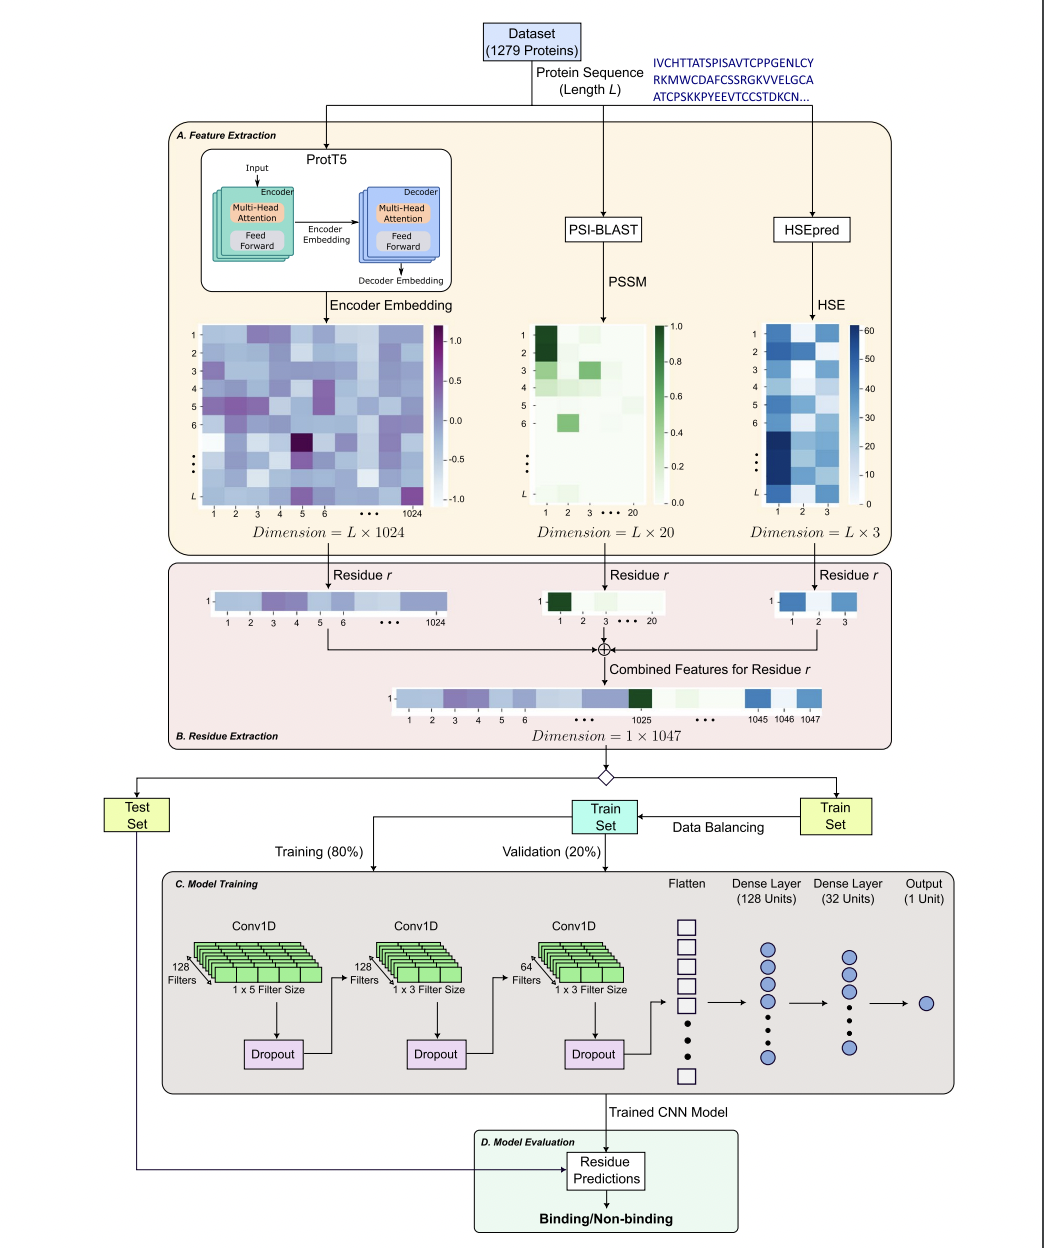
PepCNN, un modelo de aprendizaje profundo desarrollado por investigadores de la Universidad Griffith, el Centro RIKEN de Ciencias Médicas Integrativas, la Universidad Rutgers y la Universidad de Tokio, aborda el problema de predecir los residuos de unión de proteínas y péptidos. PepCNN supera a otros métodos en términos de especificidad, precisión y métricas de AUC al combinar información estructural y basada en secuencias, lo que lo convierte en una herramienta valiosa para comprender las interacciones proteína-péptido y avanzar en los esfuerzos de descubrimiento de fármacos.
Comprender las interacciones proteína-péptido es crucial para los procesos celulares y los mecanismos de enfermedades como el cáncer, lo que requiere métodos computacionales ya que los enfoques experimentales requieren muchos recursos. Los modelos computacionales, categorizados en basados en estructuras y basados en secuencias, ofrecen alternativas. Al utilizar características de modelos de lenguaje de proteínas previamente entrenados y datos de exposición, PepCNN supera a los métodos anteriores, enfatizando la importancia de su conjunto de características para mejorar la precisión de la predicción en las interacciones proteína-péptido.
Existe la necesidad de enfoques computacionales para obtener una comprensión más profunda de las interacciones proteína-péptido y su papel en los procesos celulares y los mecanismos de las enfermedades. Si bien se han desarrollado modelos basados en estructuras y secuencias, la precisión sigue siendo un desafío debido a la complejidad de las interacciones. Se ha propuesto PepCNN, un novedoso modelo de aprendizaje profundo, para resolver este desafío integrando información estructural y basada en secuencias para predecir los residuos de unión de péptidos. Con un rendimiento superior en comparación con los métodos existentes, PepCNN es una herramienta prometedora para respaldar los esfuerzos de descubrimiento de fármacos y avanzar en la comprensión de las interacciones proteína-péptido.
PepCNN utiliza técnicas innovadoras como exposición de media esfera, matrices de puntuación de posición específica e incorporación de un modelo de lenguaje de proteínas previamente entrenado para lograr resultados superiores en comparación con nueve métodos existentes, incluido PepBCL. Destaca su impresionante especificidad y precisión, y su rendimiento supera a otros métodos de última generación. Estos avances resaltan la eficacia del método propuesto.
El modelo de predicción de aprendizaje profundo, PepCNN, superó a varios métodos, incluido PepBCL, con mayor especificidad, precisión y AUC. Después de ser evaluado en dos conjuntos de prueba, PepCNN mostró mejoras notables, particularmente en AUC. Los resultados mostraron que la sensibilidad fue de 0,254, la especificidad fue de 0,988, la precisión fue de 0,55, el MCC fue de 0,350 y el AUC fue de 0,843 en el primer conjunto de pruebas. Las investigaciones futuras tienen como objetivo integrar la tecnología DeepInsight para facilitar la aplicación de arquitecturas CNN 2D y transferir técnicas de aprendizaje para futuros avances.
En conclusión, el modelo avanzado de predicción de aprendizaje profundo, PepCNN, que incorpora información estructural y basada en secuencias de secuencias de proteínas primarias, supera a los métodos existentes en especificidad, precisión y AUC, como se demuestra en las pruebas realizadas en los conjuntos de datos TE125 y TE639. Otras investigaciones tienen como objetivo mejorar su rendimiento mediante la integración de la tecnología DeepInsight, lo que permite la aplicación de arquitecturas CNN 2D y técnicas de transferencia de aprendizaje.
Revisar la Papel y GitHub. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 33k+ ML, 41k+ comunidad de Facebook, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
A Sana Hassan, pasante de consultoría en Marktechpost y estudiante de doble titulación en IIT Madras, le apasiona aplicar la tecnología y la inteligencia artificial para abordar los desafíos del mundo real. Con un gran interés en resolver problemas prácticos, aporta una nueva perspectiva a la intersección de la IA y las soluciones de la vida real.