
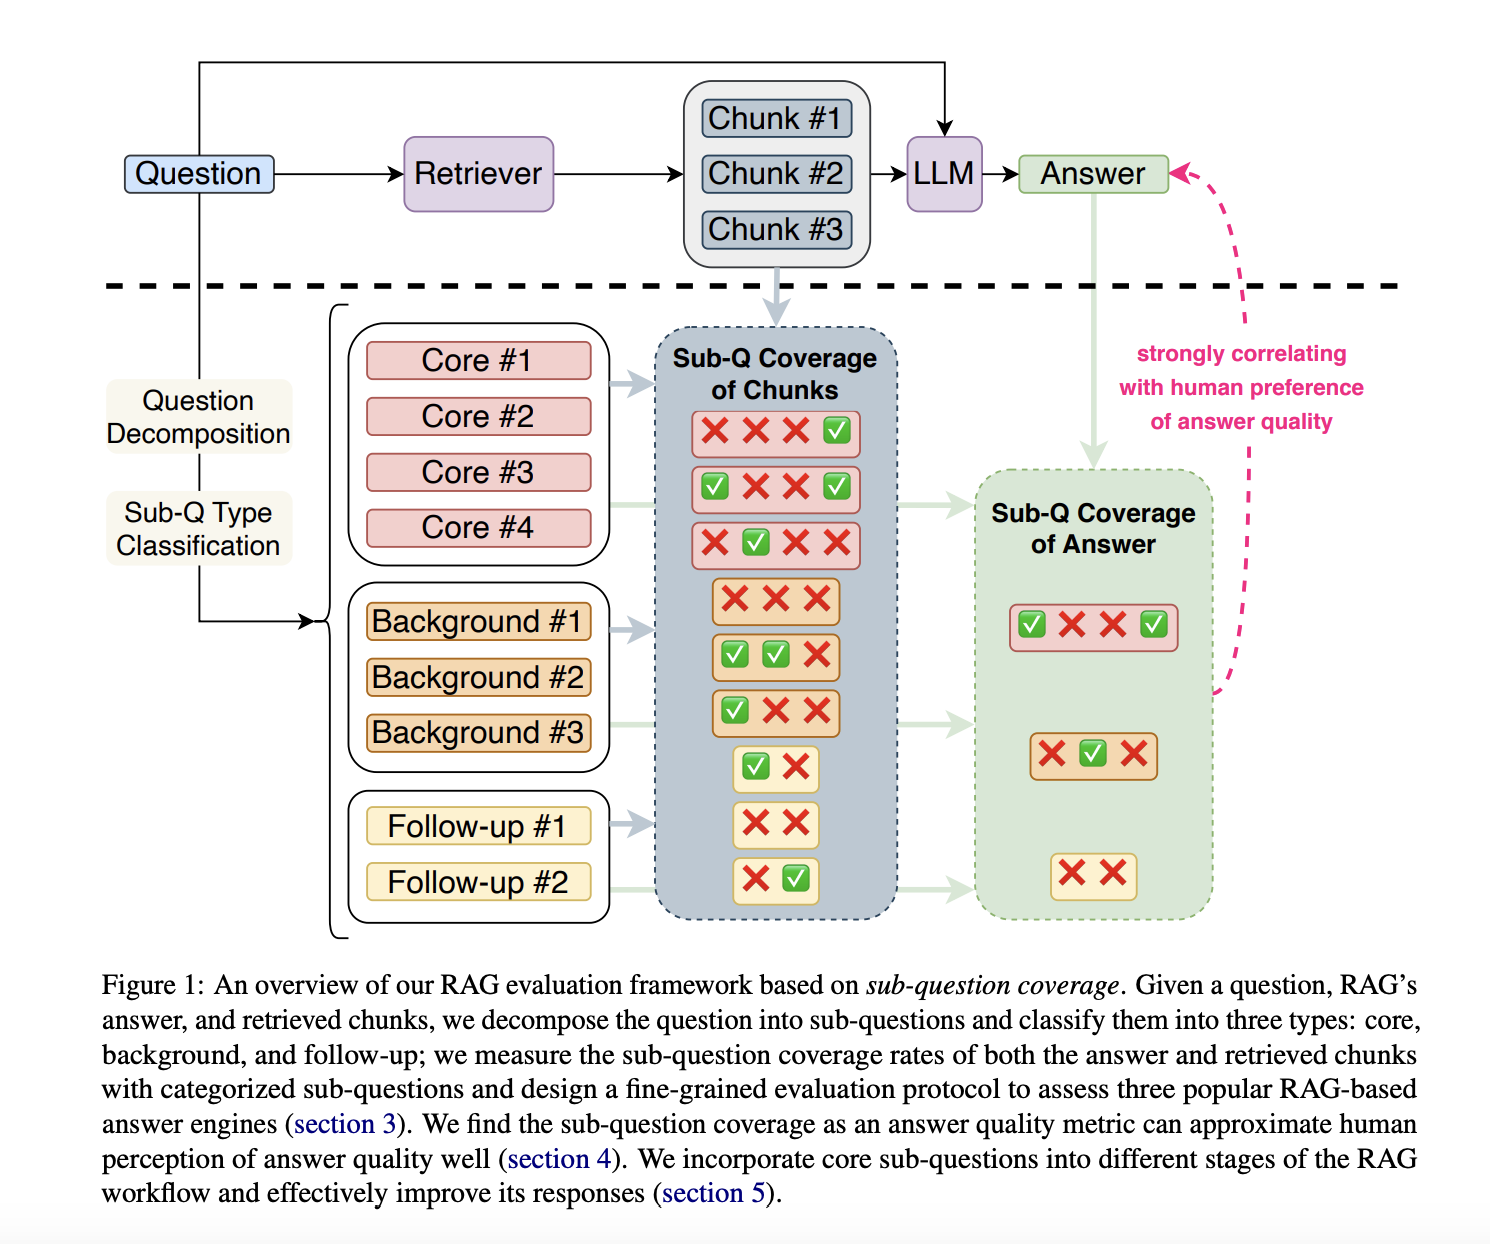
Los sistemas de recuperación-generación aumentada (RAG) combinan procesos de recuperación y generación para abordar las complejidades de responder preguntas abiertas y multidimensionales. Al acceder a documentos y conocimientos relevantes, los modelos basados en RAG generan respuestas con contexto adicional, ofreciendo conocimientos más ricos que los modelos únicamente generativos. Este enfoque es útil en campos donde las respuestas deben reflejar una amplia base de conocimientos, como la investigación jurídica y el análisis académico. Los sistemas RAG recuperan datos específicos y los reúnen en respuestas integrales, lo cual es particularmente ventajoso en situaciones que requieren perspectivas diversas o un contexto profundo.
La evaluación de la eficacia de los sistemas RAG presenta desafíos únicos, ya que a menudo necesitan responder preguntas no factuales que requieren más de una respuesta definitiva. Las métricas de evaluación tradicionales, como la relevancia y la fidelidad, deben capturar completamente qué tan bien estos sistemas cubren los subtemas complejos y de múltiples capas de estas preguntas. En aplicaciones del mundo real, las preguntas a menudo comprenden consultas básicas respaldadas por elementos contextuales o exploratorios adicionales, formando una respuesta más holística. Las herramientas y modelos existentes se centran principalmente en medidas superficiales, lo que deja una brecha en la comprensión de la integridad de las respuestas del RAG.
La mayoría de los sistemas RAG actuales operan con indicadores generales de calidad que solo abordan parcialmente las necesidades de los usuarios de una cobertura integral. Las herramientas y los marcos a menudo incorporan pistas de subpreguntas, pero necesitan ayuda para descomponer completamente una pregunta en subtemas detallados, lo que afecta la satisfacción del usuario. Las consultas complejas pueden requerir respuestas que abarquen no sólo respuestas directas sino también antecedentes y detalles de seguimiento para lograr claridad. Al necesitar una evaluación de cobertura detallada, estos sistemas frecuentemente pasan por alto o integran de manera inadecuada información esencial en sus respuestas generadas.
Los investigadores del Instituto de Tecnología de Georgia y Salesforce AI Research presentan un nuevo marco para evaluar los sistemas RAG basado en una métrica llamada “cobertura de subpreguntas”. En lugar de puntuaciones de relevancia general, los investigadores proponen descomponer una pregunta en subpreguntas específicas, categorizadas como centrales, de antecedentes o de seguimiento. Este enfoque permite una evaluación matizada de la calidad de la respuesta al examinar qué tan bien se aborda cada subpregunta. El equipo aplicó su marco a tres sistemas RAG ampliamente utilizados, You.com, Perplexity AI y Bing Chat, revelando patrones distintos en el manejo de varios tipos de subpreguntas. Los investigadores pudieron identificar brechas en las que cada sistema no logró brindar respuestas integrales midiendo la cobertura en estas categorías.
Al desarrollar el marco, los investigadores emplearon un método de dos pasos de la siguiente manera:
- Primero, dividieron las preguntas complejas en subpreguntas con roles categorizados como centrales (esenciales para la pregunta principal), antecedentes (que brindan el contexto necesario) o seguimiento (no esenciales pero valiosos para obtener más información).
- A continuación, probaron qué tan bien los sistemas RAG recuperaban contenido relevante para cada categoría y con qué eficacia se incorporaba en las respuestas finales. Por ejemplo, las capacidades de recuperación de cada sistema se examinaron en términos de subpreguntas centrales, donde una cobertura adecuada a menudo predice el éxito general de la respuesta.
Las métricas desarrolladas a través de este proceso ofrecen información precisa sobre las fortalezas y limitaciones de los sistemas RAG, lo que permite realizar mejoras específicas.
Los resultados revelaron tendencias significativas entre los sistemas, destacando tanto las fortalezas como las limitaciones de sus capacidades. Aunque cada sistema de GAR priorizó subpreguntas centrales, ninguno logró una cobertura completa y persistieron lagunas incluso en áreas críticas. En You.com, la cobertura de las subpreguntas principales fue del 42 %, mientras que Perplexity AI tuvo un mejor desempeño, alcanzando una cobertura del 54 %. Bing Chat mostró una tasa ligeramente inferior, del 49%, aunque destacó en la organización de la información de forma coherente. Sin embargo, la cobertura de las subpreguntas de antecedentes fue notablemente baja en todos los sistemas, 20 % para You.com y Perplexity AI y solo 14 % para Bing Chat. Esta disparidad revela que, si bien se prioriza el contenido principal, los sistemas a menudo necesitan prestar más atención a la información complementaria, lo que afecta la calidad de la respuesta percibida por los usuarios. Además, los investigadores notaron que Perplexity AI se destacó en conectar las etapas de recuperación y generación, logrando un 71% de precisión en la alineación de las subpreguntas principales, mientras que You.com se quedó atrás con un 51%.
Este estudio destaca que la evaluación de los sistemas RAG requiere un cambio de los métodos convencionales a métricas orientadas a subpreguntas que evalúen la precisión de la recuperación y la calidad de la respuesta. Al integrar la clasificación de subpreguntas en los procesos del RAG, el marco ayuda a cerrar las brechas en los sistemas existentes, mejorando su capacidad para producir respuestas integrales. Los resultados muestran que aprovechar las subpreguntas principales en la recuperación puede elevar sustancialmente la calidad de la respuesta; Perplexity AI demuestra una tasa de éxito del 74 % sobre una base de referencia que excluía las subpreguntas. Es importante destacar que el estudio identificó áreas de mejora, como la necesidad de Bing Chat de aumentar la coherencia de la alineación de la información central con la de fondo.

Las conclusiones clave de esta investigación subrayan la importancia de la clasificación de subpreguntas para mejorar el rendimiento de RAG:
- Cobertura de las subpreguntas principales: En promedio, los sistemas RAG omitieron alrededor del 50% de las subpreguntas principales, lo que indica un área clara de mejora.
- Precisión del sistema: Perplexity AI lideró con una precisión del 71 % al conectar el contenido recuperado con las respuestas, en comparación con el 51 % de You.com y el 63 % de Bing Chat.
- Importancia de la información previa: La cobertura de las subpreguntas de antecedentes fue menor en todos los sistemas, oscilando entre el 14% y el 20%, lo que sugiere una brecha en el apoyo contextual a las respuestas.
- Clasificaciones de rendimiento: Perplexity AI ocupó el puesto más alto en general, con Bing Chat sobresaliendo en la estructuración de respuestas y You.com mostrando limitaciones notables.
- Potencial de mejora: Todos los sistemas RAG mostraron un margen sustancial para mejorar la recuperación de subpreguntas principales, con ganancias proyectadas en la calidad de las respuestas de hasta el 45%.

En conclusión, esta investigación redefine cómo se evalúan los sistemas RAG, enfatizando la cobertura de subpreguntas como una métrica principal de éxito. Al analizar tipos específicos de subpreguntas dentro de las respuestas, el estudio arroja luz sobre las limitaciones de los marcos RAG actuales y ofrece un camino para mejorar la calidad de las respuestas. Los hallazgos resaltan la necesidad de un aumento de recuperación enfocado y señalan pasos prácticos que podrían hacer que los sistemas RAG sean más robustos para tareas complejas que requieren mucho conocimiento. La investigación sienta las bases para futuras mejoras en la tecnología de generación de respuestas a través de este enfoque de evaluación matizado.
Mira el Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de telegramas y LinkedIn Grarriba. Si te gusta nuestro trabajo, te encantará nuestro hoja informativa.. No olvides unirte a nuestro SubReddit de más de 55.000 ml.
[Upcoming Live Webinar- Oct 29, 2024] La mejor plataforma para ofrecer modelos optimizados: motor de inferencia Predibase (promocionado)
Asif Razzaq es el director ejecutivo de Marktechpost Media Inc.. Como emprendedor e ingeniero visionario, Asif está comprometido a aprovechar el potencial de la inteligencia artificial para el bien social. Su esfuerzo más reciente es el lanzamiento de una plataforma de medios de inteligencia artificial, Marktechpost, que se destaca por su cobertura en profundidad del aprendizaje automático y las noticias sobre aprendizaje profundo que es técnicamente sólida y fácilmente comprensible para una amplia audiencia. La plataforma cuenta con más de 2 millones de visitas mensuales, lo que ilustra su popularidad entre el público.