
La integración de la comprensión del lenguaje natural con la percepción de imágenes ha llevado al desarrollo de modelos de lenguaje de visión grande (LVLM), que muestran capacidades de razonamiento notables. A pesar de su progreso, los LVLM a menudo encuentran desafíos a la hora de anclar con precisión el texto generado a las entradas visuales, lo que se manifiesta como imprecisiones como alucinaciones de elementos de escena inexistentes o interpretaciones erróneas de los atributos y relaciones de los objetos.
Investigadores de la Universidad de Texas en Austin y AWS AI proponen el marco innovador ViGoR (Visual Grounding Through Fine-Grained Reward Modeling) como solución. ViGoR avanza la base visual de los LVLM más allá de las líneas de base tradicionales a través de modelos de recompensa detallados, involucrando tanto evaluaciones humanas como métodos automatizados para la mejora. Este enfoque es notablemente eficiente y aclara los elevados costos de la supervisión integral que normalmente se requiere en tales avances.
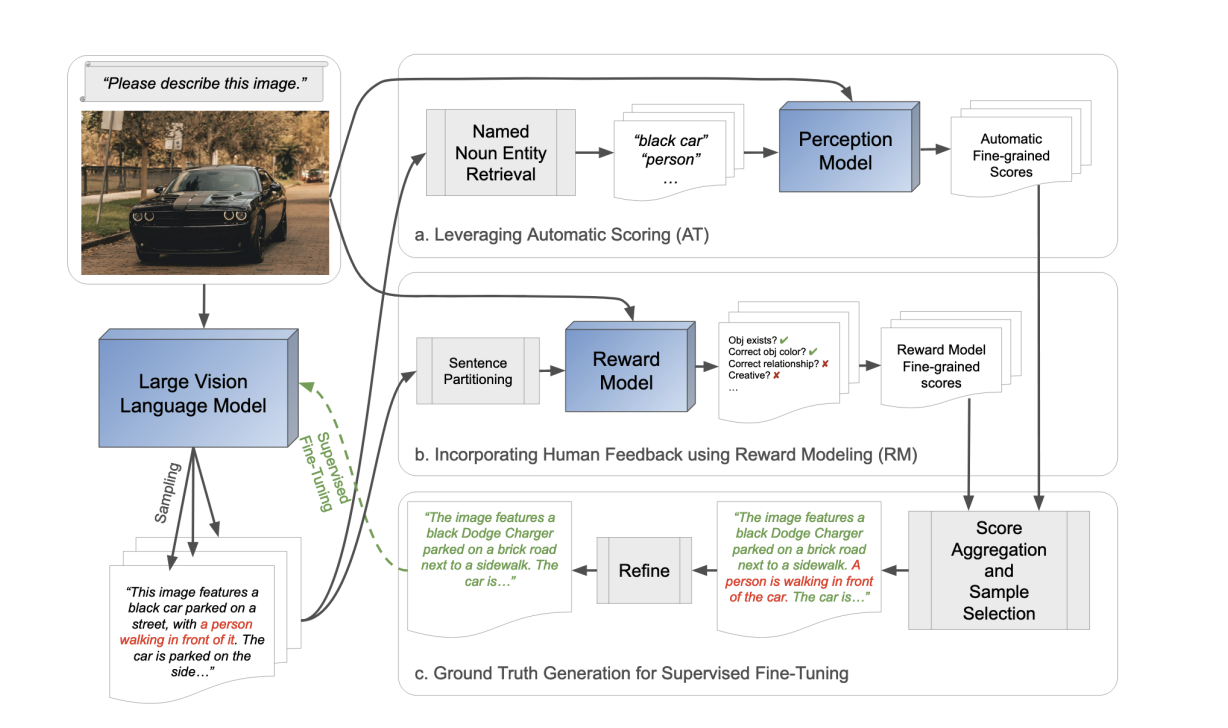
La metodología de ViGoR es particularmente notable por su ajuste estratégico de LVLM previamente capacitados, como LLaVA. Al introducir una serie de imágenes acompañadas de indicaciones en el LVLM, genera múltiples resultados textuales para cada una. Luego, los anotadores humanos evalúan estos pares de imagen y texto, asignando puntuaciones detalladas a nivel de oración en función de la calidad del texto. Este proceso cultiva un conjunto de datos que abarca las tríadas imagen-texto-evaluación. Posteriormente, un modelo de recompensa entrenado en este conjunto de datos refina el LVLM, reforzando significativamente sus capacidades de conexión visual con un conjunto de datos relativamente modesto de 16.000 muestras.
ViGoR integra un ingenioso método automatizado para construir el modelo de recompensa sin trabajo humano adicional, mejorando aún más la eficacia visual de los LVLM. La sinergia entre los modelos de recompensa automatizados y evaluados por humanos sustenta la solución integral de ViGoR, mejorando notablemente el rendimiento de LVLM al basar con precisión el texto en estímulos visuales.
La eficacia de ViGoR queda subrayada por su rendimiento superior sobre los modelos de referencia existentes en varios puntos de referencia. Un conjunto de datos desafiante y especialmente seleccionado diseñado para probar las capacidades de conexión visual de los LVLM validó aún más el éxito del marco. Para respaldar la investigación continua, el equipo planea publicar su conjunto de datos de anotaciones humanas, que comprende alrededor de 16.000 imágenes y pares de texto generados con evaluaciones matizadas.

ViGoR destaca por varias razones:
- Introduce un marco de amplia aplicación que utiliza modelos de recompensa detallados para mejorar sustancialmente la base visual de los LVLM.
- El desarrollo de modelos de recompensa que requieren un esfuerzo humano mínimo muestra mejoras significativas en la eficiencia de la conexión visual a tierra.
- Se construye un conjunto de datos completo y desafiante, MMViG, específicamente para evaluar las capacidades visuales de conexión a tierra de los LVLM.
- Se publicará un conjunto de datos de evaluación humana con imágenes de 16K y pares de texto generados con evaluaciones detalladas, lo que enriquecerá los recursos para esfuerzos de investigación relacionados.
En conclusión, ViGoR presenta un avance significativo en la mejora de la precisión visual de la conexión a tierra de los LVLM y conserva las capacidades inherentes de razonamiento creativo e intuitivo de los modelos previamente entrenados. Este desarrollo presagia una interpretación y generación de texto sobre imágenes más confiable, acercándose a modelos que comprenden y describen contenido visual con alta fidelidad y detalle.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y noticias de Google. Unirse nuestro SubReddit de 37k+ ML, 41k+ comunidad de Facebook, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Canal de telegramas

Hola, mi nombre es Adnan Hassan. Soy pasante de consultoría en Marktechpost y pronto seré aprendiz de gestión en American Express. Actualmente estoy cursando una doble titulación en el Instituto Indio de Tecnología, Kharagpur. Me apasiona la tecnología y quiero crear nuevos productos que marquen la diferencia.